

Python字符串编码转换指南:encode与decode方法使用详解
深入解析Python 3中字符串编码转换的核心机制,详细讲解str.encode()与bytes.decode()方法的参数配置、errors容错策略、跨编码转换标准步骤及Unicode三明治架构实践。
encode() 转换为字节串,或将字节串使用 decode() 还原为字符对象。掌握这两个方法的参数配置、容错策略及标准转换链路,是彻底规避乱码与异常的关键。
一、Python 3 字符与字节:理解编码转换的根基
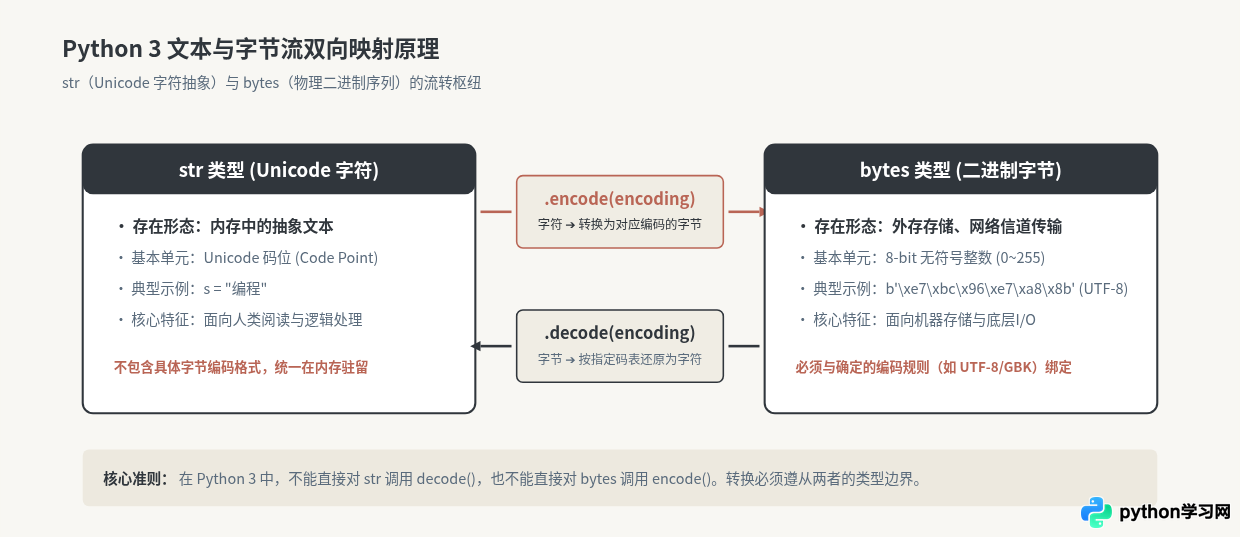
在深入具体方法前,必须厘清 Python 3 的类型系统。Python 3 彻底重构了字符串体系,消除了 Python 2 中 str 与 unicode 混淆带来的隐患。在现代 Python 中:
- str(文本字符串):表示抽象的 Unicode 字符序列。在内存中,它不绑定任何具体的存储格式(如 UTF-8 或 GBK),每个字符对应一个唯一的 Unicode 码位(Code Point)。
- bytes(二进制字节串):表示连续的 8 位二进制序列(0~255)。这是文件保存、网络传输以及与操作系统底层交互时真实存在的形态。
计算机硬件和通信信道只能存储和传输 0 与 1 构成的字节流。当需要把内存中的字符写出到外部介质时,必须指定一套规则把字符映射为字节,这个过程叫编码(Encoding);反之,从文件或网络读取字节流还原为文字的过程叫解码(Decoding)。
二、encode() 方法详解:将文本字符串转换为字节序列
encode() 是 str 对象的内置方法,用于将当前字符串对象按照指定的编码标准转换为对应的二进制 bytes 对象。
1. 方法签名与默认行为
str.encode(encoding='utf-8', errors='strict')该方法接收两个核心参数:
encoding:目标编码方案的名称,默认为'utf-8'。常见编码还包括'gbk'、'gb18030'、'ascii'、'latin-1'等。errors:指定当字符无法在目标编码表中找到对应项时的异常处理模式,默认为'strict'(严格模式,抛出UnicodeEncodeError)。
2. 常见编码基础示例
下面演示将同一个中文短语编码为不同字节序列的过程:
text = "Python编码"

# 1. 默认使用 UTF-8 编码(每个常见中文占用 3 字节)
bytes_utf8 = text.encode("utf-8")
print(bytes_utf8)
# 输出: b'Python\xe7\xbc\x96\xe7\xa0\x81'

# 2. 转换为 GBK 编码(每个中文占用 2 字节)
bytes_gbk = text.encode("gbk")
print(bytes_gbk)
# 输出: b'Python\xb1\xe0\xc2\xeb'

# 3. 尝试转换为 ASCII 编码(中文无法被 ASCII 覆盖)
# text.encode("ascii")  # 会直接触发 UnicodeEncodeError: 'ascii' codec can't encode characters
3. errors 参数的可选处理策略
当目标编码无法表达源字符串中的某些字符时,可以通过 errors 参数控制程序行为:
| 模式名称 | 行为机制 | 示例输出("ABC你好".encode("ascii", ...)) |
|---|---|---|
'strict' |
遇到非法字符立即抛出 UnicodeEncodeError(默认配置) |
抛出异常,中断程序执行 |
'ignore' |
静默跳过无法编码的字符,仅保留可编码部分 | b'ABC'(中文被丢弃) |
'replace' |
用目标编码下的问号 ?(0x3F)替换无法编码的字符 |
b'ABC??' |
'backslashreplace' |
用 Python 的 \uXXXX 反斜杠转义序列替代无法编码的字符 |
b'ABC\\u4f60\\u597d' |
'xmlcharrefreplace' |
用 XML 数值字符引用(&#XXXX;)替代,适合生成 HTML/XML 文档 |
b'ABC你好' |
sample_str = "Python-核心"

# 严格模式:明确捕获异常
try:
    sample_str.encode("ascii", errors="strict")
except UnicodeEncodeError as e:
    print(f"编码失败: {e.reason}, 位置: {e.start}-{e.end}")

# 替换模式:确保数据流不中断
safe_bytes = sample_str.encode("ascii", errors="replace")
print("replace 结果:", safe_bytes)  # b'Python-??'

# 转义模式:保留原始信息以便后续排查
escaped_bytes = sample_str.encode("ascii", errors="backslashreplace")
print("backslashreplace 结果:", escaped_bytes)  # b'Python-\\u6838\\u5fc3'
三、decode() 方法详解:将字节流还原为文本字符串
decode() 是 bytes 对象的内置方法,用于根据指定的字符编码表将字节序列还原为 Python 的 str 文本对象。
1. 方法签名与核心要求
bytes.decode(encoding='utf-8', errors='strict')
参数含义与 encode() 对称。需要特别强调的是:解码时指定的 encoding 必须与原始生成该字节串时的编码格式完全一致,否则会导致乱码甚至解码异常。
2. 解码操作与编码错配示例
# 构造一段 UTF-8 字节流
raw_utf8 = "技术指南".encode("utf-8")

# 正确解码:指定与生成一致的 utf-8
clean_text = raw_utf8.decode("utf-8")
print("正常还原:", clean_text)  # "技术指南"

# 错误示例:用 gbk 去解码 utf-8 字节流
try:
    wrong_text = raw_utf8.decode("gbk")
    print("错误解码结果:", wrong_text)
except UnicodeDecodeError as e:
    print(f"解码触发异常: {e.reason}")
    # 输出: 解码触发异常: illegal multibyte sequence
3. decode 中的 errors 参数应用
在网络抓包、爬虫采集或读取老旧日志文件时,外部数据流中可能夹杂残损字节或格式混合的脏数据。合理设置 errors 参数可以防止程序崩溃并有效清洗数据:
# 模拟一段带有破损字节的序列(0xff 不是合法的 UTF-8 起始字节)
damaged_bytes = b"Hello \xff\xfe Python"

# 1. 严格模式(默认)
# damaged_bytes.decode("utf-8") -> 触发 UnicodeDecodeError

# 2. 忽略模式:清洗掉非法字节
clean_str = damaged_bytes.decode("utf-8", errors="ignore")
print("ignore 清洗后:", clean_str)  # "Hello  Python"

# 3. 替换模式:使用标准 Unicode 替换字符 U+FFFD () 标识破损位置
replaced_str = damaged_bytes.decode("utf-8", errors="replace")
print("replace 标识后:", replaced_str)  # "Hello  Python"
四、不同编码间的转换实战:标准四步法
在实际业务开发中,我们经常遇到需要将文件或接口的数据从一种编码转换为另一种编码(例如旧系统的 GBK 转为标准 UTF-8)。在 Python 3 中,不存在直接将一种 bytes 转换为另一种 bytes 的单一函数,必须以 str(Unicode 抽象)作为中介。
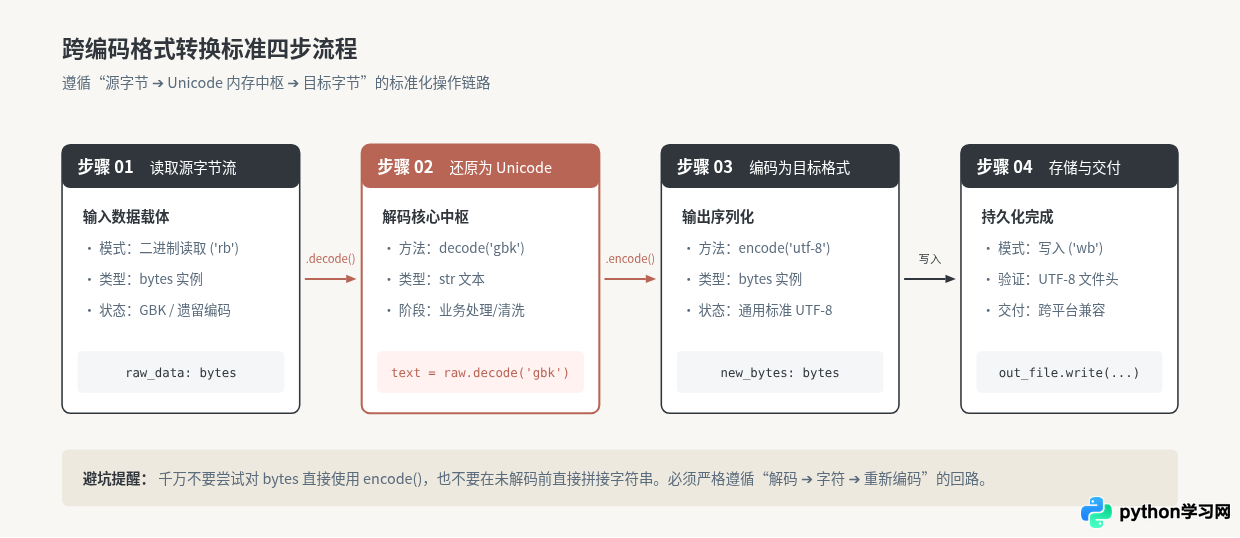
实战代码:GBK 转 UTF-8 文件清洗
def convert_encoding(source_path: str, target_path: str, from_enc="gbk", to_enc="utf-8"):
    """
    通用文件编码格式转换器
    """
    # 步骤 1:以二进制模式读取原始字节
    with open(source_path, "rb") as f_in:
        raw_bytes = f_in.read()

    # 步骤 2:使用源编码解码为内存中的 Unicode 字符串
    # 建议使用 errors='replace' 防止历史遗留损坏字符导致任务中断
    text_content = raw_bytes.decode(from_enc, errors="replace")

    # 可选处理:在纯文本状态下进行数据处理或校验
    processed_content = text_content.strip()

    # 步骤 3:将字符串按新格式编码为目标字节
    target_bytes = processed_content.encode(to_enc)

    # 步骤 4:以二进制模式写入新目标文件
    with open(target_path, "wb") as f_out:
        f_out.write(target_bytes)

    print(f"转换完成: {source_path} ({from_enc}) -> {target_path} ({to_enc})")
五、常见报错排查与 errors 决策树
在进行字符串编码与解码开发时,开发者最常面对两个异常:UnicodeDecodeError 与 UnicodeEncodeError。清楚异常成因并选择合适的排查路径至关重要。
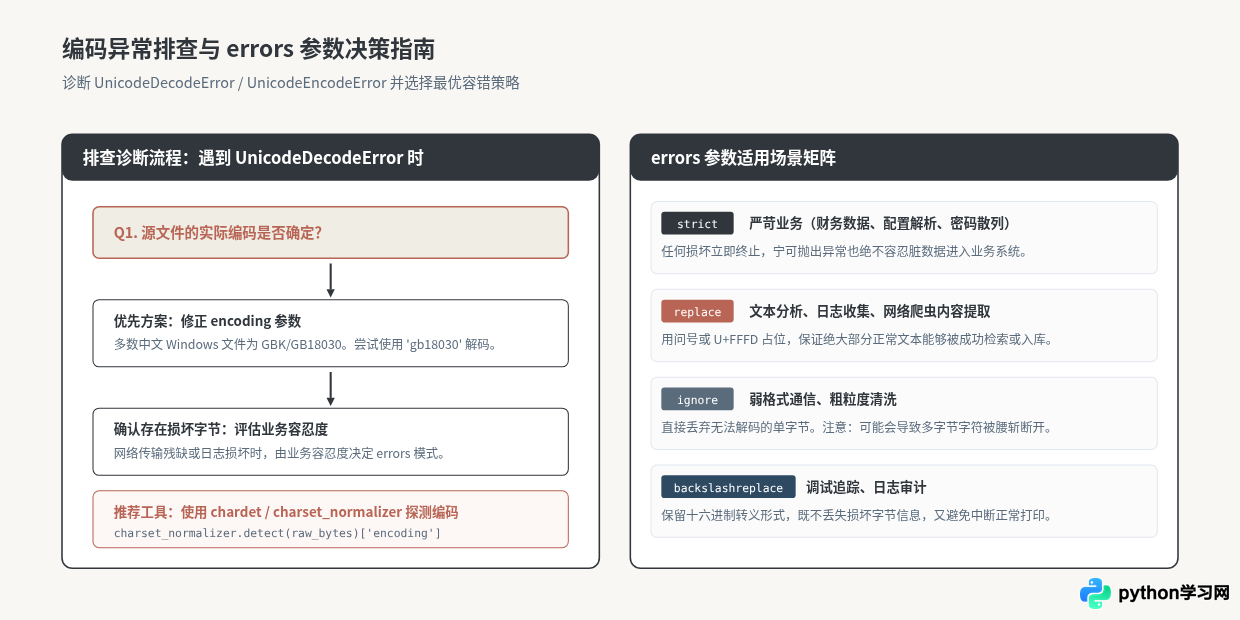
'gbk' 解码中文文件依然报错,原因在于遇到生僻字或特定符号。GB18030 是国家强制标准且向下兼容 GBK 和 GB2312,字符集收录更为完备。在处理中文遗留数据时,若 'gbk' 报错,建议优先尝试 encoding='gb18030'。
六、工程最佳实践:Unicode 三明治架构
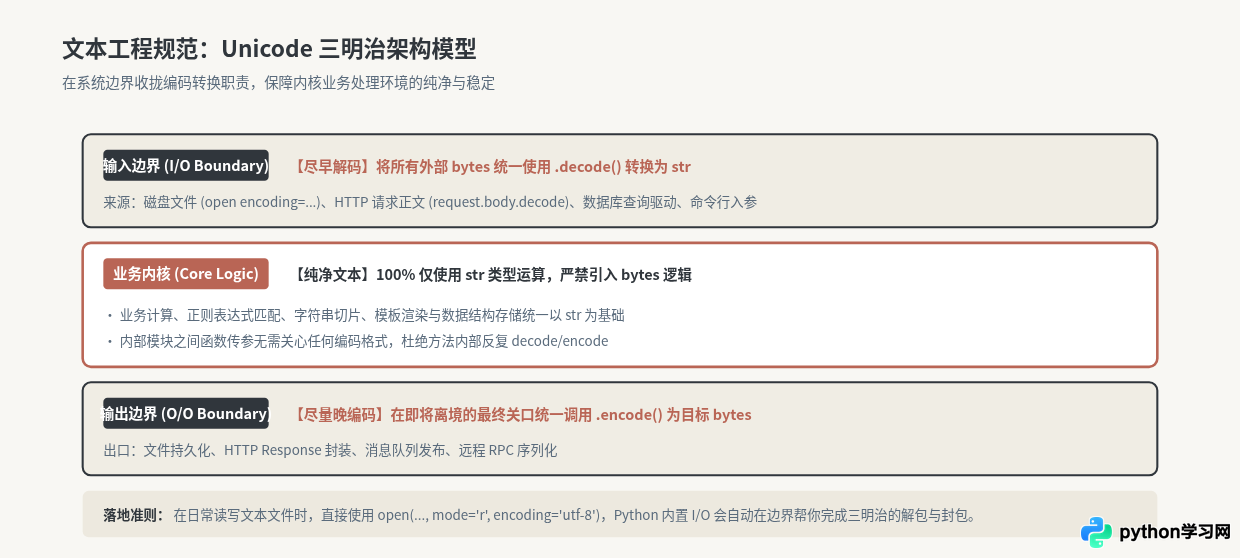
在规模化软件项目中,解决编码混乱的最佳设计模式被称为“Unicode 三明治”(The Unicode Sandwich)。其核心哲学是:“输入尽早解码,输出尽量晚编码,核心全用 Unicode”。
核心实践总结速查
- 明确职责:记住口诀“编码(encode)是字符串变字节,解码(decode)是字节变字符串”。
- 统一编码:除非与遗留硬件或特殊操作系统接口通信,项目内部所有文件和传输协议一律强制使用
UTF-8。 - 文件读写规范:在调用
open()时,凡是文本读写务必显式传入encoding="utf-8"。不要依赖操作系统的默认缺省编码(在 Windows 下默认为特定区域编码如cp936,极易引发跨平台事故)。 - 异常防御:对于不可控的外部字节流,合理选用
errors='replace'或errors='ignore';对于核心配置与金融数据,坚决使用errors='strict'守住数据质量底线。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









