

Python subprocess 处理中文乱码与编码转换技巧
深入讲解 Python subprocess 处理中文乱码与编码转换的实用技巧,分析管道字节流与编码错位原理,提供四步排查法、典型场景参数配置及最佳实践。
在 Python 中使用 subprocess 调用操作系统命令或外部脚本时,中文输出变成生僻乱码或直接抛出 UnicodeDecodeError,核心原因在于子进程输出的原始字节编码与 Python 管道接收端指定的字符集解码器不一致。解决这一问题的根本路径,是掌握子进程输出的实际字符编码(如 Windows 下的 GBK/CP936 与 Linux 下的 UTF-8),并在代码中显式指定编码方式及容错参数,而不是依赖不可控的系统默认配置。
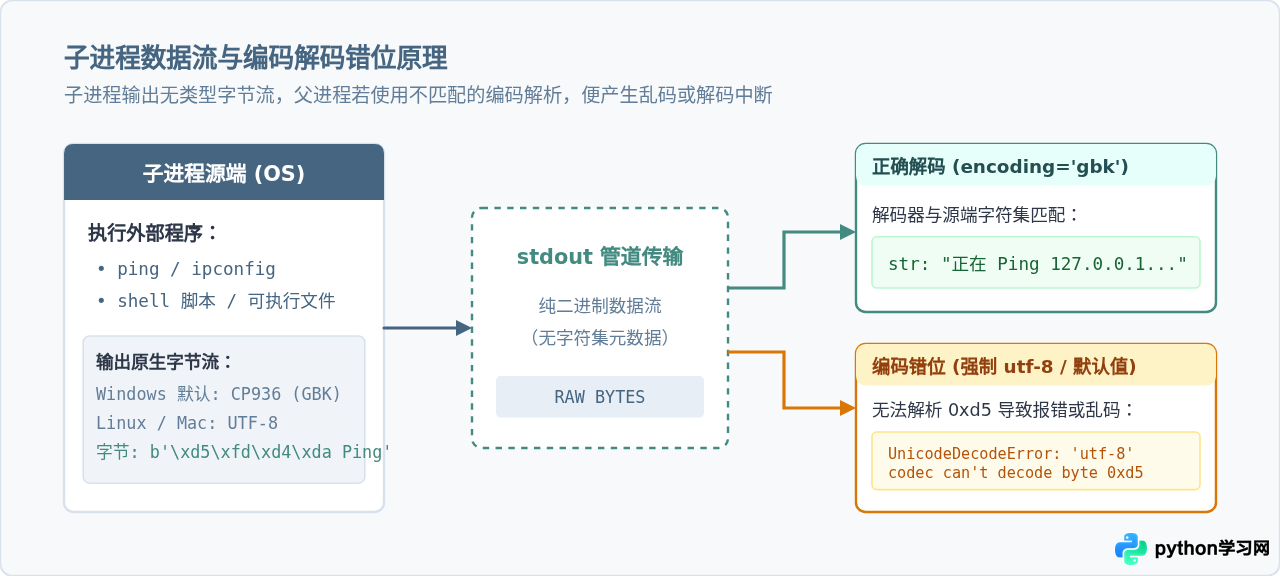
一、乱码根源:管道字节流与编码错位
当 Python 通过 subprocess.run() 或 subprocess.Popen() 创建子进程时,操作系统在父子进程之间建立的是无格式的管道(Pipe)。子进程执行的系统命令(如 Windows 下的 ping、ipconfig 或自定义控制台程序)向标准输出(stdout)写入的是原始字节序列(bytes),而非 Python 中的字符串(str)。
如果在调用参数中开启了 text=True(或等价的 universal_newlines=True),Python 会自动尝试将这些原始字节转换为文本。如果在调用时未显式传入 encoding 参数,Python 3 将使用 locale.getpreferredencoding() 返回的本地默认编码进行解析。在 Windows 中,该默认值通常是基于 ANSI 代码页的 cp936(即 GBK 扩展),但如果调用的是返回 UTF-8 编码的现代 CLI 工具,或者在跨平台部署时环境编码不一致,解码流程就会发生错位。
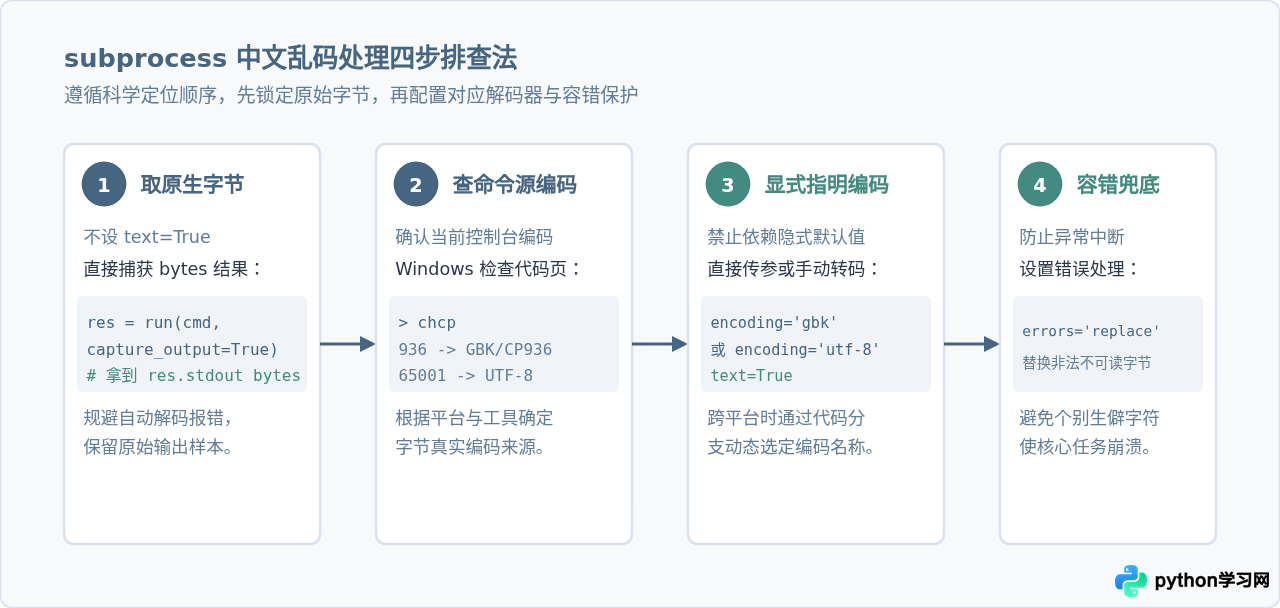
二、四步排查法:从捕获原生字节到稳定输出
遇到控制台乱码时,盲目修改编码参数往往导致代码在开发机正常而在部署机崩溃。推荐使用规范的四步排查流程:
排查步骤代码示例
在实际脚本中,通过 subprocess.run 显式指定 encoding 与 errors 是最稳健的模式:
import subprocess
import sys

# 1. 根据运行平台确定首选编码
cmd_encoding = "gbk" if sys.platform.startswith("win") else "utf-8"

# 2. 执行命令并显式设置 encoding 与 errors='replace'
result = subprocess.run(
    ["ping", "127.0.0.1", "-n", "1"],
    capture_output=True,
    text=True,
    encoding=cmd_encoding,
    errors="replace"  # 遇到非标准字节时替换为 ?,确保进程不崩溃
)

# 3. 输出正常解码后的字符串
print("返回码:", result.returncode)
print("输出文本:\n", result.stdout)
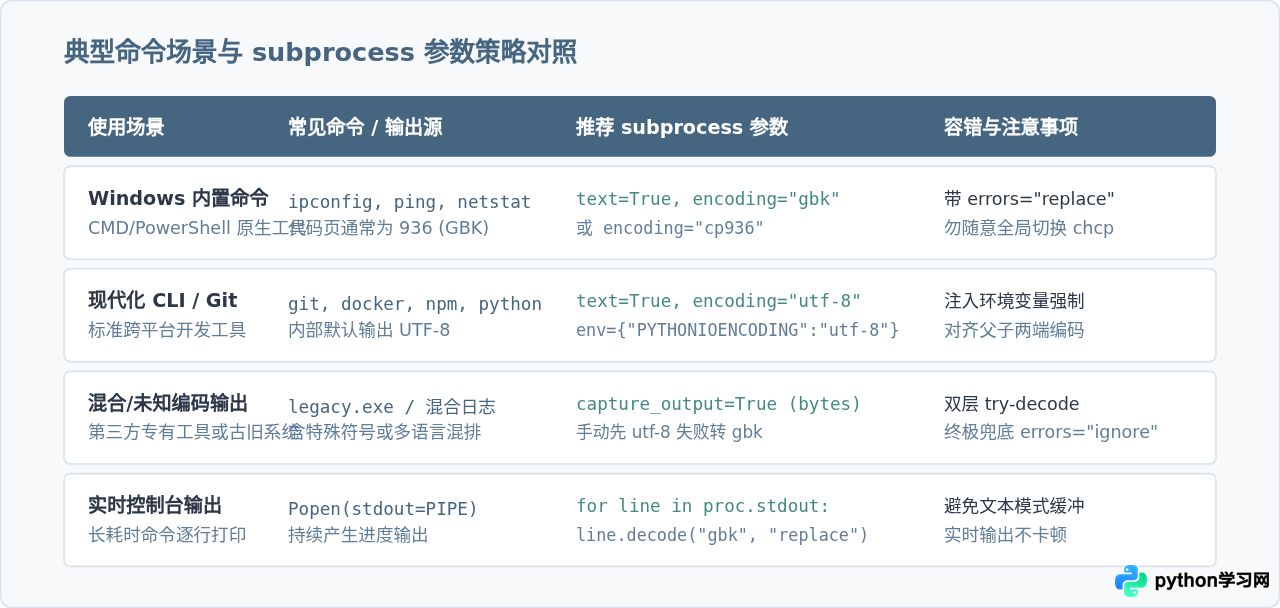
三、典型应用场景与参数策略对照
不同的操作系统和命令环境,其默认输出编码差异极大。以下是工程实践中最常见的四种场景及其参数选择标准:
场景实战:处理动态或混合编码的自适应函数
当执行来自第三方的不可控命令,或同一份代码需要在不同编码的服务器上运行时,可以使用动态解码封装函数:
import subprocess

def run_command_safely(command_args):
    """
    自适应解码运行系统命令,优先使用 utf-8,失败时降级至 gbk,
    并始终附加 replace 策略防止致命中断。
    """
    proc = subprocess.run(
        command_args,
        stdout=subprocess.PIPE,
        stderr=subprocess.PIPE
    )

    raw_stdout = proc.stdout
    raw_stderr = proc.stderr

    def decode_bytes(data: bytes) -> str:
        # 首先尝试最通用的 utf-8
        try:
            return data.decode("utf-8")
        except UnicodeDecodeError:
            pass
        # 降级尝试 Windows 中文常用的 gbk
        try:
            return data.decode("gbk")
        except UnicodeDecodeError:
            pass
        # 兜底:使用 replace 替换无法解析的字符
        return data.decode("utf-8", errors="replace")

    return proc.returncode, decode_bytes(raw_stdout), decode_bytes(raw_stderr)

code, out, err = run_command_safely(["cmd", "/c", "dir"])
print(out[:200])  # 正确显示包含中文的目录列表
四、流式输出与实时日志中的编码技巧
对于耗时较长、需要实时输出执行进度的子进程(如数据同步、批量编译、长测试任务),直接使用 subprocess.run 会等待命令全部结束才一次性返回,无法满足实时监控需求。此时必须使用 subprocess.Popen 并配合管道按行读取。
如果在 Popen 中开启 text=True,Python 会在内部使用 TextIOWrapper 进行自动换行缓冲与解码。如果子进程输出的字符在行尾或特定位置出现不完整多字节序列,可能导致整个读取循环报错退出。在流式场景下的最佳实践是:保持 Popen 输出为原生 bytes 模式,在 Python 端逐行读取并手动调用 line.decode(...)。
import subprocess
import sys

def stream_command(command_args):
    target_encoding = "gbk" if sys.platform.startswith("win") else "utf-8"

    # 保持原生字节管道,避免内部 TextIOWrapper 提前崩溃
    process = subprocess.Popen(
        command_args,
        stdout=subprocess.PIPE,
        stderr=subprocess.STDOUT,
        bufsize=1
    )

    # 逐行读取原生字节并手动容错解码
    with process.stdout:
        for raw_line in iter(process.stdout.readline, b""):
            decoded_line = raw_line.decode(target_encoding, errors="replace")
            print(decoded_line, end="", flush=True)

    process.wait()
    return process.returncode
五、防坑总结与最佳实践
在处理 subprocess 编码问题时,有几个常见的误区需要特别警惕:
- 误区一:盲目在命令前加入
chcp 65001。在 Windows 下,某些内置命令在 UTF-8(65001)代码页下存在 Bug,甚至会输出空内容或异常退出。最稳妥的方式是尊重工具原生的代码页,在 Python 端显式用encoding="gbk"去适配它。 - 误区二:认为
shell=True会自动解决编码。shell=True仅代表命令通过系统 Shell(如cmd.exe或/bin/sh)启动,数据通过管道回传时依然是纯原始字节,不仅无法解决编码问题,还会引入额外的转义风险。 - 误区三:遗漏
errors="replace"容错机制。即便知道对方大致是 GBK 或 UTF-8,控制台命令仍可能输出进度符号、ANSI 颜色转义字符或生僻专有字符。始终显式传入errors="replace",可以保证服务不会因为一个无关紧要的字符而崩溃。
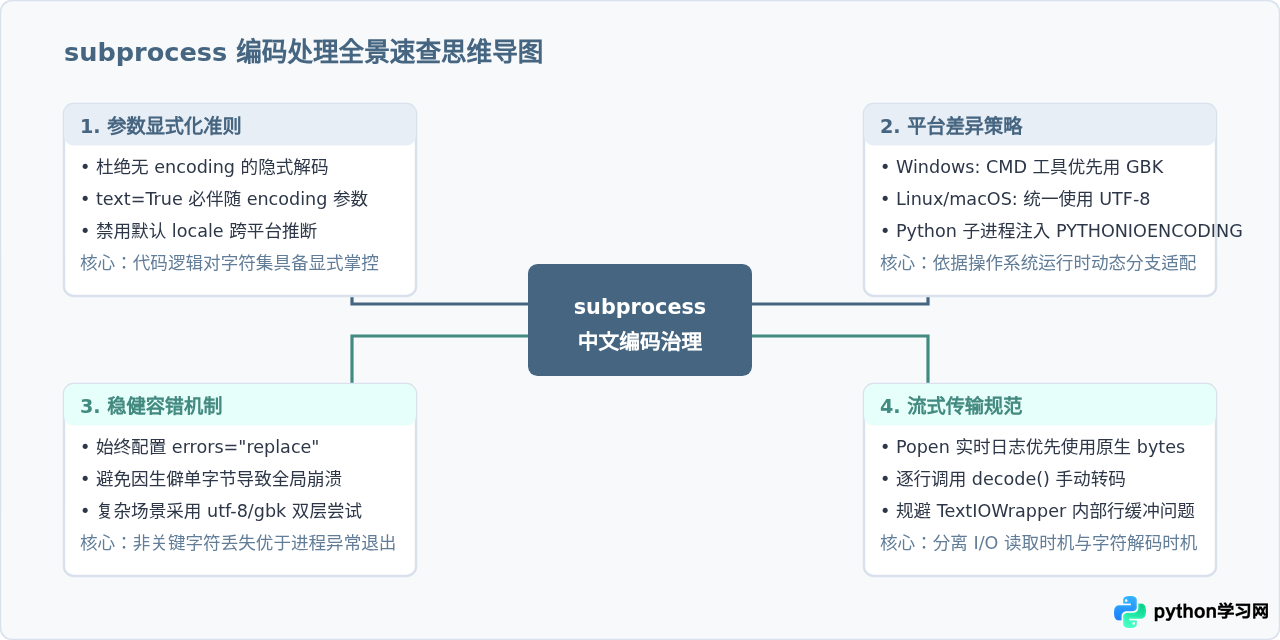
先看平台再定源,显式传参莫偷闲;Windows 内置多为 GBK,现代命令 UTF-8 连;容错必加 replace 护,流式字节手动编。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









