

用 Python 加载 Hy4 flash 前,怎样选权重和检查环境?
从Python加载流程理解Hy4 flash指令版、FP8与base,说明官方依赖示例、资源条件和商业许可边界。
用 Python 接入 Hy4 flash 前,先把指令权重、FP8 量化指令权重和 base 基础权重分开:聊天与图文示例适用于前两者。然后核对 Transformers 实现、设备资源和 Tencent Hy License 1.0,再决定是否进入下载和加载阶段。
先按任务选模型,而不是只看文件大小
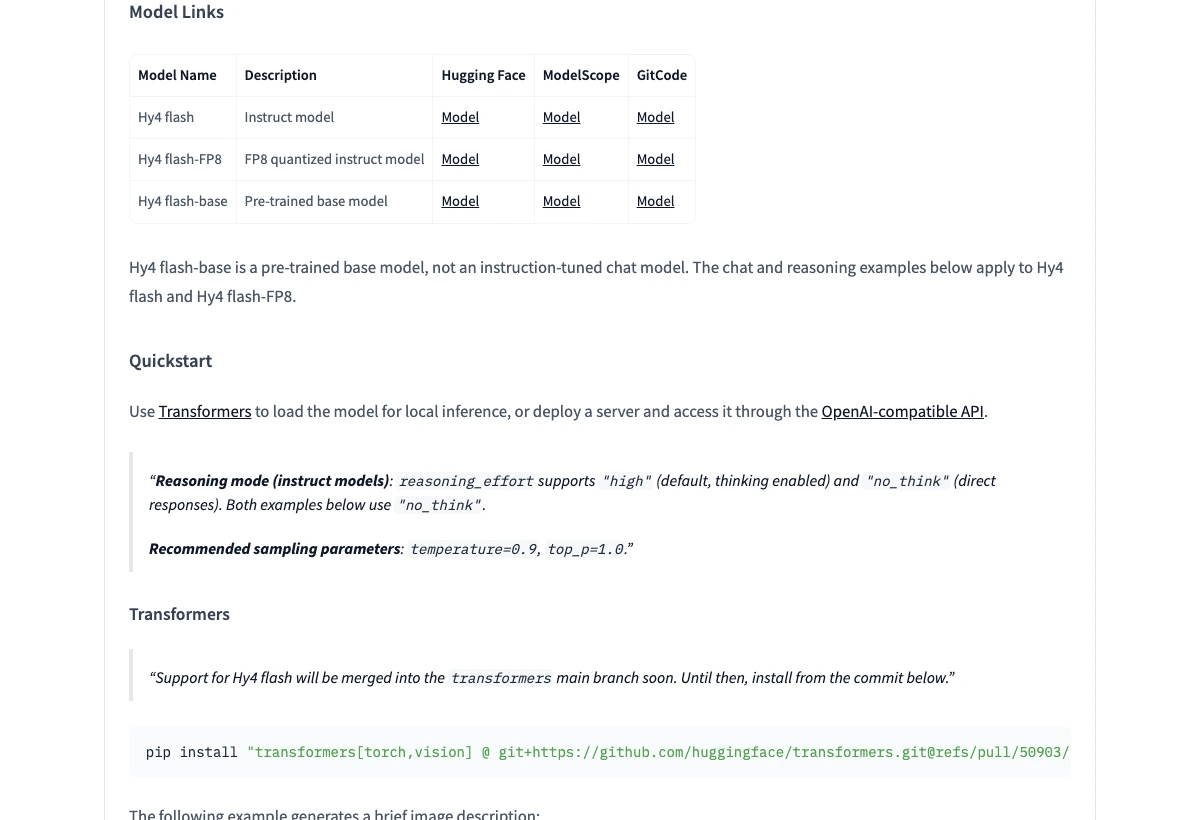
官方把 Hy4 flash 标为 Instruct model,把 Hy4 flash-FP8 标为 FP8 quantized instruct model,把 Hy4 flash-base 标为 Pre-trained base model。要做对话、图像描述或使用模型卡里的推理模式,应从指令版本评估;base 属于预训练基础模型,不是指令微调聊天模型。
量化版仍是指令模型,但 FP8 格式能否用于自己的部署,取决于硬件与推理框架支持。基础版则应结合继续训练、研究等需求判断,不能直接套用聊天演示并期待相同的遵循指令表现。
下列指令版示例所参照的仓库文档固定在提交 d88c9dfd96ba4f2e6b92adba0b8e8f1c8696f959。这个提交标识用于定位资料,不代表独立的软件发行版本号。
官方 Hugging Face 仓库在2026年11月17日的创建和分发记录可以确认这批权重进入该渠道;这一记录不足以界定全球首发。模型卡列出的其他权重渠道包括 ModelScope 和 GitCode。
资源评估为何不能只盯着12B?
按官方介绍,Hy4 flash 总参数约220B,包含约64B Engram 参数,每 token 激活约12B;输入可以是文本或图片,输出为文本。官方给出的最大上下文为1M,即规格表中的1,048,576 tokens。上述内容属于厂商规格,实际性能需在目标环境测试。
每次激活12B不等于只需为12B权重准备内存。加载格式、设备分配、并行方式和上下文缓存都影响预算。官方服务端配置示例采用八路张量并行,但示例不能充当所有环境通用的最低硬件说明;最长上下文是否可用,也要放到实际资源条件下判断。
第一步:核对 Python 依赖的实现来源
在所核验模型卡中,Transformers 支持仍待合入主分支,安装命令引用拉取请求50903的开发版本。下面是原始命令,适合在独立评估环境中理解依赖要求;它会安装开发代码及 torch、vision 依赖,不是任意现成发行版都可替代。开发引用会变化,正式部署还应锁定实际验证过的提交。
pip install "transformers[torch,vision] @ git+https://github.com/huggingface/transformers.git@refs/pull/50903/head"
此步骤的预期结果是安装模型卡要求的实现,而不是完成模型下载或推理。若加载时提示架构无法识别,应先排查安装来源和实际依赖是否一致,不应通过切换到 base 掩盖兼容问题。
第二步:在资源就绪后理解加载与生成
以下保留官方图文描述代码,模型 ID 指向 Hy4 flash。它经处理器建立对话模板,用示例图片和提示词生成一句话描述。只有兼容环境与设备容量已经确认时才适合尝试;from_pretrained 可能获取大量文件,device_map="auto" 也不保证任意设备能够装下模型。这段官方示例不代表已完成实际下载和推理。
from transformers import AutoModelForImageTextToText, AutoProcessor

model_id = "tencent/Hy4-flash"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForImageTextToText.from_pretrained(model_id, device_map="auto")

messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image",
                "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg",
            },
            {"type": "text", "text": "Describe this image in one sentence."},
        ],
    }
]

inputs = processor.apply_chat_template(
    messages,
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
    reasoning_effort="no_think",
).to(model.device)

outputs = model.generate(**inputs, max_new_tokens=256)
print(processor.decode(outputs[0, inputs["input_ids"].shape[1] :], skip_special_tokens=True))
reasoning_effort="no_think" 是直接回答设置。指令模型还支持 "high",官方将它列为默认思考模式。生成完成时,打印结果应是对图片内容的文本描述;不要把输出文字当成逐字固定的验收答案。max_new_tokens=256 约束新增输出 token 的上限,与完整上下文窗口是两回事。
模型卡另推荐 temperature=0.9 和 top_p=1.0;上面的原始 Transformers 代码并未显式设置这两个值。排查结果差异时应区分采样参数、思考设置和模型变体。资源不足需要重新评估容量或受支持的部署配置,不能仅凭量化名称保证成功。
第三方服务计划需要看哪些授权条件?
Tencent Hy License, Version 1.0 以 Apache License 2.0 为基础,但明确不是 Apache License 2.0,另有 MaaS 商业条款。MaaS 在条款中指向第三方开放远程推理或微调,让第三方提交输入、指定参数或训练数据;仅限特定功能或工作流且不提供通用模型访问的终端产品,以及单纯转发独立第三方模型服务请求的情形,被排除在该定义之外。
经营 MaaS 业务时,任一连续12个月全球总收入超过5,000万美元,无论收入是否来自该模型,使用或继续使用前须取得单独书面许可;在任一自然月月活超过1亿的自有产品或服务中使用模型或衍生作品之前,也触发该要求。第10.3节对纯内部使用另有例外,条件是模型、衍生作品及输出均不向第三方提供。实际使用应结合完整许可证,而不能把可下载权重理解成没有附加商业限制。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









