

Python怎么按指定字段对字典列表进行排序
详细讲解在Python中如何使用sort与sorted配合lambda表达式或operator.itemgetter按指定字典字段进行升序、降序及多字段组合排序。
在 Python 中对包含多个字典的列表进行排序,最直接且标准的做法是使用内置的 sorted() 函数或列表对象的 sort() 方法,并配合 key 参数指定用来比较的字段。通过向 key 传入 lambda 表达式或标准库中的 operator.itemgetter,你可以指定任意字段进行升序、降序或多级组合排序。
一、核心原理:key 参数是如何提取字段的
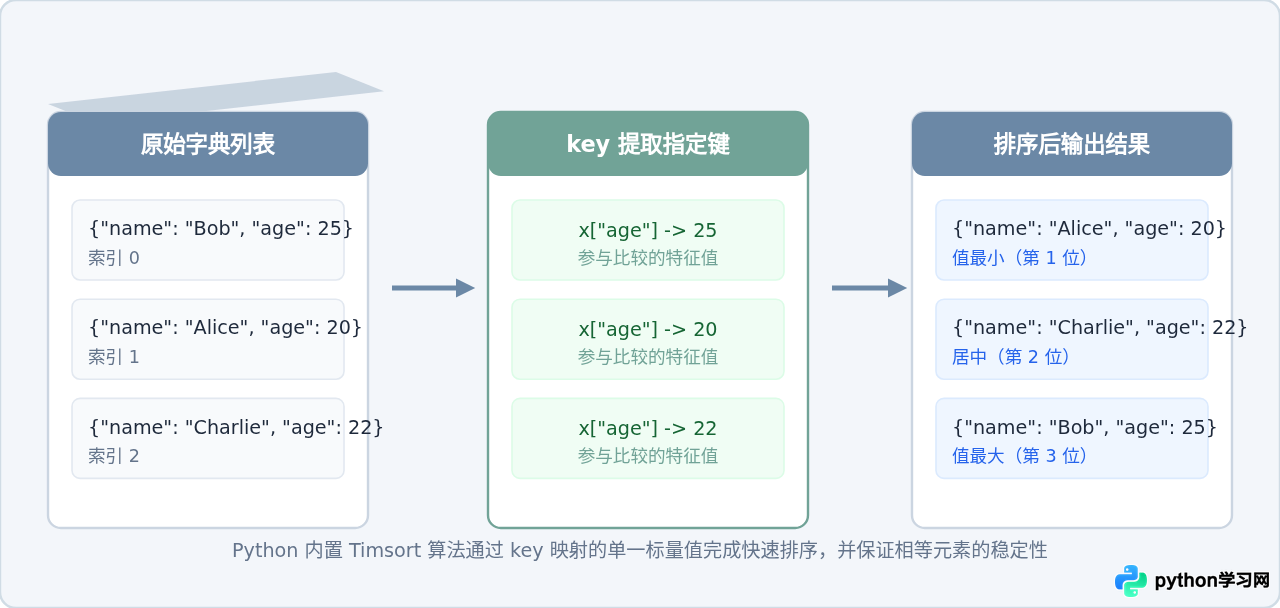
字典本身是键值对的无序集合(Python 3.7+ 保持插入顺序),两个字典对象之间默认无法直接比大小。例如 {"age": 20} < {"age": 25} 在 Python 3 中会直接抛出 TypeError。排序算法需要知道从每个字典中“拿什么值出来比较”,这就是 key 参数的作用。
key 接收一个可调用对象(函数),排序机制会在遍历列表中的每一个字典元素时,将该字典传入该函数,并使用该函数的返回值作为排序的对比依据,原列表中的字典结构保持完整。
二、基础实操:使用 lambda 表达式排序
lambda 是定义匿名函数的简便语法。当需要按字典中的某个字段排序时,直接写出 lambda x: x['字段名'] 即可,这也是日常开发中最常用的方式。
1. 升序排序与降序排序
假设我们有一组学生信息,需要按 score 字段进行排列:
students = [
    {"name": "张三", "score": 85},
    {"name": "李四", "score": 92},
    {"name": "王五", "score": 78}
]

# 1. 升序排列(从小到大)
asc_result = sorted(students, key=lambda item: item["score"])
print("升序结果:", asc_result)

# 2. 降序排列(从大到小),增加 reverse=True 参数
desc_result = sorted(students, key=lambda item: item["score"], reverse=True)
print("降序结果:", desc_result)
运行输出:
升序结果: [{'name': '王五', 'score': 78}, {'name': '张三', 'score': 85}, {'name': '李四', 'score': 92}]
降序结果: [{'name': '李四', 'score': 92}, {'name': '张三', 'score': 85}, {'name': '王五', 'score': 78}]
三、原地排序 vs 产生新列表:sort() 与 sorted() 的选择
在实际编码中,很多初学者容易混淆 list.sort() 和内置函数 sorted()。这两个工具都接受相同的 key 和 reverse 参数,但对内存与原数据的处理方式截然不同:
sorted(iterable, key=..., reverse=...):接收任意可迭代对象,排序后返回一个全新的列表,原始列表内容和结构没有任何改变。list.sort(key=..., reverse=...):是列表独有的专属方法,直接在原列表内存空间上修改顺序(原地排序),该方法固定返回None。
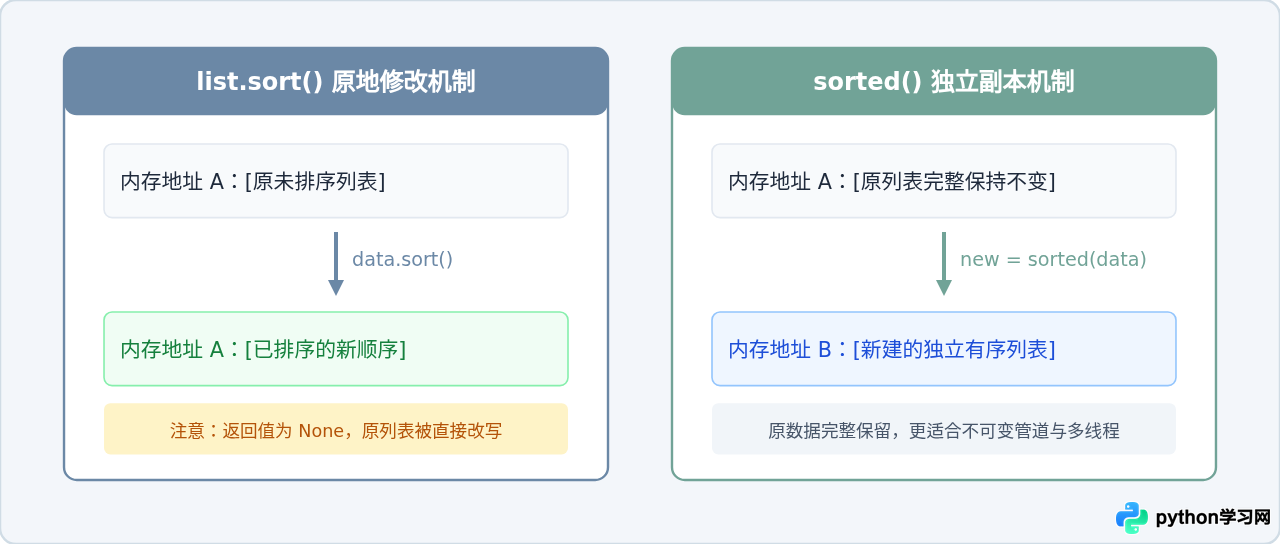
data = data.sort(key=...)。因为 sort() 返回 None,这会导致原列表丢失,变量 data 变成 None。
四、进阶提速:使用 operator.itemgetter
虽然 lambda 简单直观,但 Python 标准库中的 operator 模块提供了由 C 语言底层实现的 itemgetter 函数。在处理大规模数据(成千上万条记录)时,itemgetter 的执行效率显著高于 lambda 表达式,同时在语法表达上更加清晰。
1. 单字段与多字段对比
from operator import itemgetter

users = [
    {"dept": "Dev", "name": "Alice", "age": 30},
    {"dept": "HR",  "name": "Bob",   "age": 25},
    {"dept": "Dev", "name": "Charlie", "age": 22},
    {"dept": "HR",  "name": "David", "age": 28}
]

# 单字段排序:等价于 lambda x: x["dept"]
by_dept = sorted(users, key=itemgetter("dept"))

# 多字段排序:先按部门升序,部门相同的按年龄升序
# 等价于 lambda x: (x["dept"], x["age"])
by_dept_and_age = sorted(users, key=itemgetter("dept", "age"))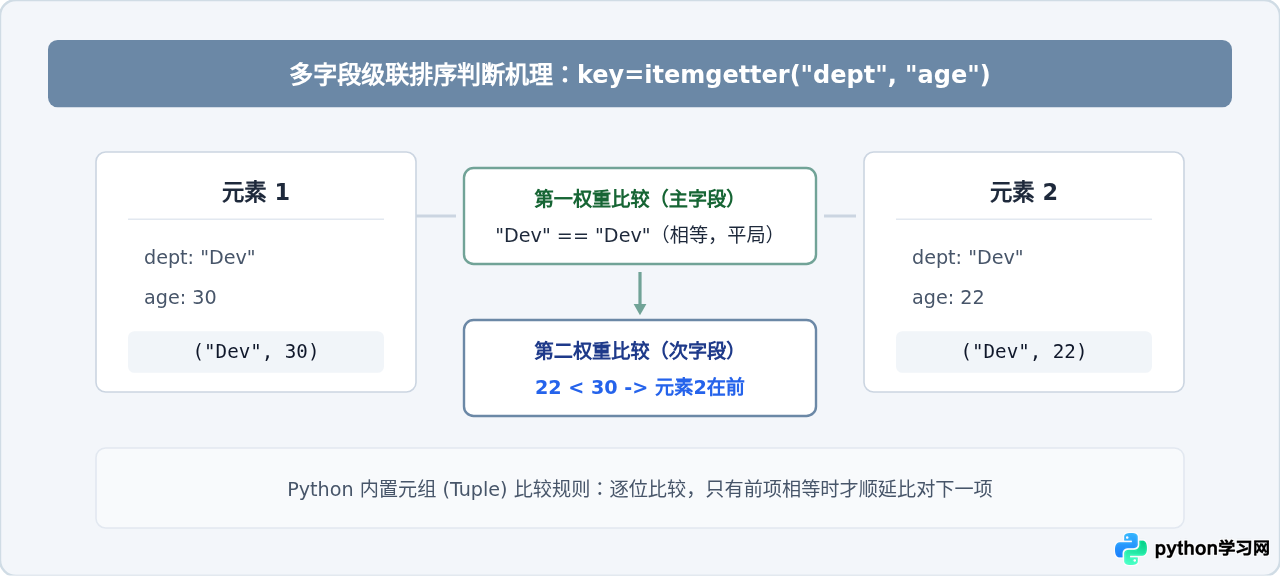
五、复杂场景应对方案
1. 多字段混合升降序(如:部门升序,年龄降序)
如果使用 reverse=True,整个排序过程所有字段都会倒序。若需要“字段 A 升序、字段 B 降序”,有以下两种实用解法:
- 数值字段取负数法(最简便):如果次要排序字段是数字,直接在提取值时加上负号
-。 - 利用 Timsort 稳定排序分步执行:Python 的排序算法是“稳定”的(相同键值的相对次序不会改变),因此可以先按次字段排序,再按主字段排序。
# 场景:部门升序,年龄降序
records = [
    {"dept": "Dev", "age": 30},
    {"dept": "HR",  "age": 25},
    {"dept": "Dev", "age": 22},
    {"dept": "HR",  "age": 28}
]

# 解法一:对数值字段取负(推荐用于数值类型)
res1 = sorted(records, key=lambda x: (x["dept"], -x["age"]))

# 解法二:利用稳定性分步排序(通用,支持任意类型)
records_step = records.copy()
records_step.sort(key=lambda x: x["age"], reverse=True)  # 次要关键字(降序)
records_step.sort(key=lambda x: x["dept"])               # 主要关键字(升序)
2. 处理字典中缺失字段的情况
如果列表中某些字典缺少要排序的字段,直接使用 x['key'] 会抛出 KeyError。此时应改用 dict.get() 并提供缺省默认值:
data = [
    {"name": "Alice", "score": 90},
    {"name": "Bob"},                   # 没有 score 字段
    {"name": "Charlie", "score": 80}
]

# 缺少 score 时默认记为 0 分排在前面
safe_sort = sorted(data, key=lambda x: x.get("score", 0))
六、方案选型与总结
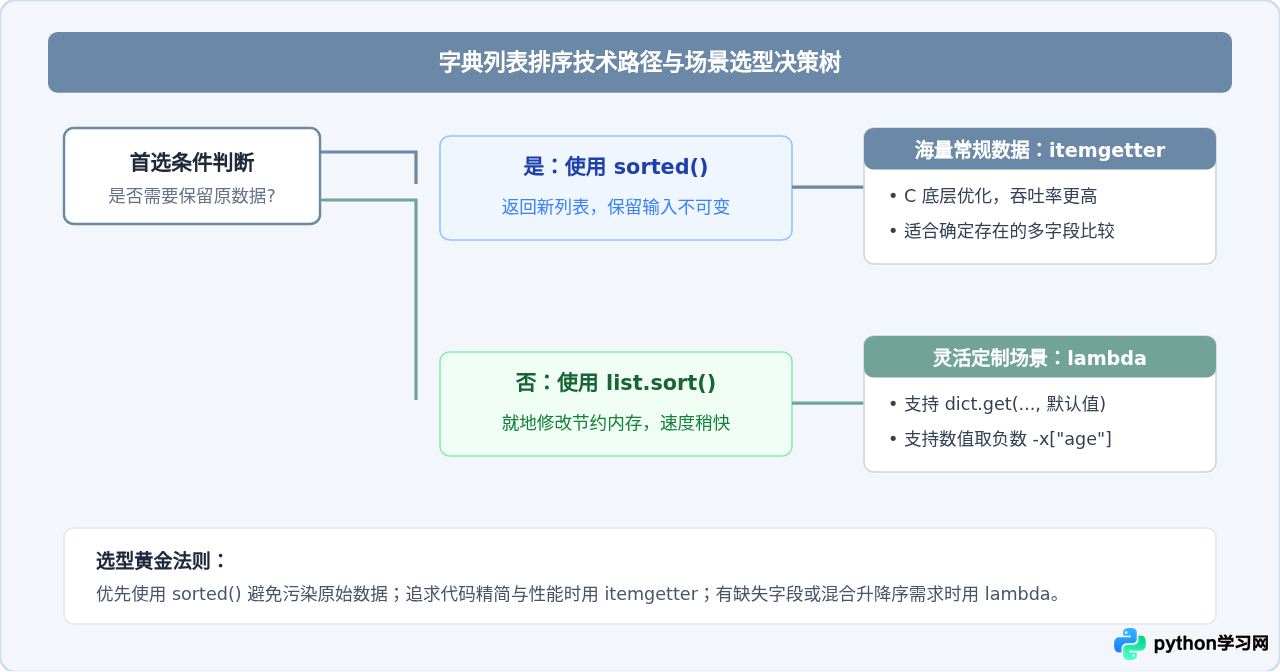
为了在不同工程场景下选择最恰当的方法,可以参考下面的选型决策图及特性对照表:
| 方法 / 方式 | 返回值 | 是否改变原列表 | 适用场景 |
|---|---|---|---|
sorted(..., key=lambda) |
新列表 | 否(安全) | 需要灵活转换数据、提供缺省值、保留原数据时最常用 |
sorted(..., key=itemgetter) |
新列表 | 否(安全) | 大量数据排序、多字段级联排序,性能和清晰度兼顾 |
list.sort(key=...) |
None |
是(原地更新) | 列表规模极大、内存敏感,无需保留原始顺序的场景 |
sorted(data, key=lambda x: x["field_name"]) 即可解决绝大多数日常需求;面对更复杂的多字段级联或大数据集时,再灵活选用 itemgetter 和分步稳定排序即可游刃有余。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









