

在线运行Python与本地IDE的区别:文件IO和网络请求限制说明
对比在线运行Python与本地IDE在文件读写和网络请求上的核心区别,详细说明沙箱隔离、虚拟文件系统、网络安全策略及实际避坑指南。
在浏览器里打开网页就能直接运行 Python 代码,无需配置环境变量和安装解释器,是许多初学者练习语法的起点;但在本地使用 VS Code、PyCharm 等集成开发环境(IDE)则是实际软件开发的主流方式。两者的核心差异并不只是界面不同,而在于代码执行的底层宿主与权限边界。特别是在执行文件读写(File I/O)与发送网络请求时,在线平台为了服务安全与资源隔离普遍设置了严格的沙箱规则,而本地环境则受制于宿主操作系统的权限。理解这些限制的具体成因与表现,能够帮你在遇到“代码在本地报错”或“在线平台无响应”时迅速定位根源。
一、架构根源:本地解释器与在线沙箱的本质区别
在本地 IDE 中编写 Python 时,代码是由安装在个人电脑操作系统(Windows、macOS 或 Linux)上的 Python 解释器直接解析执行。你的脚本继承了当前登录用户的系统权限,可以直接访问本地硬盘上的目录,也可以借助本机的物理网卡发起任意协议的 TCP/UDP 连接。
在线 Python 运行平台则完全不同,目前主要分为两类实现方案:
- 服务端沙箱容器(Server-side Sandbox):例如轻量在线评测系统或在线编译器。你的代码被提交至远程服务器,在隔离的 Docker 容器或轻量虚拟机(如 gVisor、Firecracker)中运行,输出结果再通过 WebSocket 或 HTTP 传回前端。这类环境会施加严格的 CPU 耗时、内存上限、磁盘配额与网络防火墙策略。
- 客户端浏览器引擎(WebAssembly/Pyodide):例如很多纯静态教学网站。Python 解释器被编译为 WebAssembly(Wasm)直接运行在浏览器的 JavaScript 引擎线程内。此时代码完全受制于浏览器的安全沙盒,无法触碰本地真实硬件资源。
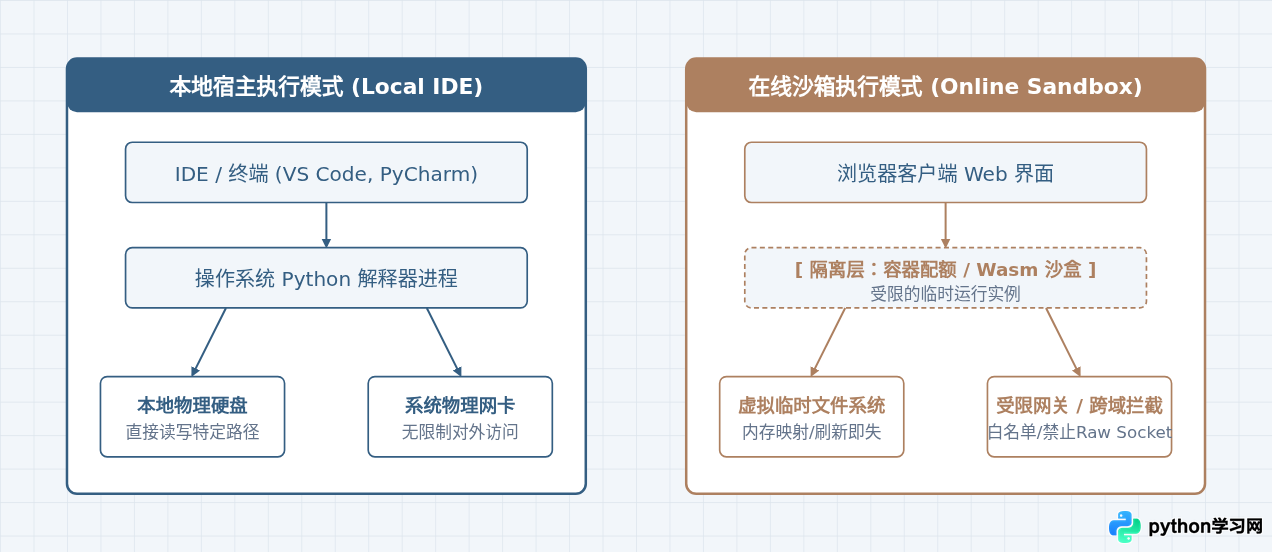
图 1:本地执行与在线沙箱运行的资源路由与安全边界对比架构图
二、文件 I/O 限制:路径访问、临时映射与数据持久化
在本地 IDE 中编写 Python 代码操作文件是简单直接的,代码可以直接操作指定路径下的物理文件:
# 本地典型写入操作:文件直接生成在真实磁盘上
with open("data.txt", "w", encoding="utf-8") as f:
    f.write("本地持久化存储内容")
运行后,当前项目工作区会立刻出现 data.txt,关闭 IDE、重启电脑后依然存在。但在在线平台上,相同代码的运行表现存在根本差异:
1. 虚拟文件系统(VFS)与易失性
在线平台为了防止用户恶意填满服务器硬盘或篡改宿主文件,通常提供由内存或临时挂载卷构造的虚拟文件系统。在基于 Pyodide(WebAssembly)的平台中,文件系统本质是 Emscripten 在浏览器内存中模拟的,其生命周期与当前标签页绑定。你使用 open("data.txt", "w") 能够写入成功且正常读取,但一旦刷新或关闭网页,内存释放,文件立刻消失。
2. 绝对路径受限与隔离
如果在代码中尝试访问类似 C:\Users\Admin\Desktop 或 Linux 根路径 /etc/passwd,本地 IDE 在拥有相应权限时可以访问(或报权限不足),而在线容器通常会执行 chroot 限制或只允许在固定的工作目录(如 /workspace)内进行 I/O 操作。超出指定工作路径的访问会直接触发 PermissionError 或 FileNotFoundError。
3. 存储容量配额限制
在线服务端容器通常配置有严格的磁盘配额(例如单次执行允许写入的最大文件不超过 10MB 至 50MB)。如果一段循环写入大数据的代码试图创建数百兆的文件,系统会在底层抛出 OSError: [Errno 28] No space left on device 或被运行守护进程强制终止。
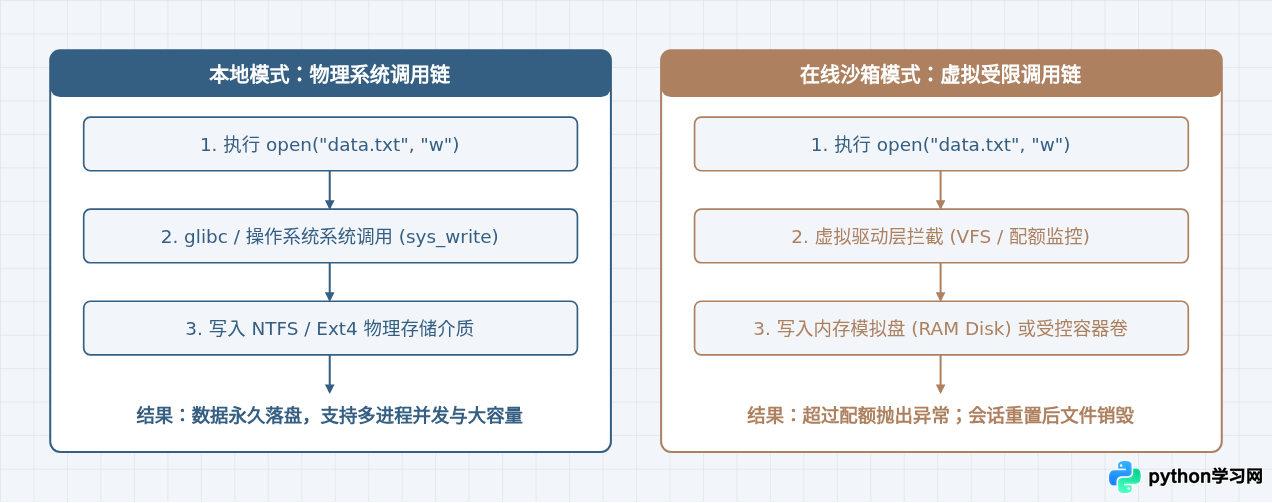
图 2:本地与在线环境在处理 open() 文件 I/O 时的底层调用与持久化路径
三、网络请求限制:套接字、跨域拦截与防火墙策略
在网络编程和爬虫任务中,在线运行与本地运行的分野更加明显。在本地运行一段使用 requests 库的代码:
import requests

response = requests.get("https://httpbin.org/get", timeout=5)
print(response.status_code)
在本地 IDE 中,这段脚本通常能如期返回 200。但是将完全相同的代码粘贴到在线平台中,往往会出现 ConnectionError、请求超时甚至 ModuleNotFoundError。其核心限制体现在三个维度:
1. 底层 Socket 权限剥离
普通的 Python 网络库(如 socket、urllib、requests、aiohttp)依赖底层的操作系统套接字(POSIX Socket)。如果在线环境采用客户端 WebAssembly(如 Pyodide),浏览器内核是不允许任意代码打开裸 TCP/UDP 套接字的。因此,原生的 requests 在这种环境下直接无法工作,必须替换为浏览器提供的 fetch API 封装库,如 pyodide-http。
2. 浏览器的同源策略与 CORS 限制
一旦网络请求被转译为浏览器的 fetch 或 XMLHttpRequest,它就必须遵守同源策略(SOP)。目标接口如果未在 HTTP 响应头中配置允许跨域访问(Access-Control-Allow-Origin: *),即使服务器返回了数据,浏览器也会把响应拦截并报错。本地 IDE 运行的 Python 进程不是浏览器,根本不受 CORS 规则制约,能够直接抓取任意公开 URL。
3. 服务端沙箱的出网策略(Egress Control)
对于在远程服务器运行代码的平台(如 LeetCode、各类在线评测机),为了防止恶意用户将平台作为“跳板机”发动 DDoS 攻击、扫描内网敏感端口或进行挖矿,运维层面会直接在虚拟网卡配置防火墙(iptables)规则:
- 完全切断外网连接:代码执行沙箱没有公网访问权限,尝试联网会直接触发超时。
- 严格的域名白名单:仅允许访问平台自身静态资源或指定的特定公共 API。
- 禁用特权端口与协议:阻断除 HTTP/HTTPS 之外的任意协议(如 SSH 22 端口、SMTP 25 端口以及原生 Socket 服务端监听)。
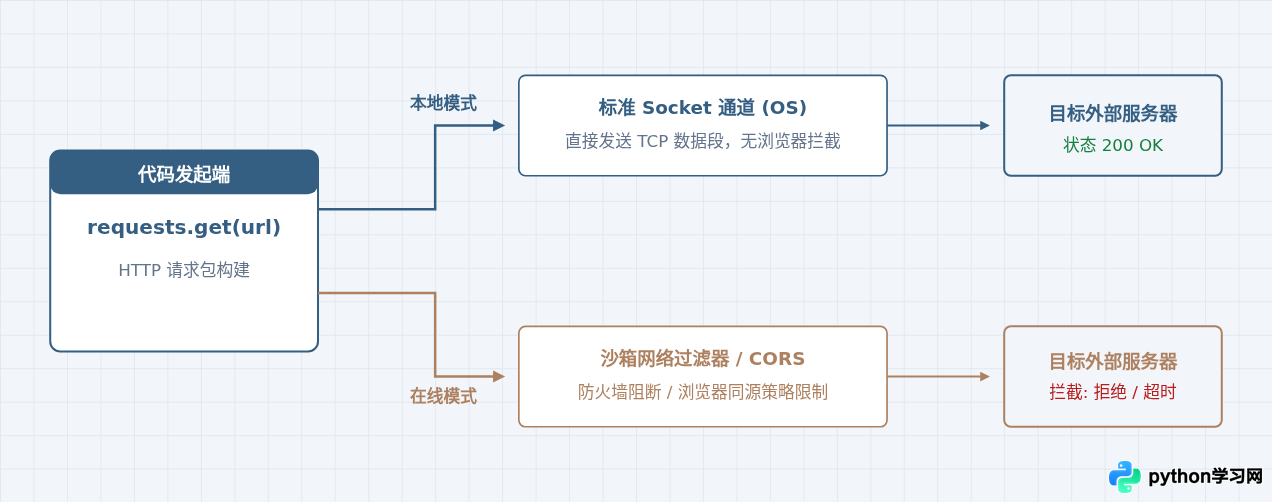
图 3:本地环境标准 TCP 连接与在线沙箱(CORS / 防火墙过滤)网络拓扑流向比对
四、特性差异与适用场景对照
为了让不同场景下的技术选型更加清晰,下表从文件系统、网络通信、安全性与调试便利性等关键维度,对在线环境与本地 IDE 进行了全面对比:
| 功能维度 | 在线运行环境(Web / Sandbox) | 本地集成开发环境(IDE) |
|---|---|---|
| 文件读写目标 | 内存虚拟文件系统(VFS)或受配额限制的容器临时目录 | 本机真实硬盘(NTFS、APFS、Ext4 等物理分区) |
| 持久化行为 | 会话重置或网页刷新后数据清空,无法保留长期日志 | 完全持久化,文件长期保存,支持任意大小容量 |
| 外部网络请求 | 受沙箱出网策略(Egress)限制;Wasm 环境受浏览器 CORS 拦截 | 由本地物理网卡直接转发,可访问公网与内网任何开放端口 |
| 网络协议支持 | 一般仅支持有限的 HTTP/HTTPS;通常禁止纯 TCP/UDP 裸 Socket | 原生完整支持 Socket、WebSocket、gRPC、MQTT 等所有网络协议 |
| 开箱即用成本 | 极低,打开网页即可编写代码,无需配置任何 Python 环境 | 需要手动安装解释器、配置 PATH 环境变量、安装虚拟环境 |
| 典型适用任务 | 算法刷题、语法教学、快速验证代码逻辑片段、轻量演示 | 工程化项目、爬虫开发、自动化脚本、数据批量处理、后端服务 |
五、开发决策与避坑指南
了解限制后,开发者应当根据具体任务选择适合的环境。盲目在在线工具中调试复杂的 I/O 与网络脚本,往往会导致大量时间浪费在排除与业务逻辑无关的沙箱报错上。通过以下判定流程,可以快速明确开发环境:
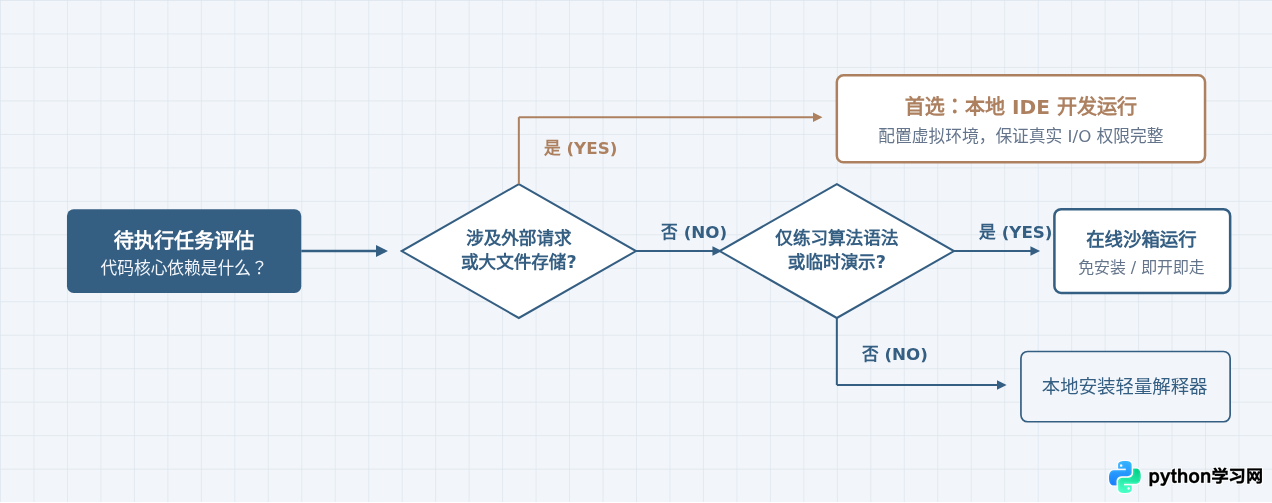
图 4:基于 I/O 深度与网络依赖特性的 Python 运行环境决策逻辑流程图
避坑总结:
- 必须保留生成结果时:不要使用纯在线平台进行数据生成任务。如果必须在线运行,确保平台提供文件挂载支持或提供了将 VFS 结果打包下载至本地的专属导出按钮。
- 排查网络请求报错时:若在在线运行中遇到
ConnectionRefused或CORS Missing Allow Origin,不要盲目修改重试次数或添加请求头,应首先将相同的代码直接迁移至本地 IDE 终端执行,验证是否为沙箱防火墙或跨域限制所致。 - 依赖系统原生库时:涉及多进程(
multiprocessing)、系统底层设备操作(如串口、音频硬件)或特定 C 扩展的代码,WebAssembly 与在线沙箱容器大多无法完全兼容,必须在本地配置独立的 Python 虚拟环境执行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









