

Python嵌套字典怎么读取深层数据
详解在Python中读取嵌套字典深层数据的核心方法,包括链式访问、连续get防护、自定义安全提取函数以及functools.reduce方案,帮助你从容处理API响应与多层JSON结构。
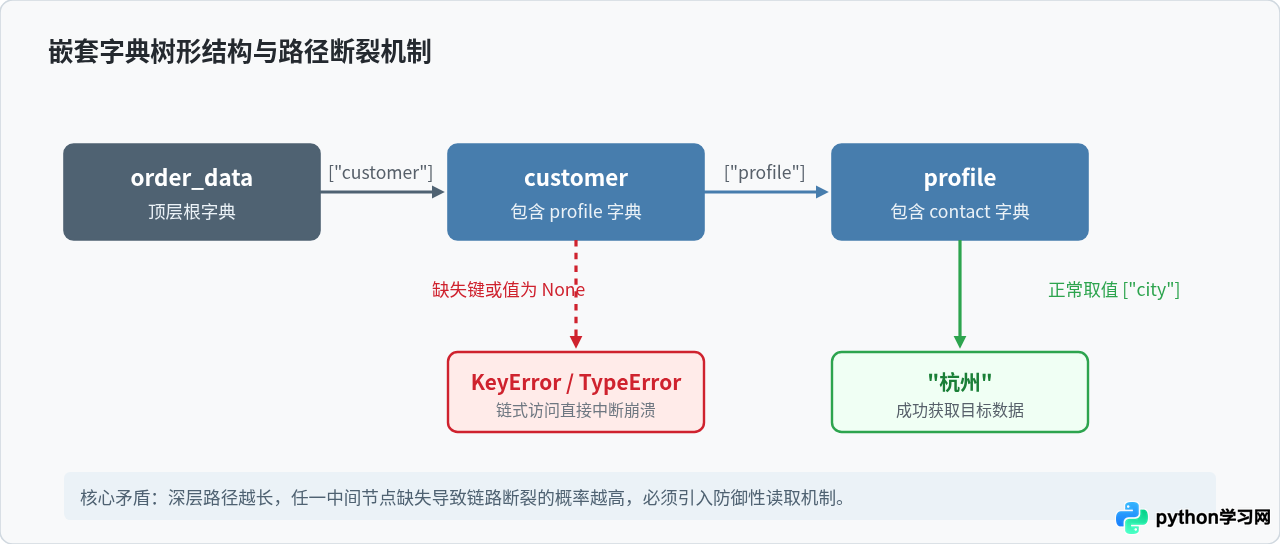
在解析接口响应(JSON)、处理多层系统配置或分析爬虫清洗后的结构化数据时,经常会遇到层层包裹的嵌套字典。直接使用常规的方括号下标访问深层节点,一旦某一级键名缺失或某一层的值为 None,程序就会立即中断抛出 KeyError 或 TypeError。本文将系统讲解在 Python 中读取嵌套字典深层数据的常见思路、具体实现方法以及不同场景下的选型策略。
为什么直接访问容易出错
假设我们接收到如下关于用户订单的嵌套字典数据:
order_data = {
    "order_id": "ORD_20261016",
    "customer": {
        "profile": {
            "name": "李晓华",
            "contact": {
                "city": "杭州"
            }
        }
    }
}
如果数据格式完全确定且各字段始终存在,使用连续的方括号可以非常直接地取出城市信息:
city = order_data["customer"]["profile"]["contact"]["city"]
print("所在城市:", city)  # 输出: 杭州
然而真实世界中的网络数据往往存在字段缺失或部分结构可选的情况:
- 键名不存在(KeyError):如果某个用户的资料中未填写
contact,直接调用order_data["customer"]["profile"]["contact"]会抛出KeyError: 'contact'。 - 父级节点类型改变(TypeError):如果上一级字段值解析结果为
None,例如"profile": None,那么紧接着对其执行["contact"]就会报出TypeError: 'NoneType' object is not subscriptable。
方案一:连续使用 dict.get() 并指定空字典兜底
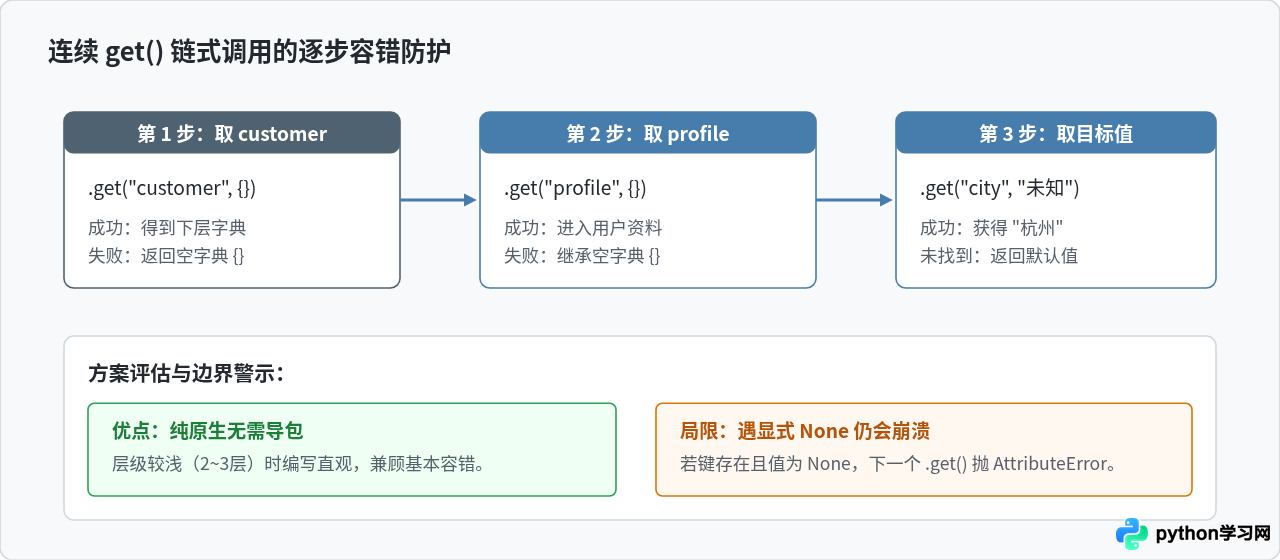
Python 字典的内置方法 get(key, default) 允许在键不存在时返回设定的默认值(缺省为 None)。为了实现深层取值,可以通过级联 get() 并将每层默认值设置为 {},从而保证后续调用不会因 None 而报错:
# 每一级未找到时回退为空字典 {},最后一级回退为最终默认值 "未知城市"
city = order_data.get("customer", {}).get("profile", {}).get("contact", {}).get("city", "未知城市")
print("读取结果:", city)注意潜在缺陷:如果中间某个键显式存在,但其值本身就是 None(例如接口返回了 "profile": None),order_data.get("customer", {}).get("profile", {}) 取出的不是默认的 {},而是真实值 None。随后执行 None.get("contact", {}) 时,仍然会抛出 AttributeError: 'NoneType' object has no attribute 'get'。
方案二:编写通用的安全提取函数(推荐)
为了彻底解决中间节点不是字典(如为 None、列表或基本类型)导致的方法缺失问题,最健壮的方式是封装一个通用的辅助函数。该函数接收数据源、键路径元组(或列表)以及兜底默认值。
def safe_get(data, keys, default=None):
    """
    按键路径安全读取深层数据
    :param data: 目标字典
    :param keys: 键路径迭代对象,如 ["customer", "profile", "contact", "city"]
    :param default: 提取失败时的默认返回值
    """
    current = data
    for key in keys:
        if isinstance(current, dict):
            current = current.get(key)
        else:
            return default
    return current if current is not None else default
我们用各种可能出现的数据结构来验证该函数的鲁棒性:
# 场景 1:路径完整
print(safe_get(order_data, ["customer", "profile", "contact", "city"]))
# 输出: 杭州

# 场景 2:中间某键缺失
print(safe_get(order_data, ["customer", "address", "zipcode"], default="无邮编"))
# 输出: 无邮编

# 场景 3:中间节点为 None
bad_data = {"customer": {"profile": None}}
print(safe_get(bad_data, ["customer", "profile", "contact", "city"], default="未提供城市"))
# 输出: 未提供城市(安全返回默认值,无任何报错)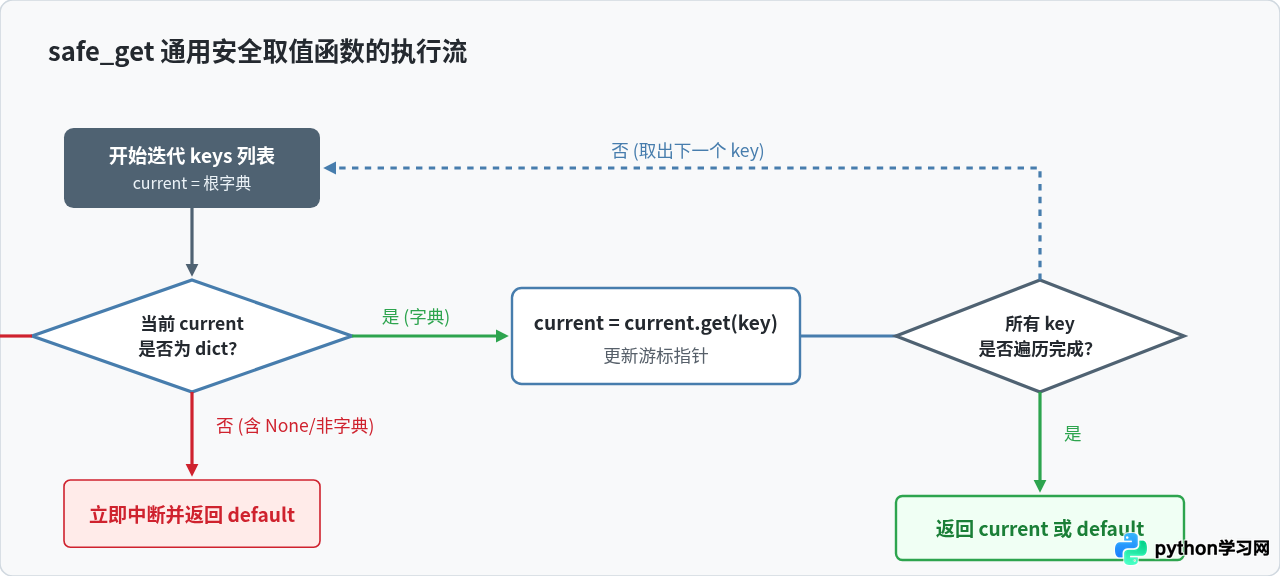
方案三:使用标准库 functools.reduce
如果你希望在不引入第三方依赖的前提下,以非常简练的函数式风格读取深层字段,Python 标准库中的 functools.reduce 是一大利器:
from functools import reduce

keys = ["customer", "profile", "contact", "city"]

# 单行表达式深层获取
result = reduce(lambda d, k: d.get(k, {}) if isinstance(d, dict) else {}, keys, order_data) or "未知城市"
print("提取结果:", result)
在这个表达式中:
reduce将order_data作为初始累加值。- 每次迭代取出路径中的一个键
k。 - 通过三元表达式
d.get(k, {}) if isinstance(d, dict) else {}确保只有在当前节点依然是字典时才调用get(),否则传递一个空字典。 - 最后通过
or "未知城市"提供最终兜底。
方案四:处理字典与列表混合嵌套结构
在实际开发中,很多 JSON 数据不仅包含多层字典,还往往夹杂着数组列表。例如:
company_data = {
    "departments": [
        {
            "dept_name": "研发中心",
            "teams": [
                {"name": "架构组", "lead": "张工"},
                {"name": "算法组", "lead": "王工"}
            ]
        }
    ]
}
如果需要直接通过路径表达式(例如 ["departments", 0, "teams", 1, "lead"])定位节点,我们可以将安全读取函数进一步扩展为同时支持整型下标和字符串键名的解析器:
def deep_query(target, path, default=None):
    """同时支持字典键与列表索引的安全深层取值"""
    cursor = target
    for segment in path:
        if isinstance(cursor, dict) and isinstance(segment, str):
            cursor = cursor.get(segment)
        elif isinstance(cursor, (list, tuple)) and isinstance(segment, int):
            if 0 <= segment < len(cursor):
                cursor = cursor[segment]
            else:
                return default
        else:
            return default
        if cursor is None:
            return default
    return cursor

# 测试字典与列表混合查询
lead_name = deep_query(company_data, ["departments", 0, "teams", 1, "lead"], default="未分配")
print("算法组组长:", lead_name)  # 输出: 王工
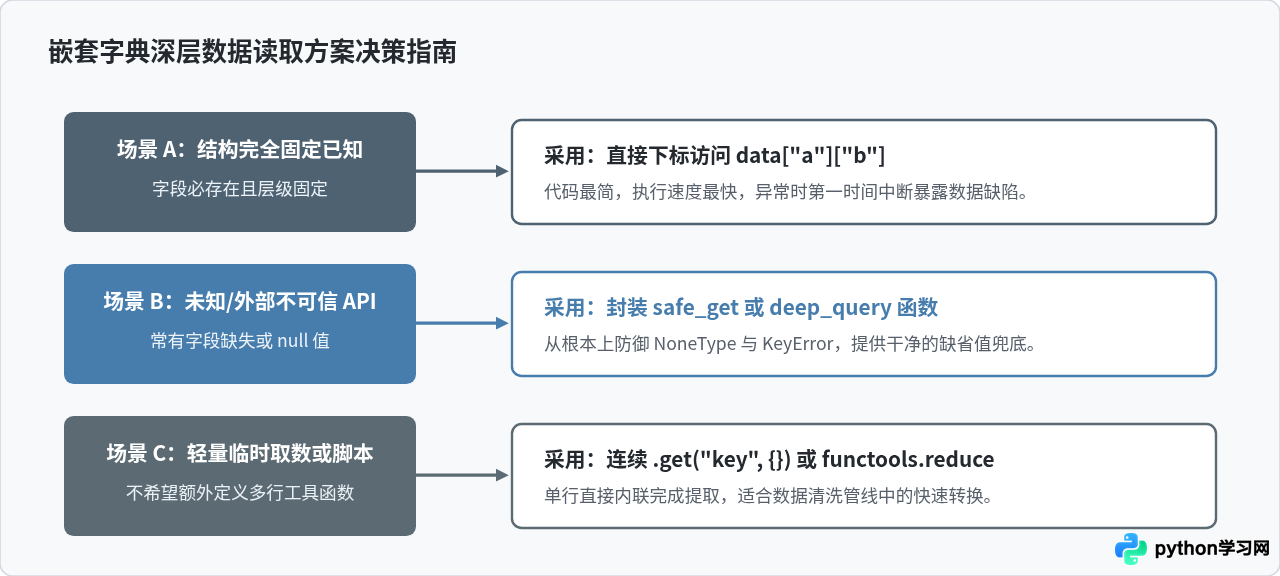
方案对比与选型决策
针对不同的业务场景,选用最适宜的方案可以兼顾代码可读性与执行效率:
| 实现方案 | 依赖说明 | 异常防护能力 | 适用场景建议 |
|---|---|---|---|
| 直接下标 [key1][key2] | 无 | 无防护,遇空抛出 KeyError | 内部结构绝对严苛、字段必选且要求快速暴露数据异常的场景。 |
| 连续 .get().get() | 无 | 基础防护(仅防 KeyError,不防 None) | 层级较浅(2~3层)且确定字段值为非空字典的简单脚本。 |
| 自定义 safe_get 循环 | 无 | 全面防护(防 KeyError、TypeError、None) | 大型项目推荐,逻辑清晰,易于统一错误处理与打桩排查。 |
| functools.reduce | 标准库内置 | 良好(配合 isinstance 防御) | 偏好函数式风格、单行简短表达式且无需混入列表索引的场景。 |
总结与日常开发建议
读取 Python 嵌套字典的深层数据核心在于平衡代码简洁性与容错能力:
- 在编写生产环境的后端服务或爬虫数据解析模块时,不要轻易假定外部响应数据的完整性,应优先使用带有类型校验的
safe_get或统一数据验证库(如 Pydantic)。 - 在内部数据传递且确信结构严谨的局部逻辑中,直接使用方括号访问能最快暴露出数据异常,有利于快速定位上游 Bug。
- 当数据存在列表与字典混排时,规范键路径表达格式,统一封装支持索引迭代的取值工具,能够显著降低代码冗余。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









