

Python中copy.copy()与copy.deepcopy()处理可变对象的区别
详细对比Python中copy.copy()与copy.deepcopy()在处理嵌套列表、字典等可变对象时的底层机制、内存分配差异与实战避坑指南。
假设我们正在开发一个任务调度脚本,其中定义了一个包含默认配置和待处理任务列表的字典模板。当为新任务复制该模板并向子列表中追加新条目时,原模板中的任务列表竟然也跟着被修改了。这种“牵一发而动全身”的意外副作用,正是由于没有分清 copy.copy()(浅拷贝)与 copy.deepcopy()(深拷贝)在处理可变对象时的引用复制机制所导致的。本文将直接切入二者在处理可变对象时的核心区别,结合底层内存指针模型与可复现的代码示例,阐明何时以及如何正确使用深浅拷贝。
一、核心结论:顶层解耦与全层递归的区别
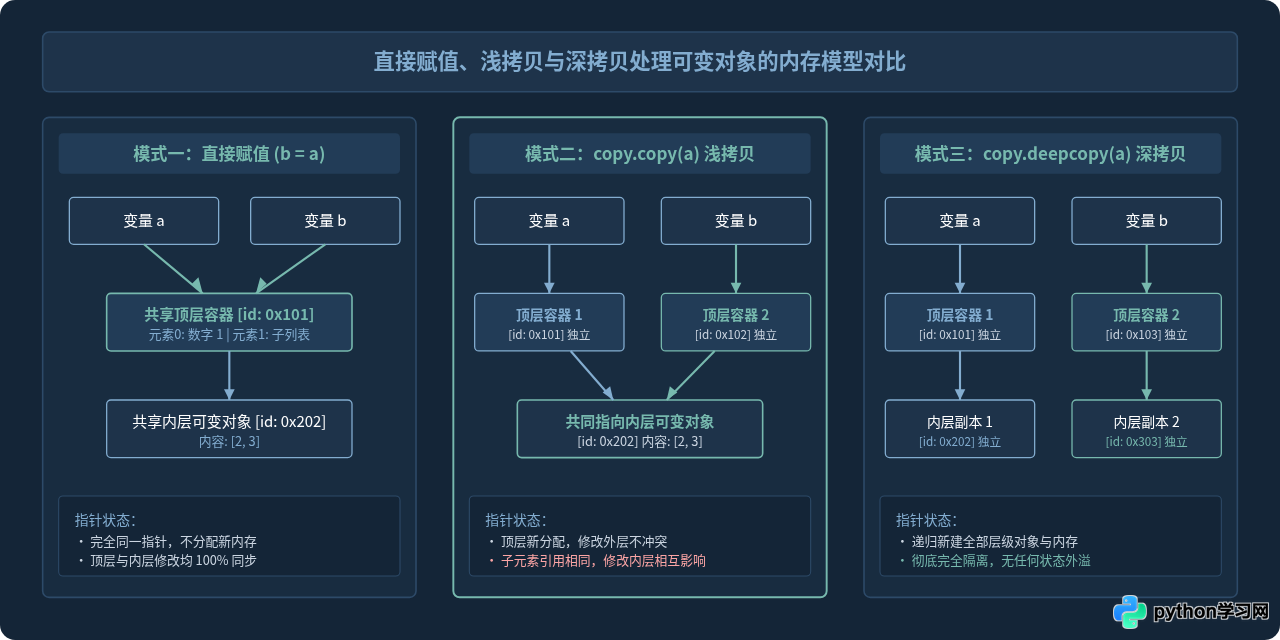
处理 Python 中的复合对象(例如包含列表的字典、二维列表、包含对象属性的类实例)时,区分两者的核心法则如下:
- 直接赋值(
b = a):不创建任何新对象,仅给原内存地址绑定一个新的变量名称。任何可变属性的修改都会在所有变量名下同步呈现。 - 浅拷贝(
copy.copy(a)):构造一个新的顶层容器对象,但不复制容器内部引用的子元素。如果容器内部包含可变对象(如子列表、子字典),新旧容器将依然共享这些子对象的内存地址。 - 深拷贝(
copy.deepcopy(a)):递归地复制容器自身以及它包含的所有各层子对象。无论嵌套结构多么复杂,生成的新对象与原对象完全独立,彼此修改互不干扰。
二、实操推导:分步验证两者的行为差异
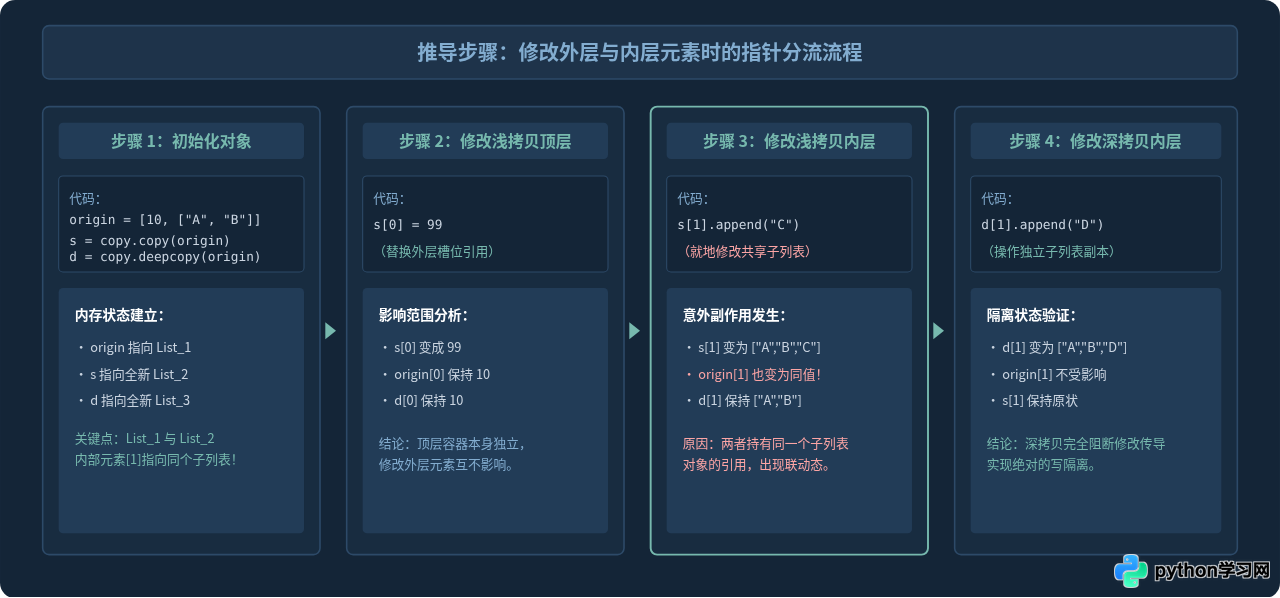
为了直观观察两者的实际行为,我们构造一个典型的嵌套结构:一个包含整型元素和子列表的外层列表。通过系统化的步骤分别修改外层与内层,观察原对象与拷贝对象的值及 id() 地址变化。
import copy

# 初始嵌套可变对象
origin = [10, ["A", "B"]]

# 制作浅拷贝与深拷贝
shallow_obj = copy.copy(origin)
deep_obj = copy.deepcopy(origin)

print(f"原对象外层ID: {id(origin)}, 内层ID: {id(origin[1])}")
print(f"浅拷贝外层ID: {id(shallow_obj)}, 内层ID: {id(shallow_obj[1])}")
print(f"深拷贝外层ID: {id(deep_obj)}, 内层ID: {id(deep_obj[1])}")
执行上述初始检查,我们可以清晰看到:origin 与 shallow_obj 的外层 ID 不同,但 origin[1] 与 shallow_obj[1] 的内层 ID 完全相同;而 deep_obj 的外层和内层 ID 均为全新分配。
测试修改与输出结果
接着运行修改代码并打印各对象当前的数据内容:
# 修改浅拷贝对象的顶层元素与内层列表
shallow_obj[0] = 99
shallow_obj[1].append("C")

# 修改深拷贝对象的内层列表
deep_obj[1].append("D")

print("origin:     ", origin)
print("shallow_obj:", shallow_obj)
print("deep_obj:   ", deep_obj)

# 示例终端输出:
# origin:      [10, ['A', 'B', 'C']]
# shallow_obj: [99, ['A', 'B', 'C']]
# deep_obj:    [10, ['A', 'B', 'D']]
shallow_obj[1] 执行了 append("C"),但 origin[1] 同样出现了 "C"。而 deep_obj[1] 无论如何修改,origin 与 shallow_obj 均毫无感知。
三、深层机制:循环引用与 Memo 备忘录
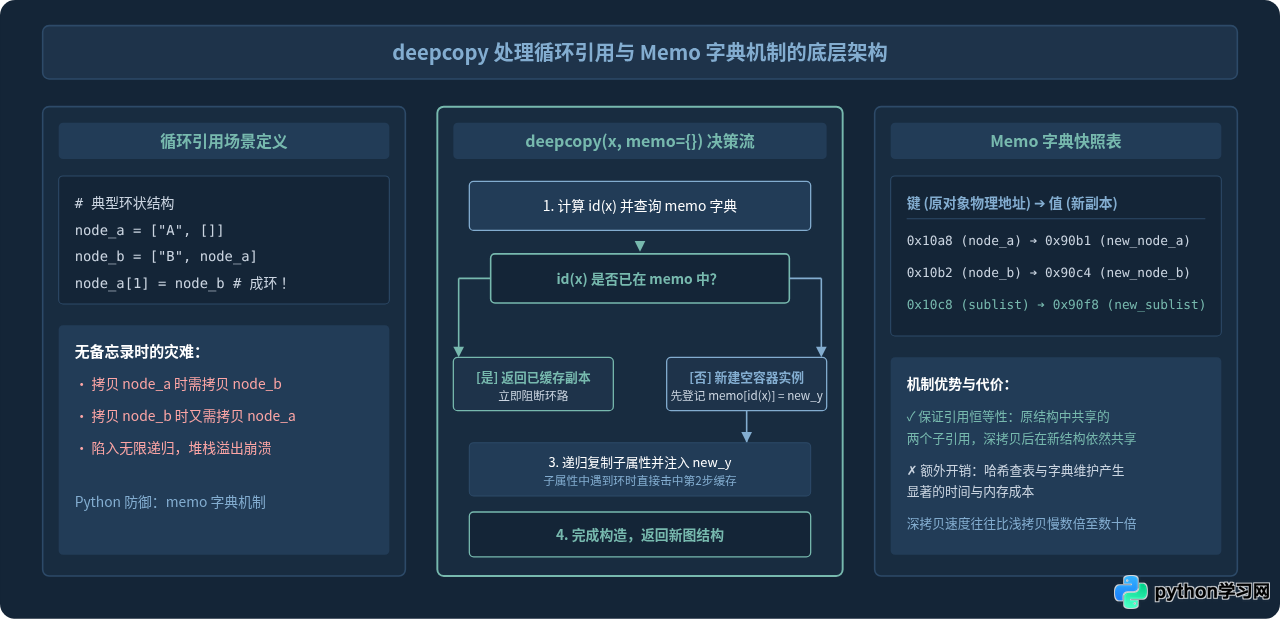
如果对象结构中存在自我引用(例如列表包含自身 a.append(a),或图结构中节点互相关联),普通的递归复制可能会导致栈溢出(RecursionError)。copy.deepcopy() 在底层是如何避免死循环的?
答案是:Memo 备忘录字典。在 deepcopy 执行期间,Python 维护着一个内部映射字典 memo = {},其键为被访问对象的物理地址 id(obj),值为已经创建完成的副本对象引用。处理流程遵循以下严谨步骤:
- 首先检查目标对象的
id(x)是否已经存在于memo中。 - 若已存在,说明该对象已被处理或正在被上层调用复制,直接返回
memo[id(x)],立刻打破环状递归。 - 若不存在,创建该类型的一个未填充实例,立即将
id(x): new_instance记录进memo。 - 随后递归拷贝内部各个属性并填入新实例,最终返回该实例。
四、容易混淆的边界与语法糖陷阱
在实际编码中,很多内置操作看似在“创建副本”,但实际上属于浅拷贝。如果不清楚它们的等价性,极易引发隐蔽的 Bug:
- 列表切片
list_b = list_a[:]:等价于copy.copy(list_a),只拷贝顶层列表。 - 字典的
.copy()方法:也是浅拷贝。嵌套在字典中的列表或二级字典不会被复制。 - 工厂函数
list(list_a)或dict(dict_a):同样是浅拷贝。 - 元组包含可变对象:不可变对象(如元组
t = (1, [2, 3]))本身不能修改指向,但元组内部的列表仍可被修改。对该元组调用copy.copy(t)时,Python 会直接返回原元组的引用(因为元组不可变,没必要新建顶层);但调用copy.deepcopy(t)则会返回包含新独立列表的新元组。
# 元组包含可变对象的典型边界
t_origin = (1, ["apple", "banana"])
t_shallow = copy.copy(t_origin)
t_deep = copy.deepcopy(t_origin)

print("元组浅拷贝是否是原对象:", t_shallow is t_origin)  # True
print("元组深拷贝是否是原对象:", t_deep is t_origin)     # False

# 修改内部列表
t_origin[1].append("orange")
print("浅拷贝元组内列表:", t_shallow[1])  # ['apple', 'banana', 'orange']
print("深拷贝元组内列表:", t_deep[1])     # ['apple', 'banana']
五、工程选型指南与决策流程
深拷贝虽然安全,但其递归遍历与 memo 维护带来了显著的性能损耗。在大型数据结构或高频循环中无节制使用 copy.deepcopy() 会迅速成为性能瓶颈。依据以下决策树选择最适宜的拷贝方式:
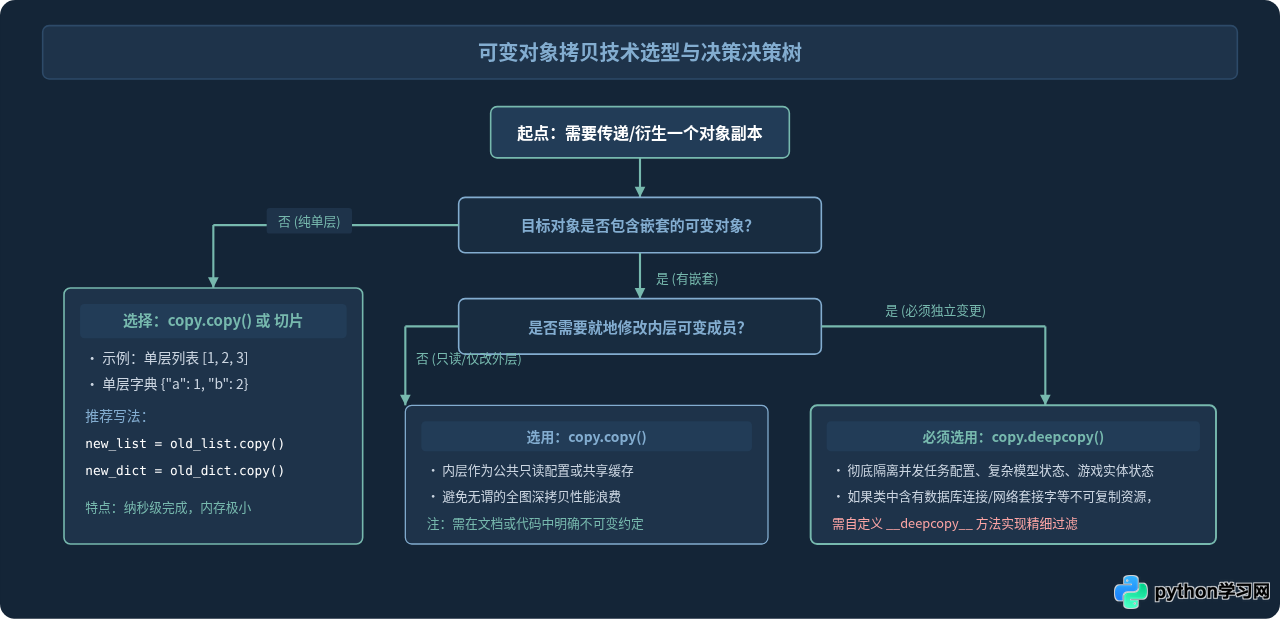
核心技术指标总结对比
| 对比维度 | 直接赋值 (b = a) | 浅拷贝 (copy.copy) | 深拷贝 (copy.deepcopy) |
|---|---|---|---|
| 顶层容器 | 共享同一对象 (id相同) | 创建全新容器 (id不同) | 创建全新容器 (id不同) |
| 嵌套可变元素 | 共享相同引用 | 共享相同引用 (联动风险) | 完全递归创建独立副本 |
| 不可变元素处理 | 共享 | 共享 (数字/字符串/元组) | 不可变对象仍优化共享 |
| 循环引用防御 | 不涉及新建 | 不支持深层检测 | 内置 memo 字典,安全解环 |
| 执行耗时与内存 | 零额外开销 (纳秒级) | 开销极低 (线性于顶层长度) | 开销显著 (线性于全图节点数) |
| 典型应用场景 | 对象别名绑定、参数传递 | 一维列表/字典的日常快照 | 复杂嵌套配置树、状态机备份 |
copy.copy() 还是 copy.deepcopy(),只需回答一个问题:“对象是否存在嵌套层级,且内层可变成员在修改时是否允许波及原对象?”如果需要绝对的修改隔离,深拷贝是唯一的标准保障;而在扁平结构或只读嵌套场景下,优先使用浅拷贝以换取最佳的系统性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









