

Python deep-translator库免API Key快速翻译教程
本教程详细介绍如何使用Python第三方库deep-translator在无需注册申请API Key的情况下,快速调用多翻译服务完成文本、列表及文件的自动化翻译,并提供速率控制与异常处理方案。
deep-translator 是一个开箱即用的解决方案。本文将详细演示如何安装该库、调用支持免 Key 的主流翻译服务引擎,以及在批量文本和文件中处理频控限制与异常。
一、什么是 deep-translator 及其免 Key 工作原理
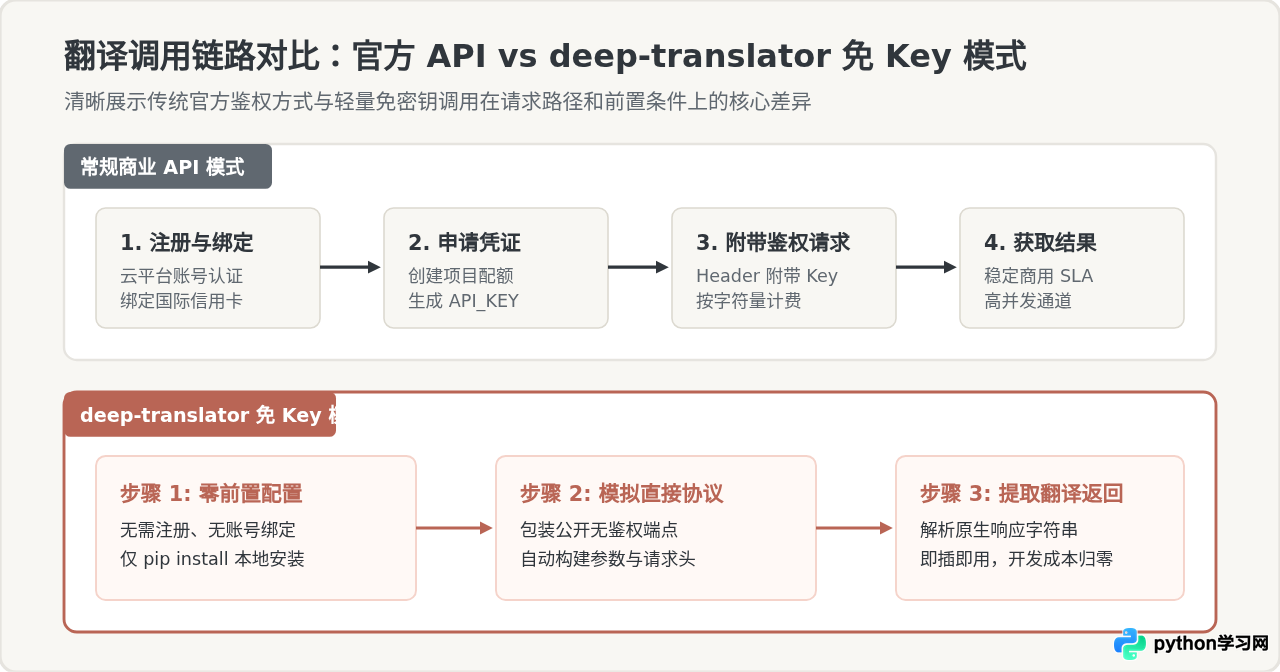
在自然语言处理与爬虫后处理流程中,翻译是常见需求。传统的云服务厂商(如 Google Cloud Translation、DeepL 官方 API、微软 Azure)均要求注册账号、创建项目并生成 API Key,同时通常包含调用配额与按量计费机制。对于个人实验、短期原型开发或小批量数据清洗而言,这一配置成本过高。
deep-translator 是一个灵活封装了多种翻译引擎的 Python 库。它的独特优势在于同时支持“官方带 Key 模式”与“网页抓取/免 Key 开放接口模式”。针对 Google 翻译、MyMemory、PONS、Linguee 等平台,该库通过模拟客户端合法网络请求直接获取翻译文本,使开发者无须预先申请任何开发者凭证即可发起翻译调用。
二、环境安装与基础使用
运行 deep-translator 仅需要标准的 Python 3.7+ 环境。通过官方 PyPI 源直接安装即可:
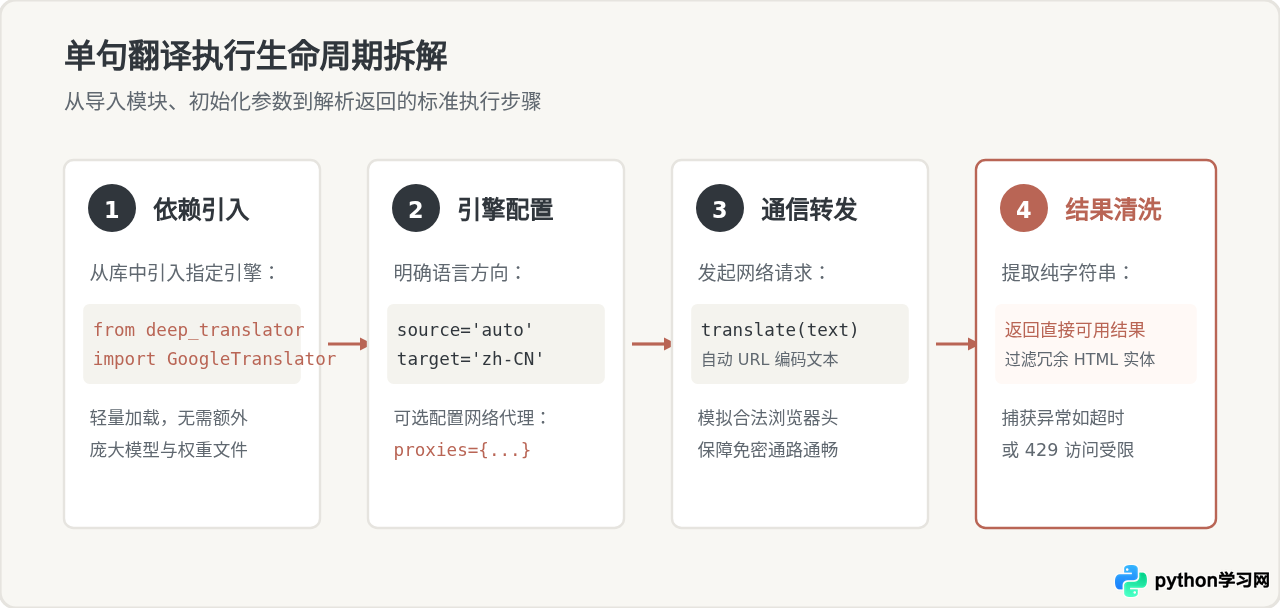
pip install deep-translator安装完成后,可以直接在终端或脚本中导入。下面以使用频率最高且体验最稳定的 GoogleTranslator 为例,展示最简翻译流程:
from deep_translator import GoogleTranslator

# 实例化翻译器:设置源语言为自动检测,目标语言为简体中文
translator = GoogleTranslator(source='auto', target='zh-CN')

text = "Hello world! Deep-translator allows you to translate texts easily without an API key."
result = translator.translate(text)

print("原文:", text)
print("译文:", result)在这段代码中:
source='auto':代表开启语言自动识别,无需提前判断输入语种。target='zh-CN':指定翻译结果的目标语言代码(如简体中文为zh-CN,英文为en,日语为ja)。translate(text):执行实际网络通信并返回清洗后的翻译字符串。
三、查询支持的语言列表
不同引擎所支持的语言代号可能略有差异。为了避免传入错误的语言缩写导致报错,可以通过 get_supported_languages() 方法实时查询:
from deep_translator import GoogleTranslator

# 获取语言名称列表
languages = GoogleTranslator().get_supported_languages()
print(f"支持语言总数: {len(languages)}")
print("部分支持语言示例:", languages[:8])

# 获取名称到代码的完整映射字典
langs_dict = GoogleTranslator().get_supported_languages(as_dict=True)
print("中文代码:", langs_dict.get('chinese (simplified)'))
print("英文代码:", langs_dict.get('english'))
print("西班牙语代码:", langs_dict.get('spanish'))四、多引擎切换:备用免 Key 服务
虽然 GoogleTranslator 翻译质量通常较高,但因为特定网络环境(例如国内直连访问受限)或短期频控,准备备用引擎非常有必要。deep-translator 还提供了以下免 Key 引擎:
| 引擎类名 | 免 Key 额度特点 | 适用场景 | 注意事项 |
|---|---|---|---|
GoogleTranslator |
单次最多 5000 字符 | 通用多语言互译、质量优先 | 中国大陆直连需配置网络代理 |
MyMemoryTranslator |
免 Key 每天 500 词;附带邮箱可达 10,000 词 | 短语、专业词条互译 | 单次翻译较长段落容易被截断 |
PonsTranslator |
欧洲语言辞书权威 | 德语、法语、西班牙语双向学习 | 侧重词汇解释,非长篇文本翻译 |
LingueeTranslator |
双语例句对齐 | 习惯用语与商业术语对照 | 返回多条词条候选项,格式需二次提取 |
使用 MyMemory 引擎的示例
from deep_translator import MyMemoryTranslator

# MyMemory 允许传入邮箱以获得更高的免费请求额度
translator = MyMemoryTranslator(source='en-US', target='zh-CN')
result = translator.translate("Quick brown fox jumps over the lazy dog.")

print("MyMemory 译文:", result)
五、批量翻译与长文本防护策略
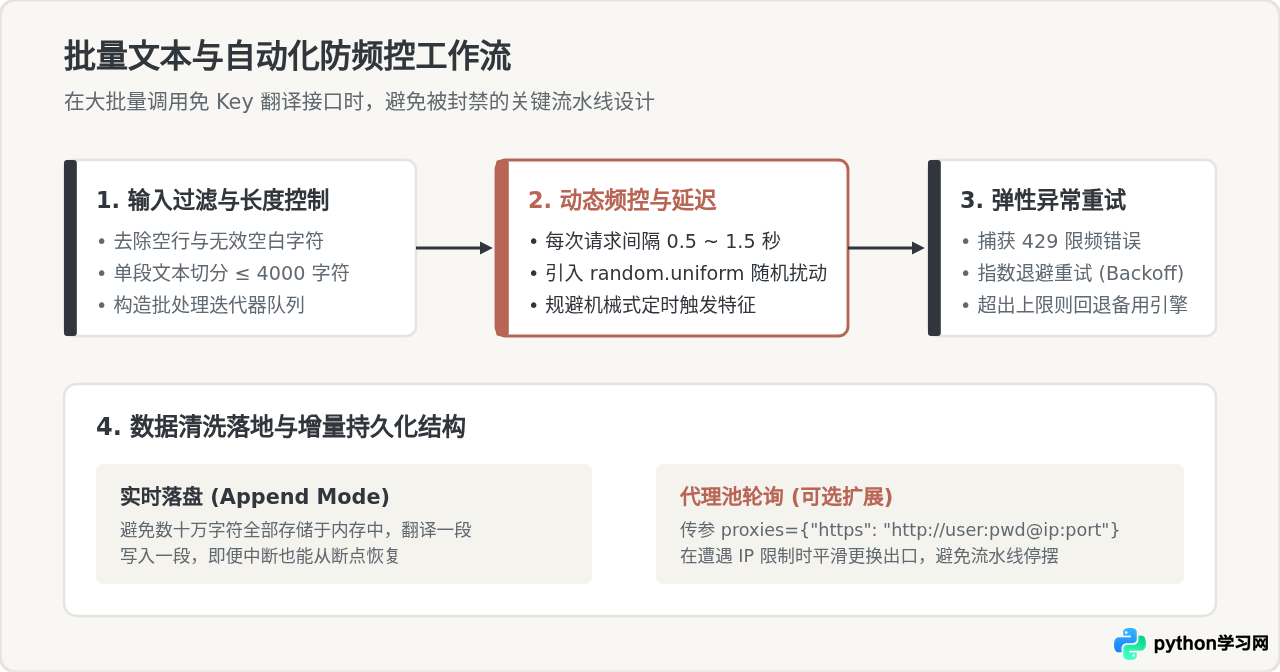
在处理列表数据、爬虫抓取的文章列表或 CSV 表格时,逐行直接循环调用很容易触发服务端的 IP 限频机制(HTTP 429 Too Many Requests)。为了保障任务稳定完成,必须建立“切分 + 延迟 + 代理 + 异常重试”的防护结构。
批量翻译代码实现
GoogleTranslator 自带 translate_batch(list_of_texts) 方法,但对于大量数据,建议结合 time.sleep 手动分块执行:
import time
import random
from deep_translator import GoogleTranslator
from deep_translator.exceptions import TooManyRequests, TranslationNotFound

def safe_batch_translate(text_list, source='auto', target='zh-CN', delay_range=(0.8, 1.5)):
    """
    带有随机频控和异常捕获的稳健批量翻译函数
    """
    translator = GoogleTranslator(source=source, target=target)
    translated_results = []

    for index, text in enumerate(text_list, start=1):
        clean_text = text.strip()
        if not clean_text:
            translated_results.append("")
            continue

        success = False
        retry_count = 0
        max_retries = 3

        while not success and retry_count < max_retries:
            try:
                res = translator.translate(clean_text)
                translated_results.append(res)
                success = True
            except TooManyRequests:
                retry_count += 1
                wait_time = retry_count * 3
                print(f"[警告] 触发频控限制,等待 {wait_time} 秒后进行第 {retry_count} 次重试...")
                time.sleep(wait_time)
            except Exception as e:
                print(f"[错误] 翻译条目 '{clean_text[:15]}...' 时异常: {e}")
                translated_results.append(clean_text) # 发生不可恢复错误时保留原文
                break

        # 正常请求完成后的随机冷却,降低被封禁概率
        time.sleep(random.uniform(*delay_range))

    return translated_results

# 示例数据测试
sample_texts = [
    "Machine learning models require robust preprocessing pipelines.",
    "Fast and reliable translation without credentials is handy.",
    "Rate limits can be mitigated by introducing reasonable delays."
]

results = safe_batch_translate(sample_texts)
for origin, trans in zip(sample_texts, results):
print(f"原: {origin}\n译: {trans}\n")六、本地文本文件直接翻译
deep-translator 还内置了直接翻译纯文本文件的便捷方法 translate_file(),免去了手动使用 open() 读写并拆分文件的过程:
from deep_translator import GoogleTranslator

translator = GoogleTranslator(source='auto', target='zh-CN')

# 直接传入本地文件路径进行全量翻译
# 内部会自动读取文件内容并执行翻译
translated_content = translator.translate_file('data_sample.txt')

with open('data_sample_translated.txt', 'w', encoding='utf-8') as f:
    f.write(translated_content)

print("文件翻译完成并已保存至 data_sample_translated.txt")translate_file 内部仍受制于底层服务的单次请求字符上限(如 Google 约为 5000 字符)。如果文件包含数万字或大篇幅书籍,请先使用行切分或段落切分逻辑分批写入,严禁一次性将大型文件传给 translate_file。
七、网络代理配置方法
在中国大陆本地网络环境下,Google 翻译的免 Key 域名通常无法直接联通,会出现 ConnectionError 或 Timeout。通过在初始化时传入 proxies 参数,可无缝走本地代理客户端:
from deep_translator import GoogleTranslator

# 配置本地代理端口(根据具体科学上网软件的本地监听端口修改)
proxy_config = {
    'http': 'http://127.0.0.1:7890',
    'https': 'http://127.0.0.1:7890'
}

translator = GoogleTranslator(
    source='auto',
    target='zh-CN',
    proxies=proxy_config
)

print(translator.translate("Network proxies allow stable connection."))
八、选型建议与技术避坑总结
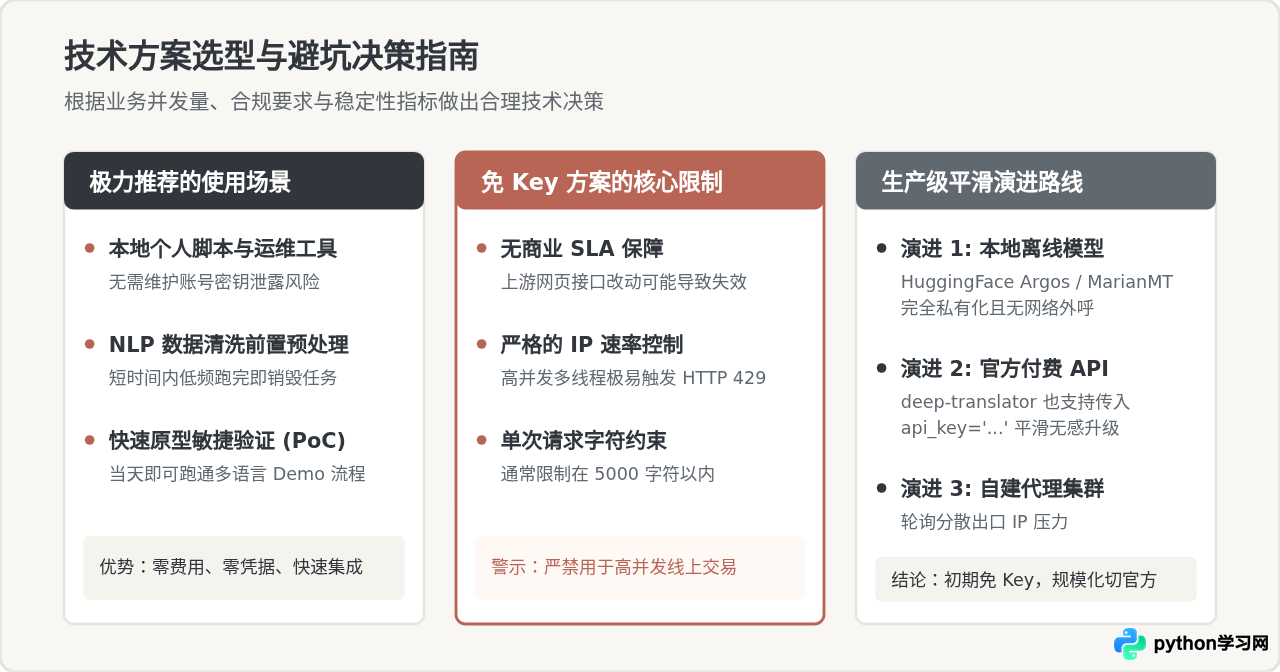
综上所述,deep-translator 是一个在轻量级开发与脚本编写中极其趁手的利器。通过其封装的免 Key 模块,开发者可以在几秒钟内完成高质量的多语言翻译集成。只要在涉及大批量数据时遵循适当的频控延迟、单次长度切分和重试逻辑,就能在免除凭据管理负担的同时,高效完成自动化翻译任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









