

Python生成不重复随机数的代码写法
详细讲解Python中生成不重复随机数的多种代码写法,包括random.sample、random.shuffle、集合去重循环以及NumPy高效抽样的适用场景与注意事项。
假设你正在编写一个在线抽奖程序,需要从100名参与者中一次性抽出5名中奖者,或者在开发问答系统时,需要从题库中随机抽取20道互不相同的题目。在这些场景中,如果简单地在一个循环中调用普通的随机数生成函数,很容易抽到重复的数据。在Python中,生成不重复随机数的核心思路并不是“反复随机并判断是否重复”,而是利用标准库提供的无放回抽样工具或打乱序列。本文将介绍几种最常见、最稳妥的代码实现方式及各自适用的具体场景。
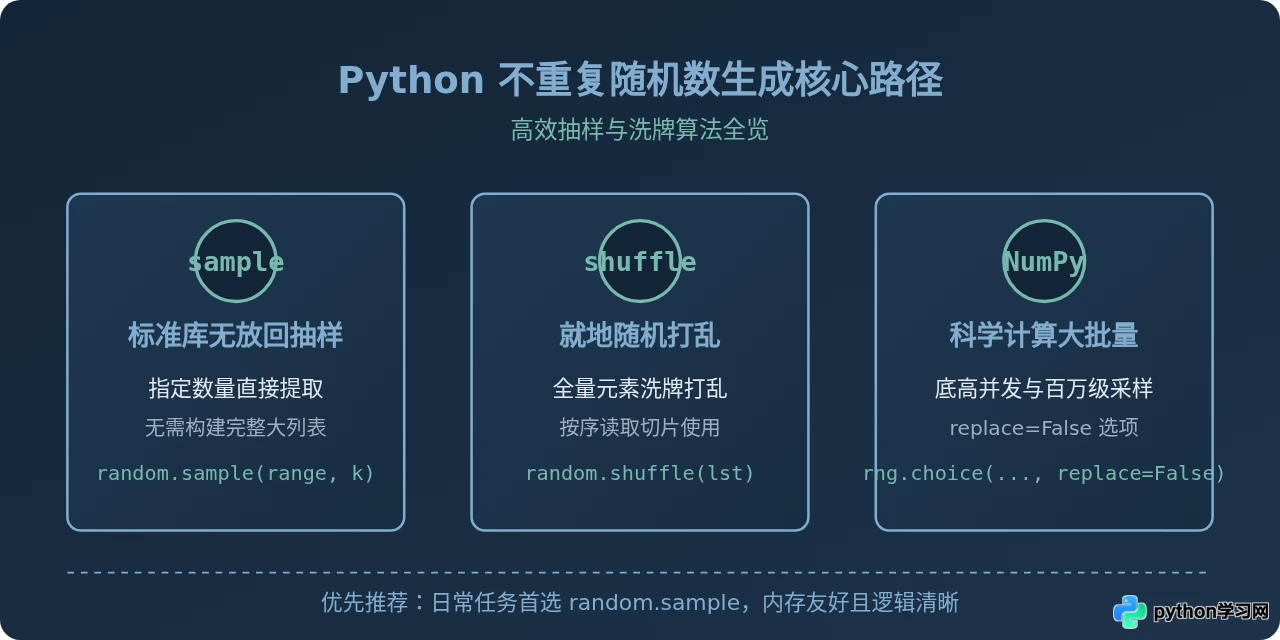
一、最推荐做法:使用 random.sample() 实现无放回抽样
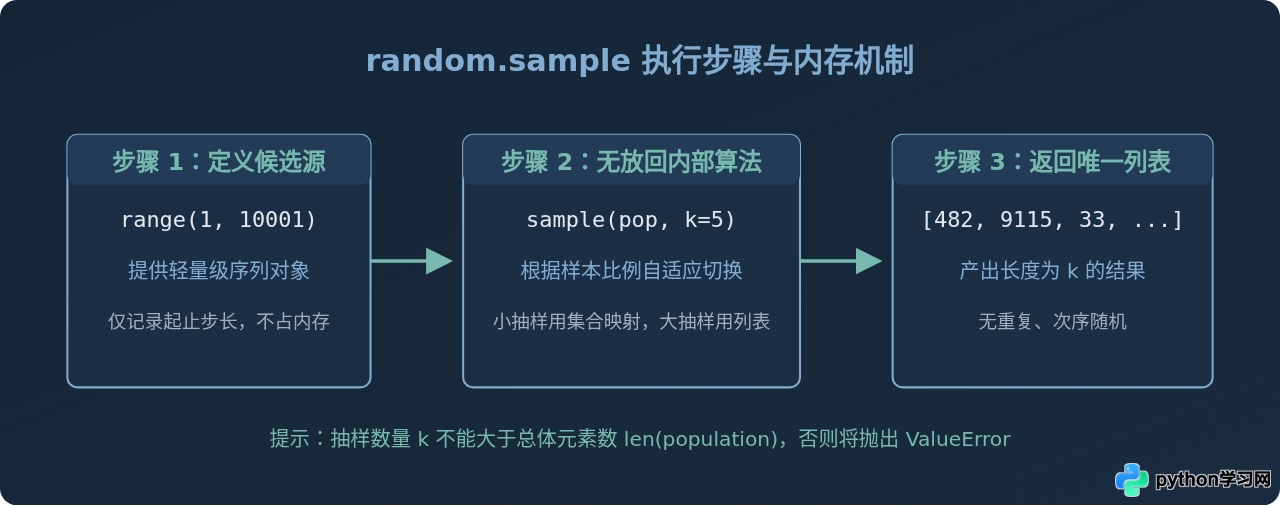
在绝大多数日常开发中,从指定范围或列表中提取一组互不相同的元素,标准库提供的 random.sample() 是最高效、最直观的写法。它直接模拟了“从箱子中逐个拿球且不放回”的过程,从语法层面上杜绝了出现重复项的可能。
1.1 从指定整数范围生成随机数
如果需要在一个数字区间内(例如1到100之间)随机抽取不重复的整数,可以直接将 range() 对象传给 random.sample()。在Python 3中,range() 是惰性求值的序列对象,不会预先在内存中生成包含全部数字的巨大列表,因此非常节省内存。
import random

# 在 1 到 100 之间随机抽取 5 个互不相同的整数
# 注意 range(1, 101) 的右边界是开区间,因此取值范围为 1~100
unique_numbers = random.sample(range(1, 101), 5)

print("生成的结果:", unique_numbers)
示例输出:
生成的结果: [42, 17, 88, 3, 65]这里的返回值是一个标准 Python 列表,其中的5个元素各不相同。调用时需要特别注意第二个参数 k(即抽取个数)不能超过总体候选集合的长度。如果总体只有10个可选数字,却要求抽取15个不重复数值,程序将直接抛出 ValueError: Sample larger than population or negative 异常。
1.2 从已有列表中抽取非数字元素
random.sample() 不仅支持连续数字,还支持任意序列类型(如字符串列表、元组)。其提取规则一致,抽取后的新列表不会修改原有序列的内容。
import random

presents = ["笔记本电脑", "智能手表", "降噪耳机", "机械键盘", "无线鼠标", "护眼台灯"]
# 从6个奖品中抽出2个不重复的奖品
lucky_presents = random.sample(presents, 2)

print("抽选奖品:", lucky_presents)
二、全量洗牌做法:使用 random.shuffle()
如果你已经拥有一个固定的列表,并希望把其中的所有元素打乱顺序,或者打算按顺序逐步取出元素,那么可以使用 random.shuffle()。这种方式好比把一副扑克牌彻底洗乱。
2.1 就地打乱列表顺序
random.shuffle() 是一个就地修改(in-place)函数,它直接改变传入的原列表,其返回值为 None。初学者常犯的错误是将返回值重新赋值给变量(如 lst = random.shuffle(lst)),这会导致原变量变成 None。
import random

# 准备包含 1 到 10 的列表
numbers = list(range(1, 11))

# 执行洗牌操作(直接修改原列表)
random.shuffle(numbers)

print("洗牌后的列表:", numbers)

# 取出前3个作为不重复的随机结果
selected = numbers[:3]
print("截取前3个数值:", selected)
示例输出:
洗牌后的列表: [8, 3, 1, 9, 4, 10, 2, 7, 5, 6]
截取前3个数值: [8, 3, 1]random.sample();若要对已有的固定数据集完整打乱并在后续业务中逐一消费(例如按随机顺序轮流答题),使用 random.shuffle() 更为合适。
三、常见误区:为什么不建议用“while 循环 + set 去重”?
很多初学者在刚接触编程时,往往会自然而然地写出如下代码:每轮用 randint() 生成一个数,放进集合中,直到集合元素个数达到目标值。
# 不推荐的写法(容易引起性能问题)
import random

def bad_generate_unique(n, lower, upper):
    result = set()
    while len(result) < n:
        num = random.randint(lower, upper)
        result.add(num)
return list(result)虽然这种写法在抽样数量极小(如在1~1000中抽3个)时可以正常运行,但它存在严重的潜在缺陷:碰撞率飙升导致的死循环与时间失控。
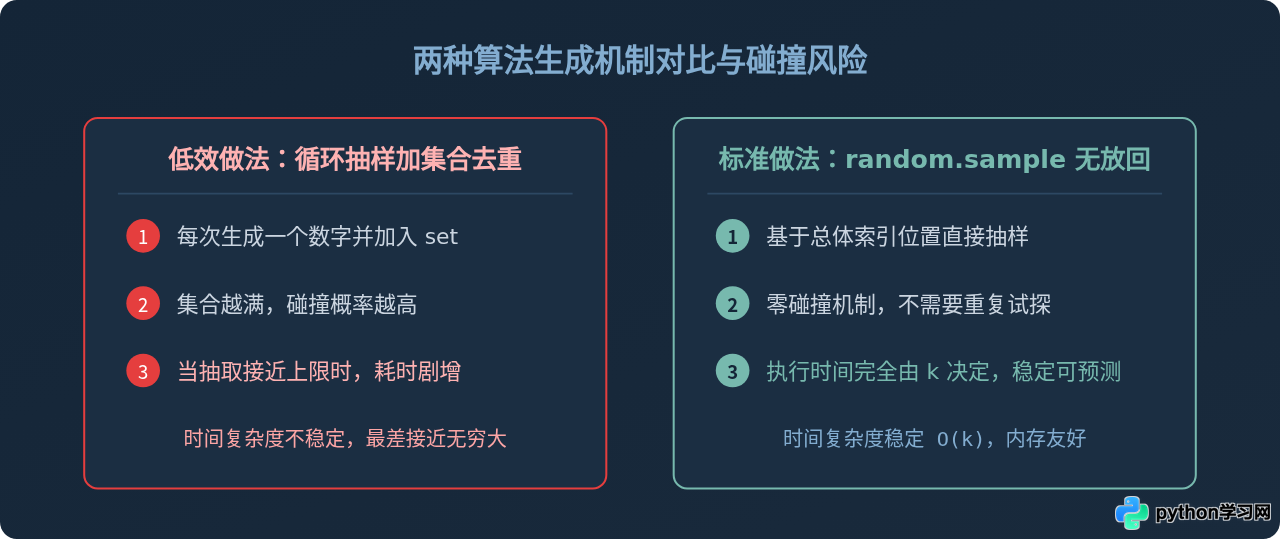
举个极端的例子:假设要在 1 到 100 之间抽取 99 个不重复数字。当集合中已经收集了 98 个数字后,每次循环中随机生成的数字只有 2% 的概率是最后那两个未被抽到的数字,剩余 98% 的抽样都会因为重复而被丢弃。程序会陷入大量的无效循环,导致 CPU 占用率极高甚至卡死。因此,无论在任何业务场景中,都应避免使用 while 循环碰撞的写法。
四、科学计算场景:使用 NumPy 的 Generator
如果你的项目中已经引入了 numpy,或者需要生成数以万计甚至百万量级的不重复随机数,使用标准库的 random.sample() 速度会相对较慢。NumPy 的底层 C 语言实现能提供数十倍的性能优势。
在现代 NumPy(1.17 及以上版本)中,推荐使用 default_rng() 创建随机数生成器,并通过设置 replace=False 来实现无放回抽样:
import numpy as np

# 建立推荐的独立随机数生成器
rng = np.random.default_rng()

# 在 0 到 999 之间抽取 10 个互不相同的整数
# replace=False 表示不重复抽取(无放回)
samples = rng.choice(1000, size=10, replace=False)

print("NumPy 生成结果:", samples)
示例输出:
NumPy 生成结果: [419 122 890 231 45 678 312 904 551 88]rng.choice() 返回的是一个 ndarray 数组。在处理大规模机器学习特征采样、矩阵洗牌或数值模拟时,这种写法的执行效率极高,内存分配也更加紧凑。
五、安全性需求:使用 secrets 模块
需要明确的是,Python 内置的 random 模块和 NumPy 使用的都是伪随机数算法(如 Mersenne Twister)。它们的生成序列在数学上是可被预测的。如果你的不重复随机数用于敏感的安全业务(如生成一次性随机密码验证码、安全令牌 Token 或抽奖券唯一兑换码),绝不能使用 random.sample()。
标准库的 secrets 模块提供了基于操作系统熵源的密码学安全随机数。尽管 secrets 模块没有直接提供类似于 sample 的批量方法,但可以通过组合系统随机源实现安全抽样:
import secrets

# 安全随机抽样示例
def secure_unique_sample(population, k):
    pop_list = list(population)
    if k > len(pop_list):
        raise ValueError("抽样数量超出候选范围")

    # 模拟无放回抽样过程
    selected = []
    for _ in range(k):
        # 使用 secrets.randbelow 安全选取索引
        idx = secrets.randbelow(len(pop_list))
        # 弹出该元素,确保后续不会被重复抽中
        selected.append(pop_list.pop(idx))
    return selected

# 安全抽取 4 个不重复认证码片段
token_parts = secure_unique_sample(range(1000, 9999), 4)
print("安全抽样结果:", token_parts)
六、各方案适用场景与选型总结
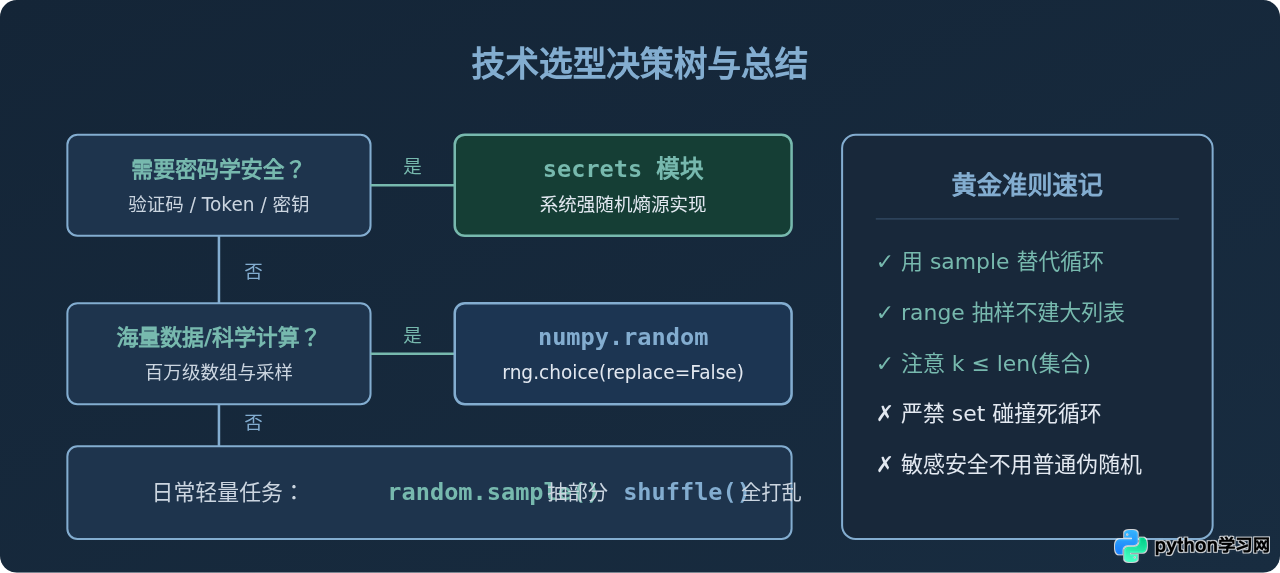
根据不同的业务需求与数据规模,选择最匹配的技术方案能够兼顾代码可读性与系统运行性能。下表和图表总结了各方案的核心差异:
- 小规模日常业务(抽取个数 < 100,000):首选
random.sample(range(...), k),代码简洁,标准库内置,无需安装第三方依赖。 - 固定列表全局打乱:使用
random.shuffle(lst),直接修改原列表,适合扑克牌洗牌、轮播展示等业务。 - 海量数据与矩阵运算:使用
numpy.random.default_rng().choice(..., replace=False),底层优化充分,运行速度最快。 - 密码学与认证安全:结合
secrets模块进行无放回抽取,防止随机序列被反推。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









