

主流Python ORM框架的多数据库兼容性分析与迁移成本

深入分析主流Python ORM框架(SQLAlchemy、Django ORM、Tortoise ORM、Peewee)在PostgreSQL、MySQL、SQLite等数据库间的兼容性差异、方言陷阱、架构抽象层与真实迁移成本。
在Python后端研发中,“更换底层数据库”常被视作只需调整数据库连接串(Connection String)的简单任务。然而在实际工程场景中,从SQLite或MySQL迁移至PostgreSQL,抑或进行信创改造转入达梦、人大金仓等国产关系型数据库时,开发团队往往会遭遇大量非预期的阻碍。本文将围绕SQLAlchemy、Django ORM、Tortoise ORM与Peewee四大主流Python ORM,深入解析它们在多数据库支持架构上的底层差异、方言层特有陷阱,并给出量化的迁移成本评估与全流程实施指南。
一、主流Python ORM的多数据库架构与方言层解析
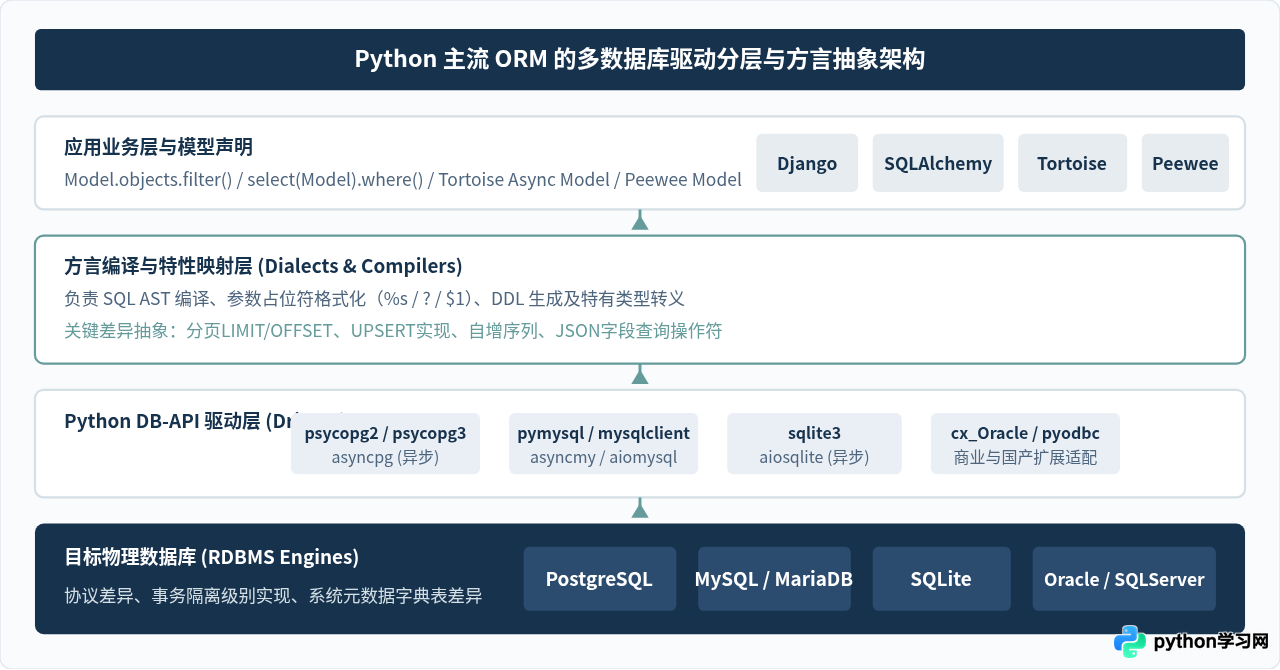
ORM框架实现多数据库兼容的核心,在于将通用的面向对象查询表达解耦为具体的底层SQL语句。不同ORM在此分层设计上有着截然不同的哲学与完备度。
- SQLAlchemy 2.0:采用高度模块化的“Core + Dialect + DB-API”三层解耦架构。SQLAlchemy将AST语法树构建与具体引擎的方言(Dialect)彻底分离,对PostgreSQL、MySQL、SQLite、Oracle及Microsoft SQL Server均提供第一梯队支持,驱动生态极为完备(同步支持psycopg2/3、pymysql,异步支持asyncpg、asyncmy等)。
- Django ORM:深度集成于Django全栈生态,通过
django.db.backends内置针对PostgreSQL、MySQL、SQLite和Oracle的后端适配器。其设计哲学偏向“寻找最大公约数”,虽然提供了跨数据库的一致性ORM API,但在暴露数据库专有高级特性时相对克制(仅对PostgreSQL开放了详尽的contrib.postgres扩展)。 - Tortoise ORM:作为受Django API启发的现代化异步ORM,其底层依赖Pypika进行SQL构建,目前官方主要支持PostgreSQL(asyncpg)、MySQL(aiomysql/asyncmy)和SQLite(aiosqlite)。其方言层深度有限,遇到复杂DDL或非标SQL扩展时灵活性稍逊。
- Peewee:轻量级同步ORM,通过简洁的Database类及子类(PostgresqlDatabase、MySQLDatabase、SqliteDatabase)进行方言管理,体量极小,非常适合轻量级微服务及嵌入式工具,但在复杂方言扩展及分布式事务支持上功能较弱。
二、多数据库方言差异与跨库踩坑全景
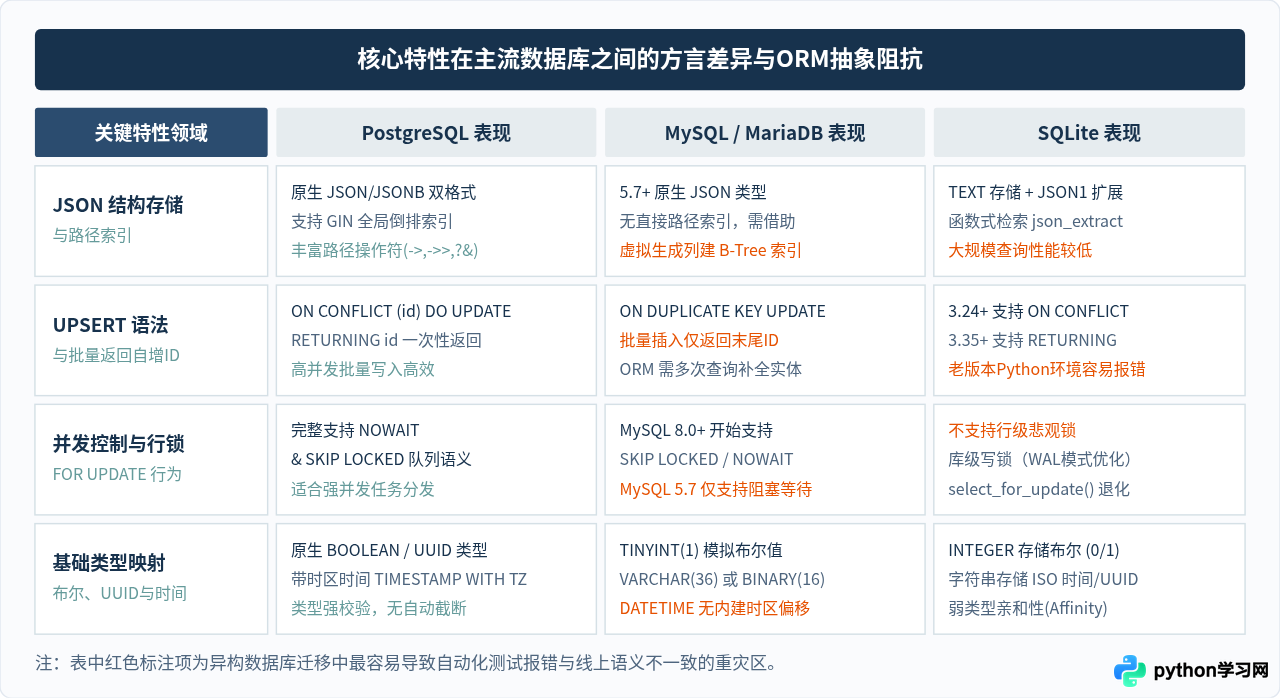
虽然ORM隐藏了基础的SELECT、INSERT语法,但在涉及特殊数据类型、锁机制、批量操作与自增序列时,底层数据库行为的异构性会直接穿透ORM层引发线上故障。
1. JSON字段支持与查询路径差异
PostgreSQL拥有原生的JSONB类型,支持GIN索引及高效的路径解构查询(->、->>、?等操作符)。MySQL(5.7+)虽然支持JSON类型,但底层不支持直接创建路径级GIN索引,只能通过虚拟生成列(Generated Column)间接索引。而SQLite通过JSON1扩展提供支持,通常以纯文本形式存储并利用函数解析。当代码中混用了特定方言语法时,ORM无法自动进行跨库平滑转换。
# SQLAlchemy中跨库兼容与特有方言的定义对比示例
from sqlalchemy import Column, Integer, String
from sqlalchemy.types import JSON
from sqlalchemy.dialects.postgresql import JSONB

class AuditLog(Base):
    __tablename__ = "audit_log"
    id = Column(Integer, primary_key=True)

    # 做法A(跨库友好):使用通用JSON,各方言编译为对应类型(MySQL JSON, PG JSON)
    payload_generic = Column(JSON)

    # 做法B(方言绑定):显式依赖PG特有的JSONB,迁移到MySQL或SQLite时必须改动代码
    # payload_pg = Column(JSONB)
2. 主键自增、UUID与序列机制
MySQL通过AUTO_INCREMENT属性维护表级单自增列,而PostgreSQL依赖底层的SEQUENCE序列(或标准SQL的IDENTITY)。这意味着在批量插入时,PostgreSQL支持原生的RETURNING id一次性拿回所有生成主键,而MySQL官方DB-API在批量插入时只能返回最后插入的那一条主键ID,导致ORM在此处的批量模型实例化逻辑产生性能分裂。
3. UPSERT(存在即更新)语义冲突
在高并发数据汇聚场景下,UPSERT是常用机制。然而:
- PostgreSQL / SQLite 3.24+:采用SQL标准标准语法
ON CONFLICT (target) DO UPDATE SET ...。 - MySQL:采用特有语法
ON DUPLICATE KEY UPDATE ...。
Django原生ORM直到4.1版本才通过bulk_create(..., update_conflicts=True)对两类语法进行统一抹平;若此前开发者在老版本中手动拼接了方言特有的raw SQL或扩展包,在迁移数据库时将面临直接的语法崩溃。
三、数据库迁移标准实施工作流
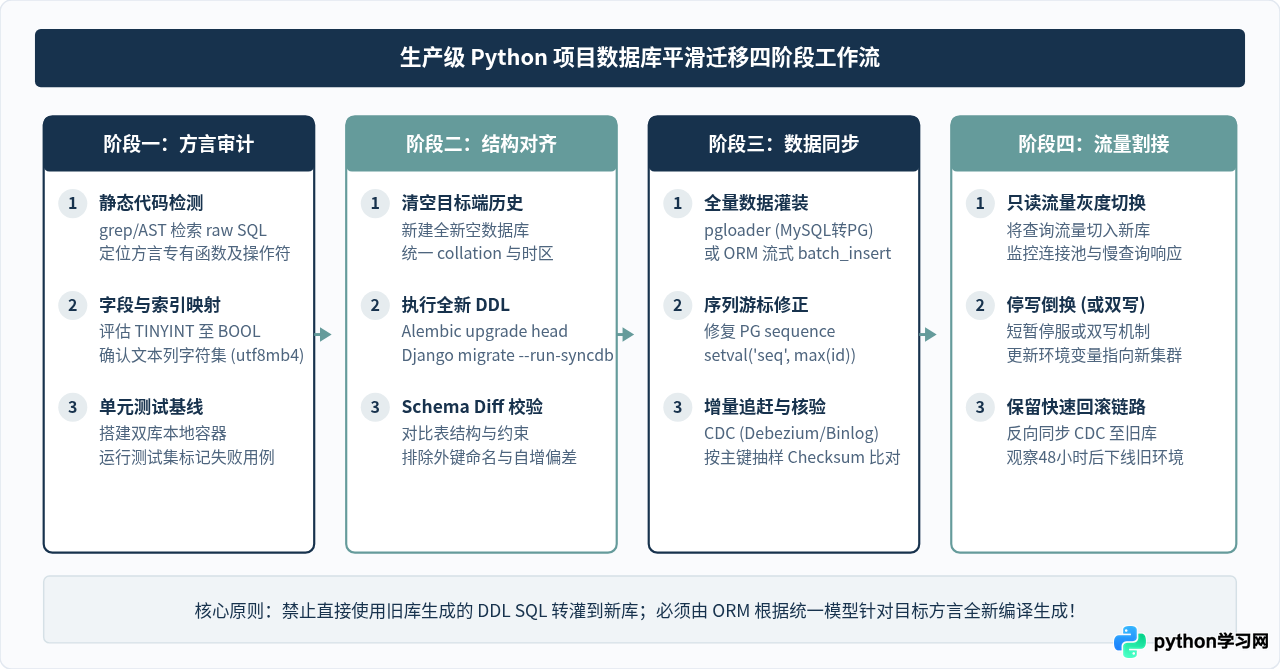
数据库迁移绝非简单的导出与导入数据,必须遵循严密的工程阶段。从模型静态审计、迁移工具(Alembic / Django Migrations / Aerich)适配,到全量和增量数据割接,每个环节都需要自动化工具与预案保障。
迁移执行的关键实操步骤与代码片段
id可能已经达到100000,但底层默认序列tablename_id_seq游标仍停留在1。在迁移后首次调用ORM进行INSERT操作时,PostgreSQL会尝试赋予id=1,立刻抛出UniqueViolation: duplicate key value violates unique constraint。
-- 在数据全量灌装到 PostgreSQL 完成后,必须执行修复序列的 SQL
SELECT setval(
    pg_get_serial_sequence('users_user', 'id'),
    COALESCE(max(id), 1) + 1,
    false
) FROM users_user;对于SQLAlchemy体系,推荐使用Alembic的env.py做多环境动态驱动注入。在不同数据库下,避免在alembic/versions/脚本中直接嵌入原生SQL,而应优先使用Alembic的op.create_table()标准操作算子:
# alembic/versions/xxxx_init.py 跨库兼容的DDL脚本写法
from alembic import op
import sqlalchemy as sa

def upgrade():
    op.create_table(
        'project',
        sa.Column('id', sa.Integer(), nullable=False),
        sa.Column('name', sa.String(length=128), nullable=False),
        # 使用通用Boolean类型,Alembic在PG下生成BOOLEAN,在MySQL下生成TINYINT(1)
        sa.Column('is_active', sa.Boolean(), server_default=sa.text('1'), nullable=False),
        sa.PrimaryKeyConstraint('id')
    )
四、各ORM多库适配度与迁移成本综合量化分析
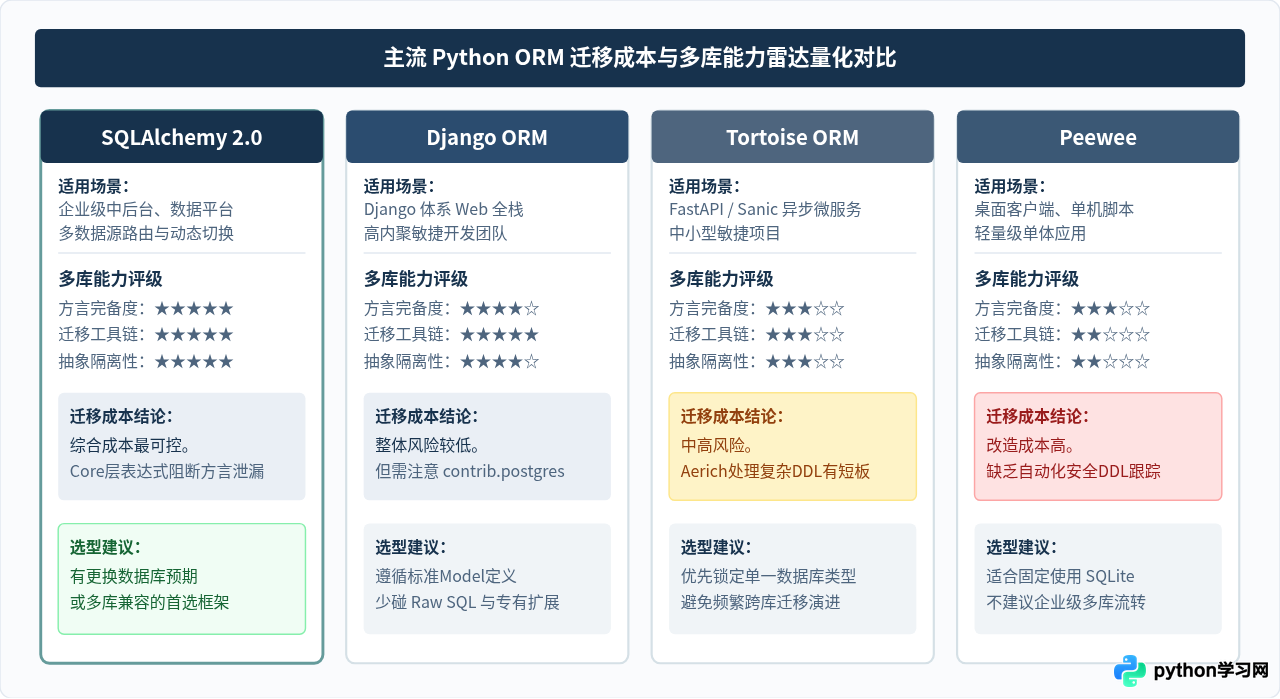
评估跨数据库迁移的技术成本,通常需要考量代码改造成本、方言依赖阻抗、Schema管理工具能力以及排障周期。下表对主流ORM在实际工程中的表现进行了多维度评分(满分5星):
| ORM框架 | 方言完备度 | 原生迁移工具成熟度 | 原生SQL依赖解耦度 | 异步驱动成熟度 | 异构数据库迁移综合成本 |
|---|---|---|---|---|---|
| SQLAlchemy 2.0 | ★★★★★ (极其完备) | ★★★★★ (Alembic 标杆) | ★★★★★ (AST表达式完备) | ★★★★★ (主流引擎全覆盖) | 较低(规范编写下改动最少) |
| Django ORM | ★★★★☆ (主打PG/MySQL) | ★★★★★ (Django内置Migration) | ★★★☆☆ (较依赖框架习惯) | ★★★☆☆ (异步ORM尚处渐进演进) | 中等(若无PG专有字段迁移平滑) |
| Tortoise ORM | ★★★☆☆ (仅主流3款引擎) | ★★★☆☆ (Aerich仍在演进) | ★★★☆☆ (复杂SQL能力较弱) | ★★★★★ (纯异步优先设计) | 中高(冷门方言不支持,工具链偏嫩) |
| Peewee | ★★★☆☆ (小而精,轻量方言) | ★★☆☆☆ (简易迁移工具pw_migrate) | ★★☆☆☆ (缺乏复杂编译隔离) | ★★☆☆☆ (需配合peewee-async) | 较高(需大量手动调整DDL与脚本) |
五、降低跨库迁移成本的最佳工程实践
为了在项目生命周期中保留切换或兼容多数据库的弹性,研发团队应在开发初期确立以下工程防御机制:
- 收敛Raw SQL与方言专有函数:在必须使用数据库特殊算子(如全文检索、空间GIS计算)时,应通过Repository模式隔离,或通过ORM层自定义编译钩子(如SQLAlchemy的
@compiles装饰器)分别针对不同方言提供回退实现。 - 坚持“单一Model元数据驱动”迁移:严禁手写针对特定引擎的SQL迁移文件。始终使用Alembic或Django Migrations从Model类派生DDL变更,并在CI/CD流水线中配置目标数据库容器进行自动化测试跑批。
- 慎用非标准隐式类型转换:MySQL对字符串和数值类型在比较时存在宽松隐式转换,而PostgreSQL属于强类型系统(如将字符串传入UUID或枚举字段将直接报错中止事务)。在ORM模型定义中必须明确指定类型长度、Nullable属性与时区定义。
- 提前规避锁机制与隔离级别假设:从MySQL切换到PostgreSQL时,注意默认事务隔离级别差异(MySQL为Repeatable Read,PostgreSQL为Read Committed),并核对行锁等待超时参数,避免生产环境发生死锁风暴。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









