

Python pathlib模块读取文件详解:read_text与read_bytes用法
详细讲解 Python pathlib 模块中 read_text 与 read_bytes 方法的核心用法、参数配置、底层机制、异常防护及适用场景,配有完整代码示例与图解。
在 Python 3.4 引入 pathlib 模块后,面向对象的文件与路径操作逐渐成为标准做法。读取文件内容时,传统方式通常依赖 with open(...) as f: 上下文管理器,而 Path.read_text() 与 Path.read_bytes() 则提供了更加紧凑、直观的一行式读取方案。本文将详细解析这两个方法的工作原理、调用参数、异常防护策略及各自的性能边界,帮助开发者在实际工程中做出恰当的技术选型。
一、pathlib 读取文件的核心设计理念
传统的内置 open() 函数需要先将文件路径传给函数,返回文件句柄对象,再调用句柄上的读取方法,最后依靠 with 语句显式退出块以关闭文件。与之相比,pathlib.Path 将路径视为具备丰富操作能力的对象,把“路径指向的目标实体”与“对该实体的常见读写操作”直接绑定在了一起。
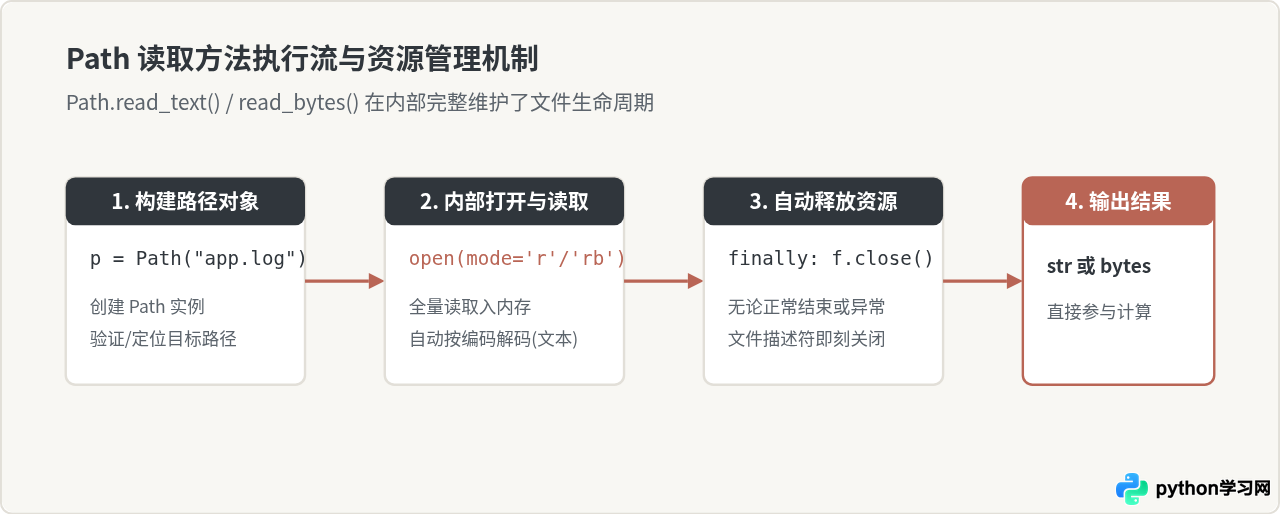
read_text() 和 read_bytes() 属于典型的高层封装便捷方法(Convenience Methods)。它们内部封装了 open()、调用底层读取并自动在 finally 块中保证文件流的关闭,避免了资源句柄泄露的风险。这种设计大幅精简了小文件读取的代码量,使逻辑更加聚焦。
二、Path.read_text() 详解与实操
read_text() 用于以文本模式打开并读取文件,其返回值是字符串 str。在日常处理 JSON 配置文件、Markdown 笔记、日志文本和 CSV 时,它是使用最广泛的方法。
1. 方法签名与核心参数
Path.read_text(encoding=None, errors=None)- encoding(字符编码):指定用于将文件中的原始字节流解码为字符串的编码标准。在跨平台运行的代码中,强烈建议显式指定
encoding='utf-8'。如果不传递该参数,Python 会调用locale.getpreferredencoding(False)获取系统默认编码;在 Windows 简体中文版下,默认通常为cp936(GBK),而在 Linux/macOS 下为utf-8,不加声明极易引发跨平台解码故障。 - errors(错误处理策略):指定当遇到无法按照
encoding解码的非法字节序列时的行为。常见可选值包括:'strict'(默认):抛出UnicodeDecodeError异常;'ignore':静默跳过无法解析的非法字符;'replace':使用官方替换字符(如 Unicode 替换符�)占位;'backslashreplace':将非法字节转义为十六进制反斜杠转义串。
2. 典型使用代码示例
from pathlib import Path

# 示例:安全读取 UTF-8 编码的配置文件
config_path = Path("config.ini")

try:
    content = config_path.read_text(encoding="utf-8")
    print(f"成功读取文件,字符总数: {len(content)}")
    print("--- 文件前100字符预览 ---")
    print(content[:100])
except FileNotFoundError:
    print(f"错误:目标文件不存在 -> {config_path}")
except UnicodeDecodeError as err:
    print(f"解码失败,请确认文件实际编码是否匹配: {err}")
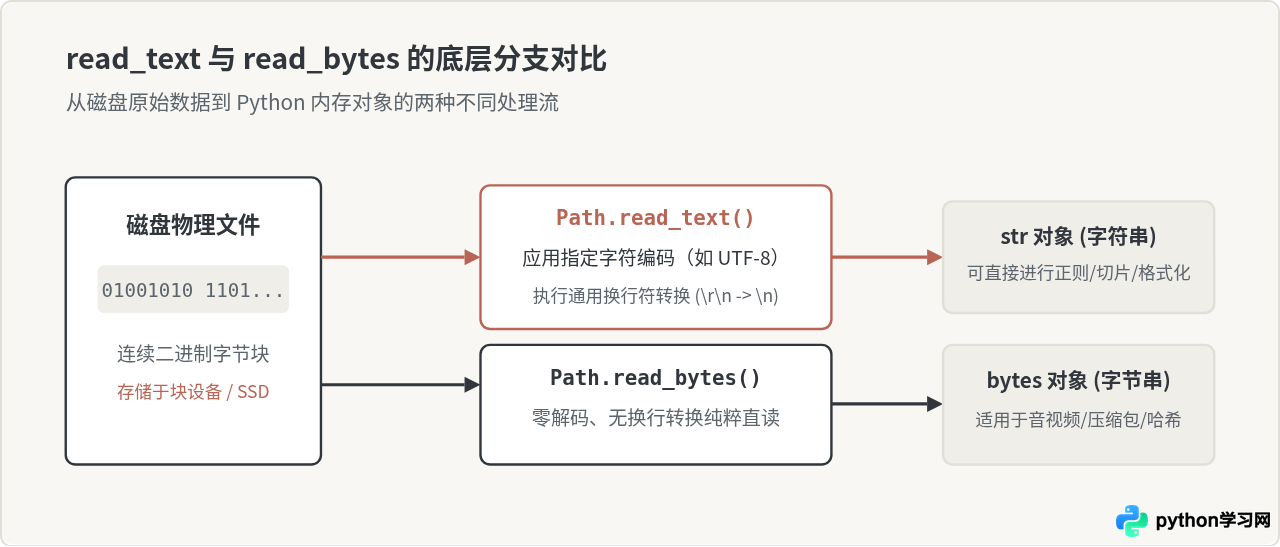
注意:Path.read_text() 不提供 newline 参数。如果文件是在 Windows 系统下生成的 CRLF 换行符(\r\n),在文本模式读取时,Python 的通用换行符机制会自动将其统一转换为标准的 \n。
三、Path.read_bytes() 详解与实操
与文本方法对应,read_bytes() 以二进制只读模式(底层对应 rb)打开目标文件,直接返回未经解码的原始字节流 bytes 对象。
1. 方法签名与特性
Path.read_bytes()read_bytes() 没有任何参数。它的优势在于执行路径极为纯粹:不经过字符集解码器,不进行任何换行符转换,忠实呈现磁盘上存储的原始二进制字节序列。
2. 典型适用场景
- 多媒体与二进制资产处理:直接读取 PNG、JPEG、WebP 图片,音视频片段或 PDF 文档。
- 哈希校验与数字签名:配合
hashlib模块计算文件的 MD5、SHA-256 指纹。 - 对象反序列化与缓存:直接配合
pickle.loads()、msgpack.unpackb()或 Protobuf 解析数据。 - 编码自动探测:读取文件头部若干字节,判断文件的 BOM 标记或传给
chardet分析其实际编码。
import hashlib
from pathlib import Path

# 示例:计算指定固件或可执行文件的 SHA-256 校验和
bin_path = Path("firmware.bin")

if bin_path.exists():
    raw_data = bin_path.read_bytes()
    file_hash = hashlib.sha256(raw_data).hexdigest()
    print(f"文件名: {bin_path.name}")
    print(f"文件大小: {len(raw_data)} 字节")
    print(f"SHA-256: {file_hash}")
else:
    print(f"文件未就绪: {bin_path}")
四、异常处理与防护规范
虽然快捷方法简化了代码,但依然直接受制于操作系统的文件系统权限与 IO 异常。在编写生产环境代码时,必须对以下潜在异常建立妥善的处理机制:
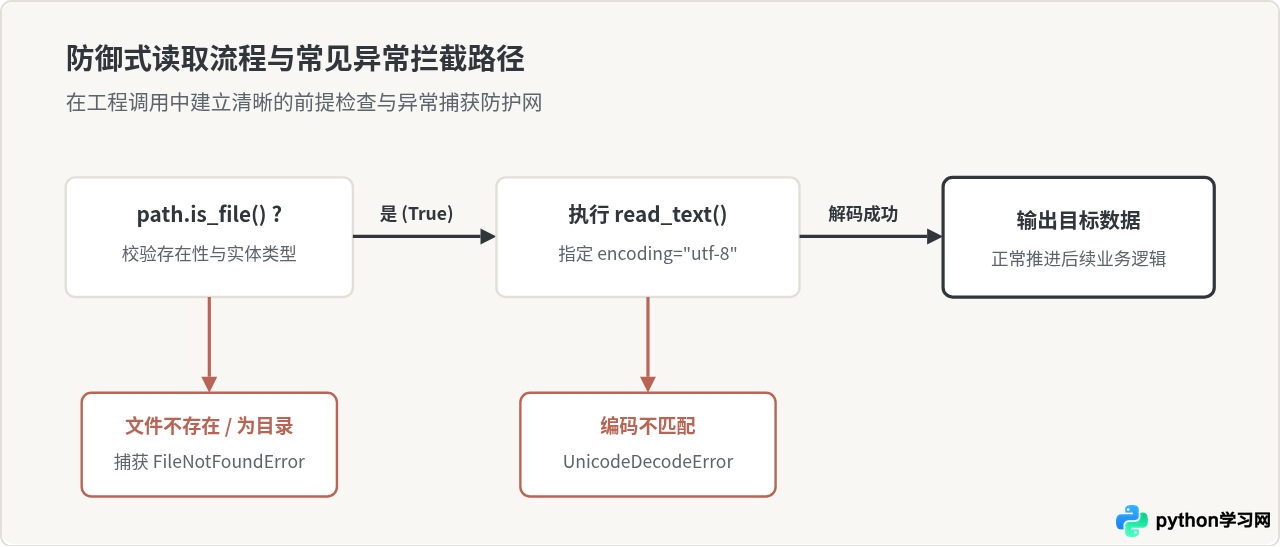
FileNotFoundError:目标路径不存在或目标指向一个失效的软链接。在调用读取前,可通过path.is_file()确认文件存在且确属常规文件。PermissionError:当前进程缺乏对文件的只读权限,或目标路径实际是一个目录而非文件。IsADirectoryError:尝试对目录路径直接执行read_text()或read_bytes()。UnicodeDecodeError:仅发生于read_text(),表明文本字节流中存在与指定encoding冲突的非法序列。
五、适用边界与性能考量:何时不应使用快捷方法?
read_text() 和 read_bytes() 的易用性建立在一个关键前提之上:将文件全部内容一次性载入内存。对于中小型文件(如几 KB 到几十 MB),现代计算机的内存充裕,全量加载速度极快,开销完全可控。
然而,当面对以下场景时,应当避免使用这两个快捷方法:
- 超大日志文件或数据库备份(几百 MB 至数十 GB):一次性载入会瞬间吃满系统可用内存,甚至引发系统的
MemoryError或触发操作系统的 OOM Killer 杀掉进程。 - 仅需处理前几行或尾部数据的场景:例如查看大文件的表头,全量读取造成严重的磁盘 IO 浪费。
- 流式管道处理:在边读取、边转换、边写入或网络流式传输中,必须采用分块处理。
在面对大文件或流式处理场景时,pathlib.Path 依然提供了无缝的退回方案 —— Path.open():
from pathlib import Path

large_file = Path("server_access.log")

# 面对数 GB 级别的大文件,使用 open() 逐行流式读取,内存占用恒定保持在数 KB
with large_file.open("r", encoding="utf-8") as f:
    for line in f:
        if "ERROR" in line:
            process_error_log(line)
六、知识总结与方法选型决策
为了在实际开发中快速做出正确决策,下表与决策图对三种主要读取手段的特征与适用环境进行了全面对比:
| 方法名称 | 返回类型 | 关键参数 | 内存行为 | 最适场景 |
|---|---|---|---|---|
Path.read_text() |
str |
encoding, errors |
全量载入 | 配置文件、脚本、小文本、Markdown、JSON |
Path.read_bytes() |
bytes |
无 | 全量载入 | 图片、音视频小片段、哈希计算、对象反序列化 |
Path.open() |
文件流对象 | mode, buffering, encoding 等 |
流式/按需缓冲 | 超大日志文件、GB级数据集、逐行流式计算 |
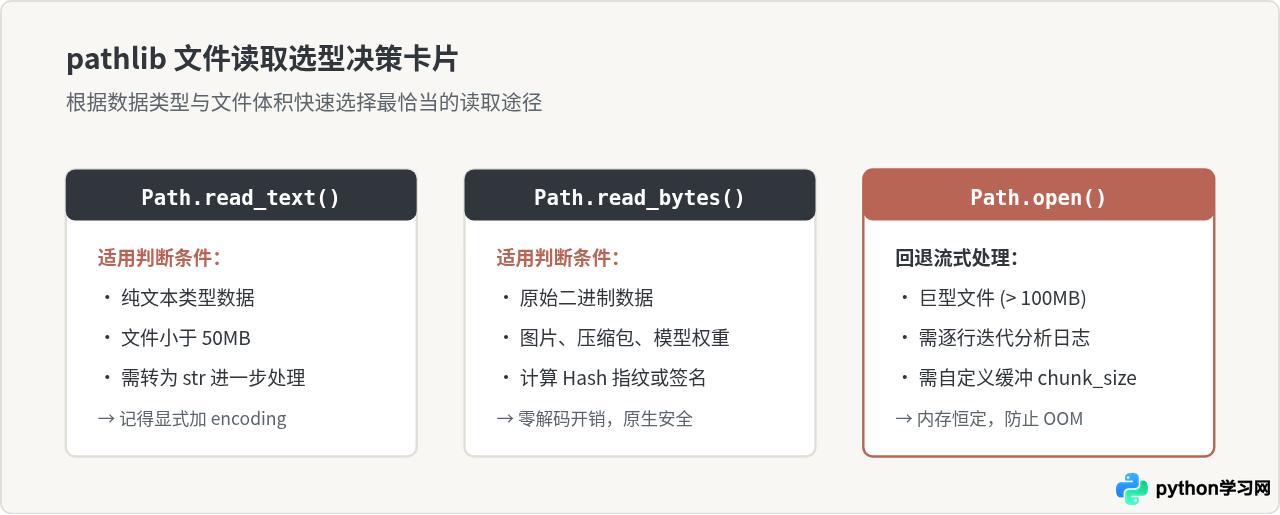
总的来说,pathlib.Path.read_text() 与 Path.read_bytes() 极大提升了 Python 处理中小文件的代码整洁度与编写效率。只要在调用 read_text() 时始终坚持指定 encoding='utf-8',并在遇到超大文件时适时切换回 Path.open() 迭代器,开发者便能在代码优雅度与系统稳定性之间取得理想平衡。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









