

Python中用列表推导式替代for循环提升代码效率
深入解析在Python中如何使用列表推导式替代传统for循环,从语法转换、底层字节码机制、执行效率对比到适用边界与注意事项,帮助开发者写出更高效、简洁的Python代码。
在Python开发中,构建新列表是一项极其常见的操作。很多初学者习惯使用标准的 for 循环配合 list.append() 方法逐步填充元素,但在需要纯粹转换或筛选数据时,改用列表推导式(List Comprehension)通常能使代码既简洁又拥有更高的执行效率。本文将直接说明列表推导式提升效率的底层原理、标准重构步骤、与传统循环的性能对比,并界定何时应该使用推导式、何时应保留循环。
一、从常规for循环到列表推导式的转换步骤
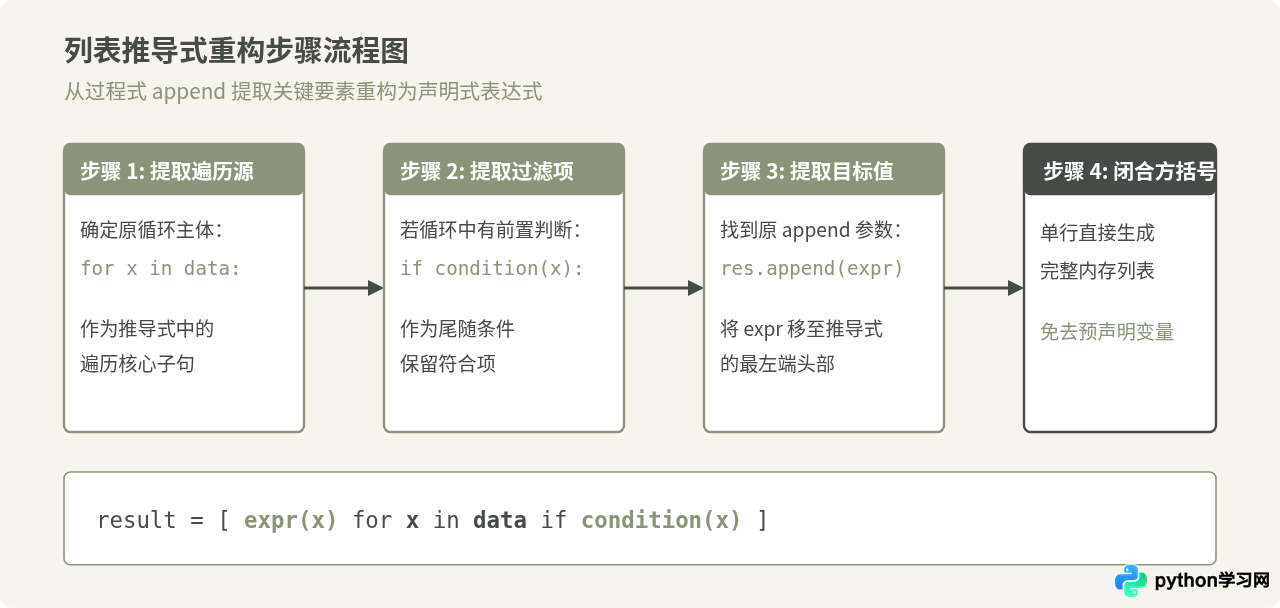
列表推导式本质上是用一种更声明式的句式来表达“对可迭代对象中的元素执行变换或筛选并聚合成列表”的过程。理解它的结构只需要掌握三要素:目标输出表达式、遍历来源、以及可选的筛选条件。
假设我们有一个整数列表,需要将其中的偶数平方后存入新列表中。常规的 for 循环写法如下:
# 传统 for 循环写法
numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
squares = []
for n in numbers:
    if n % 2 == 0:
        squares.append(n ** 2)

# 输出示例:squares 为 [4, 16, 36, 64, 100]
按照推导式的转换逻辑,只需提取三部分:最终放入列表的表达式 n ** 2、遍历来源 for n in numbers、以及过滤条件 if n % 2 == 0。改写后的代码为:
# 列表推导式写法
numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
squares = [n ** 2 for n in numbers if n % 2 == 0]

# 输出示例:squares 为 [4, 16, 36, 64, 100]
代码从原本的 5 行紧凑为 1 行,同时去掉了外部状态变量 squares = [] 的手动初始化。
二、为什么列表推导式比for循环更快?
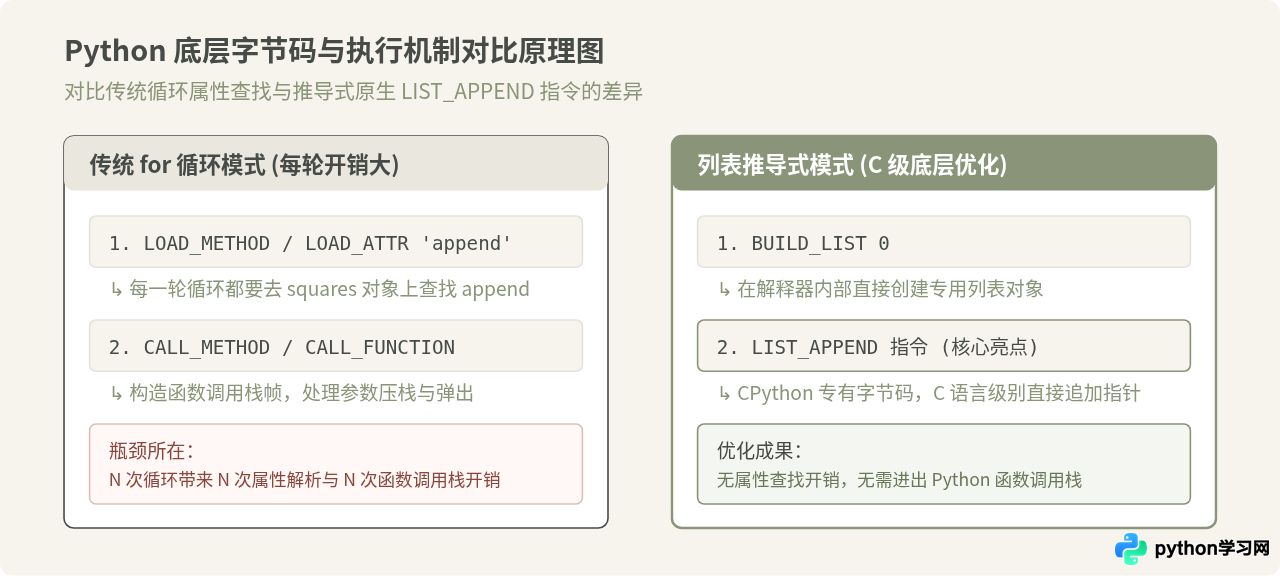
不少人认为列表推导式仅仅是一种“语法糖”,其底层依然等价于常规循环。但实际上,Python解释器在编译两者时生成的字节码有明显差异,这正是推导式效率更高的根本原因。
我们可以通过 Python 内置的 dis 模块来查看两者的实际字节码差异:
import dis

def loop_way():
    res = []
    for x in range(10):
        res.append(x)
    return res

def comp_way():
    return [x for x in range(10)]

print("=== 常规循环字节码 ===")
dis.dis(loop_way)

print("\n=== 列表推导式字节码 ===")
dis.dis(comp_way)
在常规循环的字节码中,每次循环都会执行 LOAD_METHOD(或 LOAD_ATTR)查找 append 方法,随后调用 CALL_METHOD(或 PRECALL/CALL)。而在列表推导式中,解释器直接使用了 LIST_APPEND 指令:
- 省略属性查找:传统循环在每一次迭代中,Python 虚拟机都需要在
res对象及其类型字典中检索名为append的属性指针;而推导式明确知道目标容器就是列表,省略了该查找步骤。 - 避免方法栈帧开销:
LIST_APPEND是一条单字节码指令,在 CPython 虚拟机的求值循环(evaluation loop)中直接调用底层 C 宏将元素存入数组,绕过了 Python 层面的函数调用开销。 - 内部动态扩容更紧凑:列表推导式在字节码生成和执行过程中,解释器对其生命周期有更明确的预期,预分配和连续写入在底层更紧凑。
三、基准性能对比测试
为了直观感受性能差异,我们使用内置的 timeit 模块在百万级数据量下进行对比测试:
import timeit

# 测试用例 1: 纯追加 1,000,000 个元素
t_loop = timeit.timeit(
    stmt="""
res = []
for x in range(1000000):
    res.append(x)
""",
    number=10
)

# 测试用例 2: 列表推导式生成 1,000,000 个元素
t_comp = timeit.timeit(
    stmt="res = [x for x in range(1000000)]",
    number=10
)

print(f"传统 for 循环耗时: {t_loop:.4f} 秒 (10次总计)")
print(f"列表推导式耗时:   {t_comp:.4f} 秒 (10次总计)")
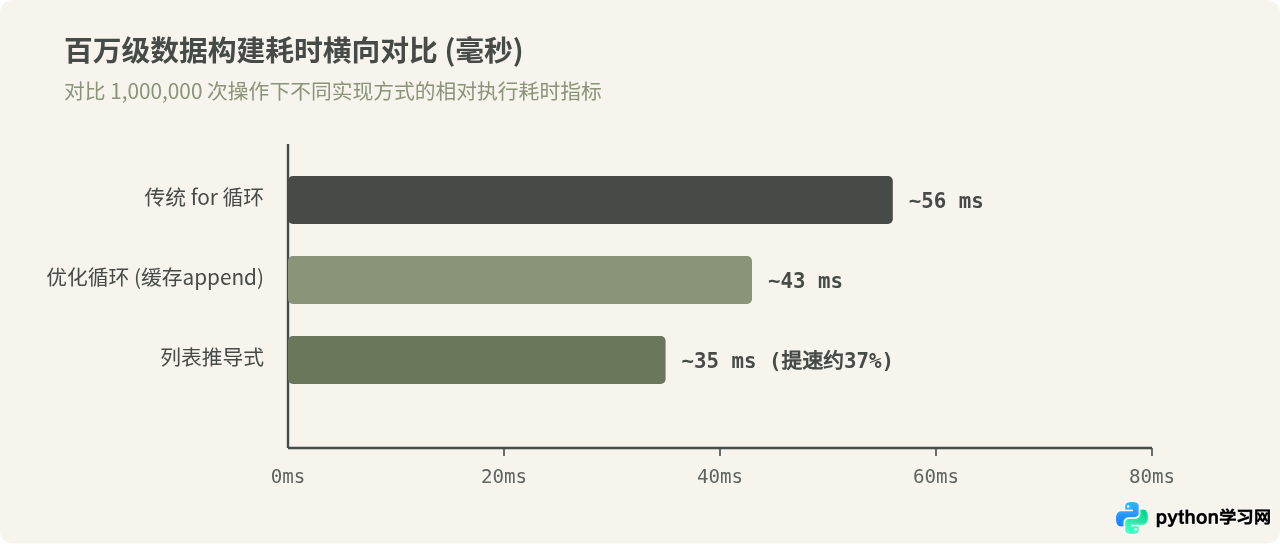
在标准的 Python 3.10+ 环境下运行上述测试,典型结果通常显示:传统 for 循环总耗时约在 0.55 秒左右,而列表推导式通常仅需 0.35 秒左右,耗时缩减约 30% 到 40%。
辨析:如果通过 append = res.append 缓存方法,循环能否追平推导式?
这是一个经典的进阶技巧。在循环外部使用 append = res.append 将方法绑定为局部变量,确实能消除循环体内的 LOAD_METHOD 开销(如图3第二项所示,耗时从 56ms 降至 43ms)。然而,它依然无法消除 CALL_FUNCTION 的栈帧出入开销,因此最终性能仍明显落后于基于 LIST_APPEND 的列表推导式。
四、容易混淆的认知与适用边界
虽然列表推导式在纯数据转换中兼具简洁与高效,但在实际工程中,不能盲目将所有 for 循环都替换为推导式。合理区分场景才能保持代码的优雅和系统的稳定性。
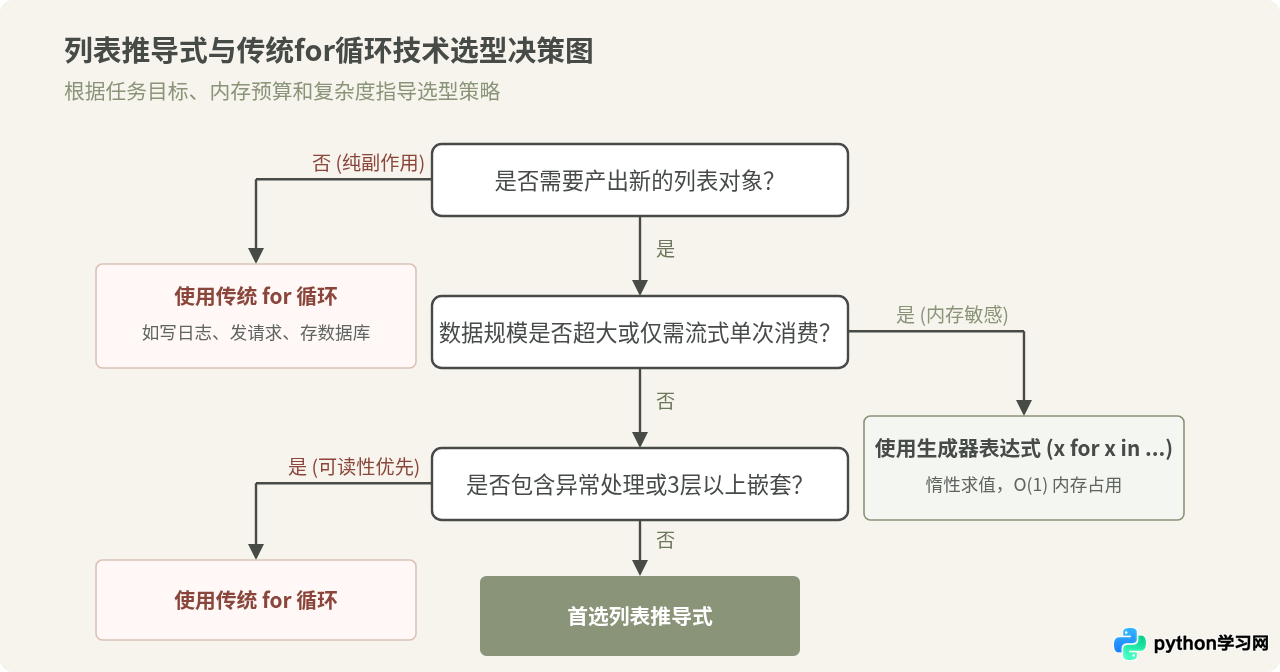
1. 警惕“为了推导而推导”的副作用滥用
列表推导式的核心目标是构建并返回一个新列表。如果只是想利用循环遍历执行外部操作(例如打印输出、写入数据库、修改对象属性),切勿使用列表推导式:
# 不推荐:纯副作用操作使用推导式(白白消耗内存创建无用列表)
[print(user.name) for user in user_list]

# 正确做法:直接使用常规 for 循环
for user in user_list:
    print(user.name)
2. 多重嵌套与可读性权衡
虽然列表推导式支持多层 for 与 if,但当嵌套超过两层时,代码的心理认知负荷会急剧增加。例如展平一个二维列表:
matrix = [[1, 2, 3], [4, 5, 6], [7, 8, 9]]
# 双层嵌套依然保持较好可读性:
flattened = [val for row in matrix for val in row]
但如果在其中再插入复杂的条件判断、甚至多重内联三元表达式,就应当果断退回传统 for 循环,并拆分成小函数处理,保证团队协作的可维护性。
3. 超大数据集下的内存考虑
列表推导式会立即在内存中创建完整的列表对象。如果迭代的数据集有数千万条,即使执行速度很快,也可能直接引发操作系统的内存告警。此时应改为圆括号的生成器表达式(Generator Expression),配合流式迭代来兼顾执行性能与内存平稳:
# 内存敏感场景:生成器表达式
gen = (x ** 2 for x in huge_range if x % 2 == 0)
for val in gen:
    consume(val)
五、总结
在 Python 中,用列表推导式替代 for 循环不仅让语法更符合 Pythonic 的声明式风格,更能通过 CPython 底层的 LIST_APPEND 专用指令规避运行时的动态属性查找与方法调用栈开销,从而获得 30% 以上的性能提升。在日常开发中,只要任务核心是“映射与筛选并最终生成新列表”,且不涉及过深嵌套与异常处理,列表推导式始终是首选方案。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









