

Python数据库设计选型:原生SQL、SQLAlchemy与Django ORM对比
深入对比Python生态中原生SQL、SQLAlchemy与Django ORM在架构抽象、开发效率、复杂查询、迁移维护与执行性能上的关键差异,提供具体场景代码与系统化选型决策指南。
在 Python 后端与数据系统开发中,数据库访问层的技术选型直接决定了开发效率、系统吞吐上限与长期维护成本。选择方案的核心依据不是社区流行度,而是应用形态与约束条件:使用 Django 构建完整 Web 平台时,内置的 Django ORM 能最大化协同其认证、后台管理与自动化迁移体系;构建微服务、异步高并发 API(如 FastAPI)或复杂报表系统时,SQLAlchemy 2.0 凭借 Core 与 ORM 的清晰分层以及与 Web 框架解耦的特性提供了最高的架构灵活性;而在极高频批量写入、超大结果集流式导出或需使用数据库特有底层特性的场景中,绕过抽象层直接使用原生 SQL 驱动(如 psycopg3 或 asyncpg)则是性能与控制力的最终保障。本文将从架构层级、开发维护、查询表达、性能开销与版本演进五个关键维度对这三者展开系统化对比与落地解析。
一、架构分层与核心设计理念对比
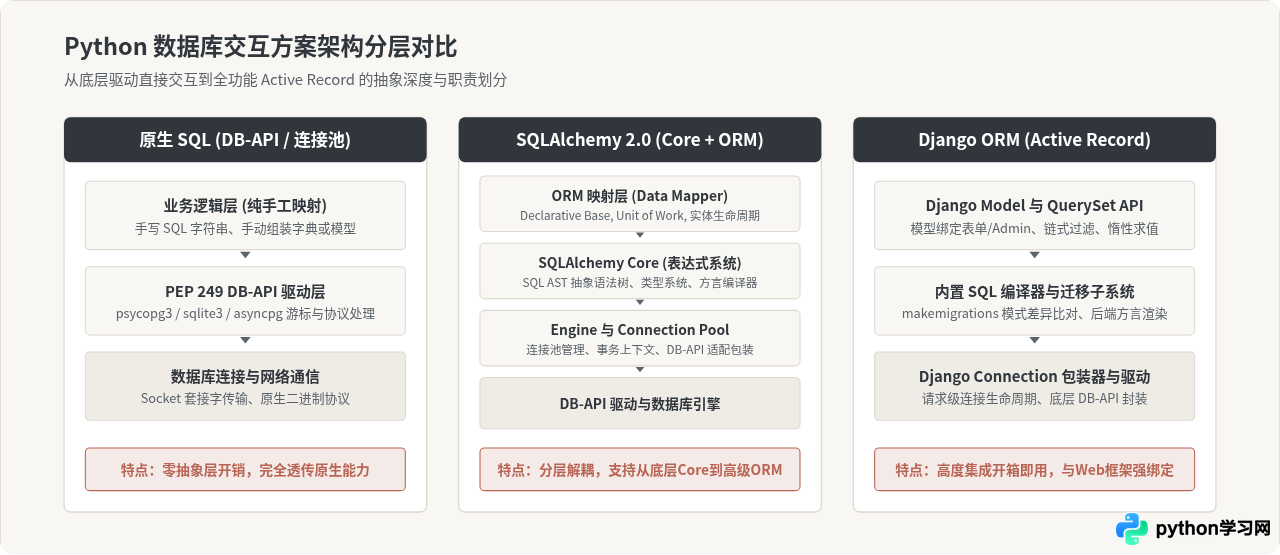
三种方案在 Python 应用与底层数据库之间设立了不同厚度的抽象层,这决定了开发者面对的是“数据行与游标”还是“业务实体对象与状态机”。
1. 原生 SQL:极简抽象与完全掌控
原生 SQL 方案遵循 Python 官方定义的 PEP 249(DB-API 2.0 规范)。程序通过连接池(如 psycopg_pool)获取连接并创建游标(Cursor),将参数化 SQL 字符串和参数元组直接发往数据库服务端。这种模式不存在对象状态追踪与隐蔽的查询生成,开发者编写的每一句 SQL 都会原汁原味地在数据库中执行。它的劣势是缺乏模式抽象,字段名变更需要全局搜索 SQL 字符串,跨数据库方言移植必须重写语法,且没有内置的模型校验机制。
2. SQLAlchemy 2.0:数据映射模式与分层解耦
SQLAlchemy 采用了 Data Mapper(数据映射器) 模式,并将其设计为两个高度独立的层次:
- SQLAlchemy Core:独立的 SQL 表达语言。它将 SQL 建模为 Python 的抽象语法树(AST),提供强类型的模式定义(Table、Column)和连接池管理,不含任何业务实体概念。
- SQLAlchemy ORM:构建在 Core 之上的高级持久化层。它通过
DeclarativeBase和Mapped[]类型注解实现类与表映射,利用 Unit of Work(工作单元) 模式自动捕获对象属性变更并在事务提交时计算最小化更新语句。
在 2.0 统一语法之后,SQLAlchemy 彻底规范了 select() 语句构建风格,消除了旧版 session.query() 的歧义,并对 asyncio 异步编程提供了原生一级支持。
3. Django ORM:Active Record 模式与生态一体化
Django ORM 严格践行 Active Record 模式:一个模型类对应一张数据库表,一个类实例对应表中的一行记录,业务方法、数据校验和持久化逻辑(如 instance.save()、instance.delete())直接绑定在同一个对象上。它的最大优势在于与 Django 生态(Django Admin 后台、ModelForm 表单验证、Django REST Framework 序列化器)的无缝协作。然而,Active Record 模式将数据访问与业务实体强行合一,当面对不依赖 Web 框架的微服务、独立的批处理脚本或多数据源异构系统时,提取和复用 Django ORM 往往面临繁重的框架依赖。
二、典型场景代码与开发体验对比
为了直观展现三者在开发体验上的差异,下面以同一个业务场景为例进行代码对照:定义“用户与多订单关系”,并执行“按条件查询用户及其关联订单并统计金额”的操作。
1. 原生 SQL 示例(以 psycopg 为例)
在原生 SQL 中,表结构由单独维护的 .sql 脚本创建,查询结果返回元组或字典,开发者需手动将关联查询拍平的数据聚合成树状结构:
import psycopg
from psycopg.rows import dict_row

# 执行多表关联查询与聚合
def get_user_orders(user_id: int):
    sql = """
        SELECT u.id AS user_id, u.username, o.id AS order_id, o.amount, o.status
        FROM app_user u
        LEFT JOIN user_order o ON u.id = o.user_id
        WHERE u.id = %(user_id)s AND (o.status IS NULL OR o.status = %(status)s)
        ORDER BY o.created_at DESC;
    """
    with psycopg.connect("dbname=shop user=postgres host=localhost", row_factory=dict_row) as conn:
        with conn.cursor() as cur:
            cur.execute(sql, {"user_id": user_id, "status": "paid"})
            rows = cur.fetchall()

            if not rows:
                return None

            # 手动组装对象与计算总额
            user_data = {"id": rows[0]["user_id"], "username": rows[0]["username"], "orders": []}
            total_amount = 0
            for r in rows:
                if r["order_id"] is not None:
                    user_data["orders"].append({"order_id": r["order_id"], "amount": r["amount"]})
                    total_amount += r["amount"]
            user_data["total_amount"] = total_amount
            return user_data
2. SQLAlchemy 2.0 示例
SQLAlchemy 2.0 利用类型注解清晰声明模型,通过 select() 显式指定关联预加载策略(如 joinedload 或 selectinload),有效规避 ORM 常见的 N+1 查询问题:
from typing import List
from sqlalchemy import String, Numeric, ForeignKey, select, func
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, relationship, Session, selectinload

class Base(DeclarativeBase):
    pass

class User(Base):
    __tablename__ = "app_user"
    id: Mapped[int] = mapped_column(primary_key=True)
    username: Mapped[str] = mapped_column(String(50))
    orders: Mapped[List["Order"]] = relationship(back_populates="user")

class Order(Base):
    __tablename__ = "user_order"
    id: Mapped[int] = mapped_column(primary_key=True)
    amount: Mapped[float] = mapped_column(Numeric(10, 2))
    status: Mapped[str] = mapped_column(String(20))
    user_id: Mapped[int] = mapped_column(ForeignKey("app_user.id"))
    user: Mapped[User] = relationship(back_populates="orders")

# 执行类型安全的查询与预加载
def get_user_with_orders(session: Session, user_id: int):
    stmt = (
        select(User)
        .options(selectinload(User.orders))
        .where(User.id == user_id)
    )
    user = session.scalar(stmt)
    return user
3. Django ORM 示例
Django ORM 通过模型字段定义外键,并借助高层级的 prefetch_related 或 annotate 链式调用一行代码完成复杂的聚合与关联加载:
from django.db import models
from django.db.models import Sum, Q

class User(models.Model):
    username = models.CharField(max_length=50)

    class Meta:
        db_table = "app_user"

class Order(models.Model):
    user = models.ForeignKey(User, on_delete=models.CASCADE, related_name="orders")
    amount = models.DecimalField(max_digits=10, decimal_places=2)
    status = models.CharField(max_length=20)
    created_at = models.DateTimeField(auto_now_add=True)

    class Meta:
        db_table = "user_order"

# 使用 QuerySet 链式过滤与聚合计算
def get_user_dashboard(user_id: int):
    return (
        User.objects.filter(id=user_id)
        .prefetch_related("orders")
        .annotate(total_paid=Sum("orders__amount", filter=Q(orders__status="paid")))
        .first()
    )
三、数据库模式演进与版本迁移工作流
在长期迭代的软件系统中,数据库结构不是静态的。字段新增、索引调优、外键重构等变更如何安全地在团队与生产环境中落地,是评估数据库设计选型的核心指标。
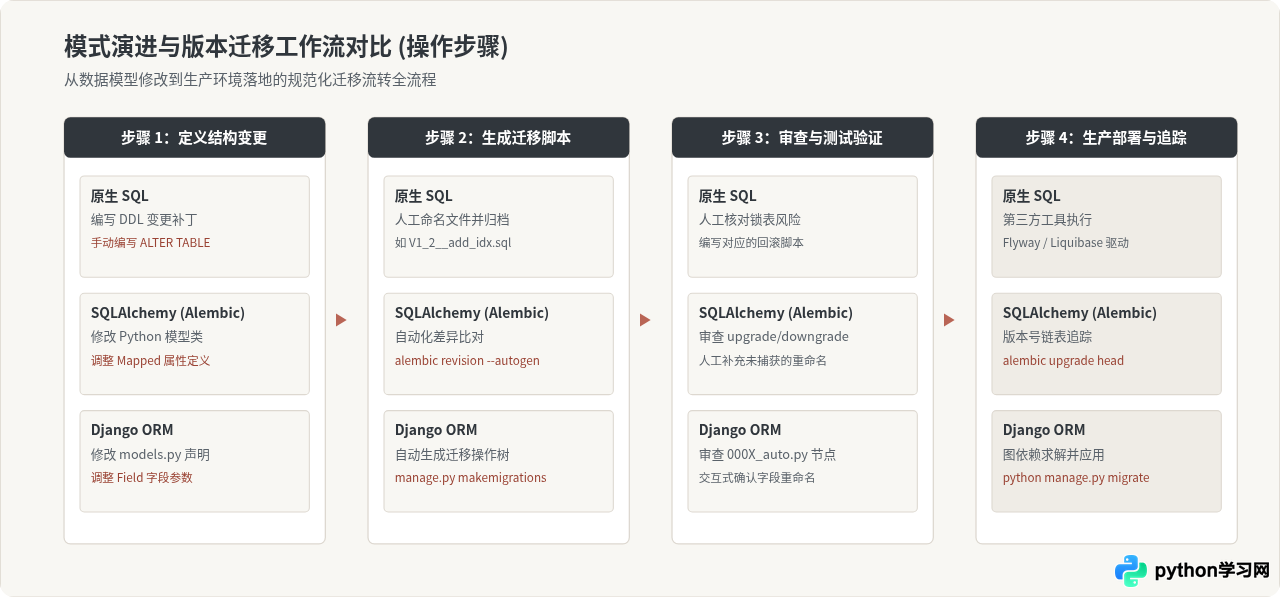
在迁移机制的完备性与自动化程度上,Django ORM 表现最为成熟。其迁移系统是一个有向无环图(DAG),能够自动解决不同应用间的迁移依赖冲突,并在字段重命名时通过命令行交互确认意图。SQLAlchemy 则依赖其姊妹库 Alembic,Alembic 能精准比对 Python 元数据与数据库物理 Catalog 的差异生成迁移草稿,但对列名重命名的自动检测有限,需要开发者人工核对生成的脚本。纯原生 SQL 项目通常必须引入诸如 Flyway、yoyo-migrations 等外部工具,或者自建版本控制表来维系多环境的数据库一致性,团队纪律成本最高。
四、查询生命周期与运行时开销分析
高级抽象虽然提升了开发效率,但在微秒与毫秒必争的业务场景中,ORM 带来的内部 CPU 计算与内存开销不容忽视。
从执行路径可以看出:
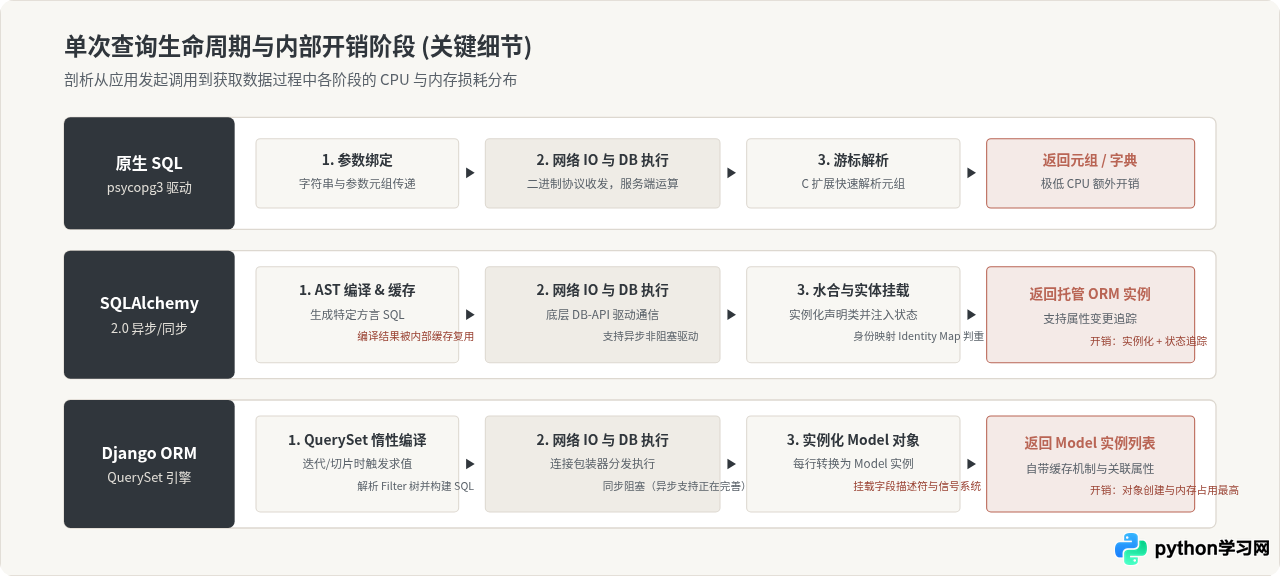
- 原生 SQL 的耗时几乎全部集中在物理网络传输与数据库本身的查询计算上。Python 进程内的序列化工作仅是 C 驱动将二进制行转换为 Python 元组或基础字典,CPU 开销接近于零。
- SQLAlchemy 2.0 引入了 AST 编译与水合(Hydration)过程。为了降低 AST 编译耗时,SQLAlchemy 内部维护了一个强大的 SQL 语句编译缓存(Compiled Cache)。对于多次执行的同一类查询,仅在首次执行时生成 SQL 文本,后续直接复用,主要损耗转移为将行数据构造成 ORM 实体的内存分配。如果使用 SQLAlchemy Core 执行
select()并直接返回RowMapping,其吞吐性能可达到原生 SQL 的 80%~90%。 - Django ORM 实例化完整 Model 的成本较高。每一个 Django Model 实例都包含属性追踪、字段转换器、信号机制与缓存引用。当一次性加载上万条记录时,内存开销和 CPU 实例化时间会显著激增。因此,在只读或大量导出场景中,必须使用
.values()或.values_list()绕开对象实例化。
五、全维度选型特征对照表
综合工程实践中的核心关注点,下表对三种技术方案进行了横向评测:
| 评估维度 | 原生 SQL (DB-API) | SQLAlchemy 2.0 | Django ORM |
|---|---|---|---|
| 架构模式 | 直接调用(零抽象) | Data Mapper(数据映射器) | Active Record(活动记录) |
| 框架耦合度 | 完全解耦(通用库) | 完全解耦(通用库) | 强绑定 Django 框架生态 |
| 类型安全与静态检查 | 弱(SQL 以字符串存在,无静态推断) | 极高(全面支持 Mapped 类型注解与 mypy) | 中等(依赖 django-stubs 插件) |
| 复杂查询与分析计算 | 无限(支持窗口函数、CTE、原生扩展) | 极强(Core 几乎覆盖全部 SQL 特性) | 一般(复杂多重关联易退化为 .raw()) |
| 异步支持 (asyncio) | 原生支持(asyncpg / psycopg3) | 全面原生支持(AsyncSession / greenlet) | 部分支持(逐步演进中,多处需 sync_to_async) |
| 迁移工具链 | 需自建或使用外部工具(Flyway等) | Alembic(强大灵活,需人工辅助审查) | 内置 Migrations(自动化程度最高、体验最佳) |
| 批量数据吞吐性能 | 最高(支持 COPY、多行原生批量插入) | 高(Core 批量执行极快,ORM 较慢) | 中等(需使用 bulk_create / bulk_update) |
| 学习曲线与心智负担 | 低(仅需掌握标准 SQL 与连接池) | 高(概念繁多:Session、Unit of Work、Flush) | 低至中(API 直观,开箱即用) |
六、工程落地选型决策路径
技术选型不应孤立看待单点性能,而应结合团队构成、业务类型与技术栈协同效应进行决策。下图给出了清晰的选型分支路径:
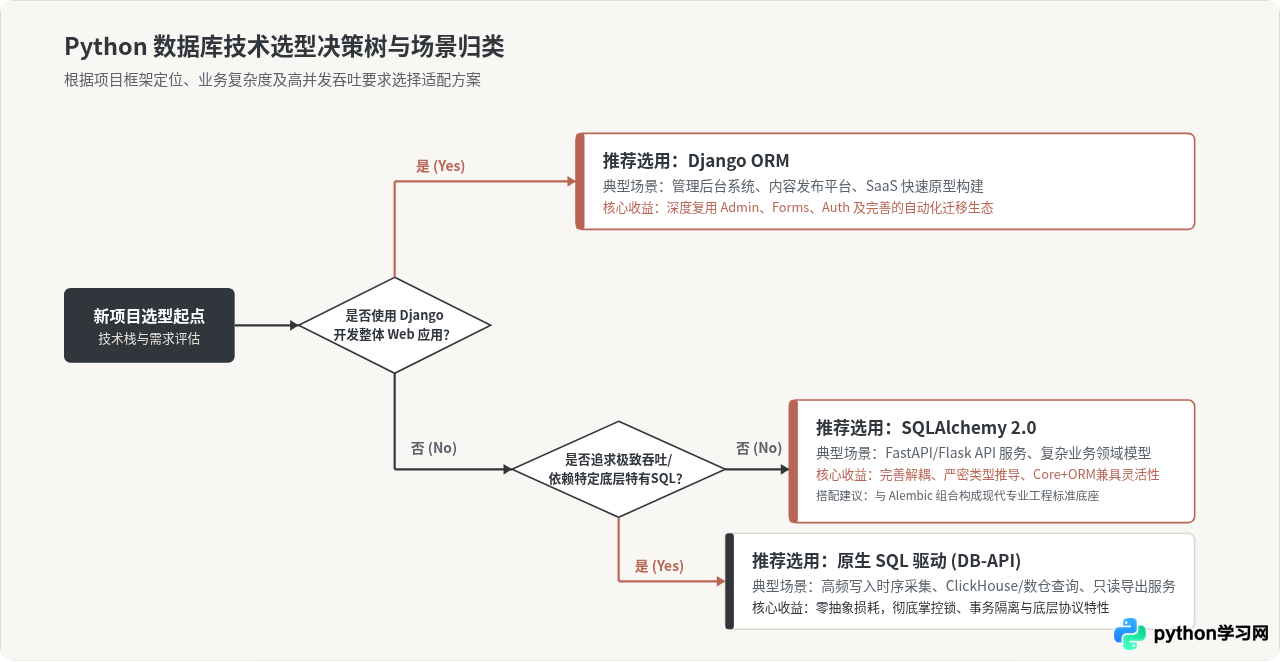
1. 混合搭配的最佳实践
在实际生产中,技术选型并非互斥单选,成熟的团队往往采用分层混合模式:
- 主干 ORM + 关键路径原生 SQL:在 Django 或 SQLAlchemy 项目中,90% 的普通 CRUD 与后台管理走 ORM,而对于每日亿级写入的计费流水表或复杂的月度多维财务分析报表,使用
connection.cursor()或session.execute(text("..."))旁路执行深度优化的原生 SQL。 - SQLAlchemy Core 与 ORM 并存:在基于 FastAPI 的现代微服务中,面向领域业务实体的交互采用 SQLAlchemy ORM,而面向高性能只读接口直接使用 SQLAlchemy Core 构造强类型表达式并直接映射为 Pydantic 模型,既保证了代码静态检查,又跳过了 ORM 水合开销。
1. 避免为了追求“未来的解耦”而强行在 Django 项目中引入 SQLAlchemy。这会失去 Django 最核心的生态红利,带来双重连接池与双重迁移系统的混乱。
2. 避免在低吞吐的管理后台中直接手写大量拼接原生 SQL。手工解析结果集与缺失的迁移版本控制会迅速吞噬团队的时间。
3. 在微服务或独立数据服务场景下,果断采用 SQLAlchemy 2.0 + Alembic。其高度解耦的架构与强类型系统能为复杂业务演进提供长期可靠的保障。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









