

Python怎么将普通数值矩阵转换为01矩阵
在Python中将普通数值矩阵转换为01矩阵,最常用且高效的方法是通过条件判断生成布尔矩阵,再将其转换为整型。本文详细介绍NumPy、列表推导式、Pandas等不同场景下的二值化实现方式、原理与避坑指南。
在Python中将普通数值矩阵转换为01矩阵,最直接且高效的方法是设定判定阈值,先利用比较运算符生成布尔矩阵,再将其强制转换为整型。根据数据载体的不同,NumPy数组可以直接调用 (matrix >= threshold).astype(int) 或 np.where(),原生列表可通过嵌套列表推导式处理,Pandas数据框则可通过布尔掩码结合类型转换实现。本文将针对这几类常见数据结构展开具体实现步骤、底层机制与选型建议。
一、基于NumPy数组的转换方法
在科学计算与数据分析场景中,矩阵通常以 numpy.ndarray 的形式存在。利用NumPy的向量化广播特性,不需要编写任何显式循环即可毫秒级完成矩阵二值化。
1. 广播比较与类型铸造(推荐写法)
该方法首先对矩阵执行标量比较,生成一个相同维度的布尔类型数组(元素为 True 或 False),随后调用 .astype() 将布尔值转换为整型,其中 True 转为 1,False 转为 0。
import numpy as np

# 构造一个 3x3 的普通浮点数值矩阵
matrix = np.array([
    [0.15, 0.82, 0.45],
    [0.91, 0.33, 0.68],
    [0.12, 0.50, 0.77]
])

# 设定阈值为 0.5:大于等于 0.5 的转为 1,其余转为 0
binary_matrix = (matrix >= 0.5).astype(int)

# 打印示例输出
print(binary_matrix)
# 示例输出:
# [[0 1 0]
#  [1 0 1]
#  [0 1 1]]
2. 使用 np.where 函数
np.where(condition, x, y) 接受三个参数:判定条件、满足条件时的返回值以及不满足时的返回值。如果转换规则除了 0 和 1 外未来还可能扩展,或者需要在单行内明确写出替代值,np.where 是最清晰的选择。
# 使用 np.where 实现二值化
binary_where = np.where(matrix >= 0.5, 1, 0)

print(binary_where)
# 示例输出与前面一致,返回 dtype 为 int64 的 01 矩阵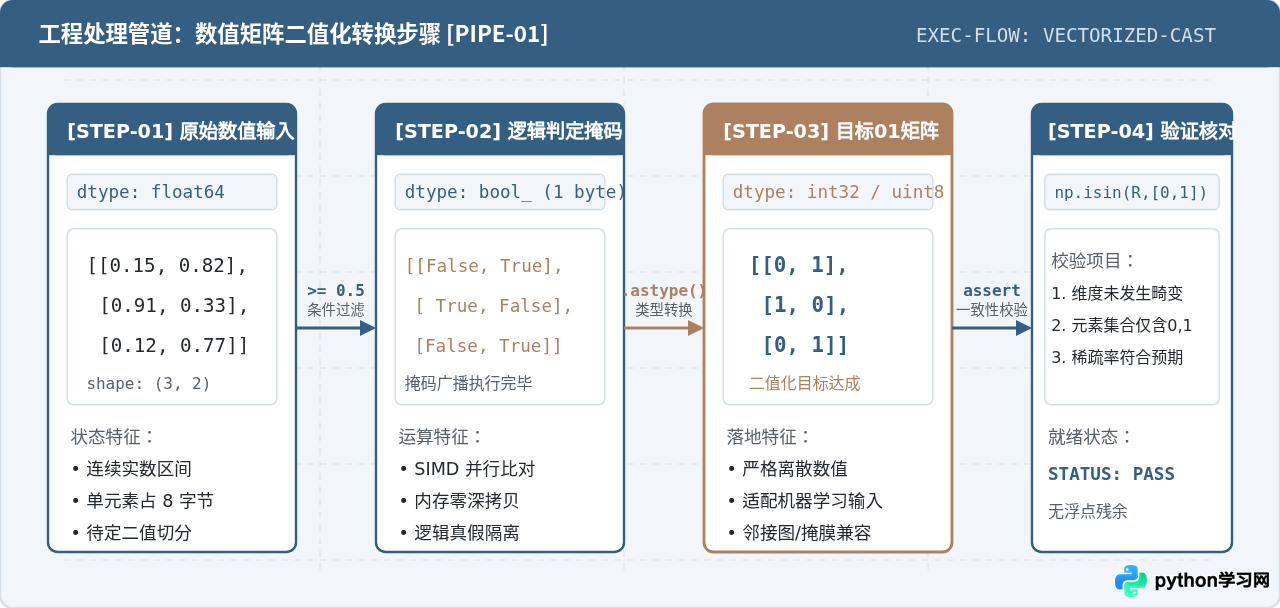
二、原生Python嵌套列表的转换方法
如果当前环境不允许引入外部依赖库(如标准库轻量运行环境),矩阵通常使用双层嵌套列表表示。此时可以通过嵌套列表推导式或内置的 map 高效处理。
1. 嵌套列表推导式
列表推导式具有优良的可读性与解释器内联优化,外层循环遍历矩阵行,内层循环对每个数值应用三元表达式。
# 原始嵌套列表形式的矩阵
raw_matrix = [
    [12.5, 3.2, 8.7],
    [4.1, 15.0, 6.3],
    [9.8, 2.1, 11.4]
]

threshold = 8.0

# 列表推导式:大于等于阈值记为 1,否则记为 0
binary_list = [[1 if val >= threshold else 0 for val in row] for row in raw_matrix]

print(binary_list)
# 示例输出:
# [[1, 0, 1],
#  [0, 1, 0],
#  [1, 0, 1]]
2. 利用 int() 强转布尔表达式
在Python中,布尔类型 bool 是 int 的直接子类,int(True) 返回 1,int(False) 返回 0。可以直接利用这一语言特性简化推导式:
# 利用 int(bool) 进行紧凑转换
compact_binary = [[int(val >= threshold) for val in row] for row in raw_matrix]
三、底层转换机制与内存开销考量
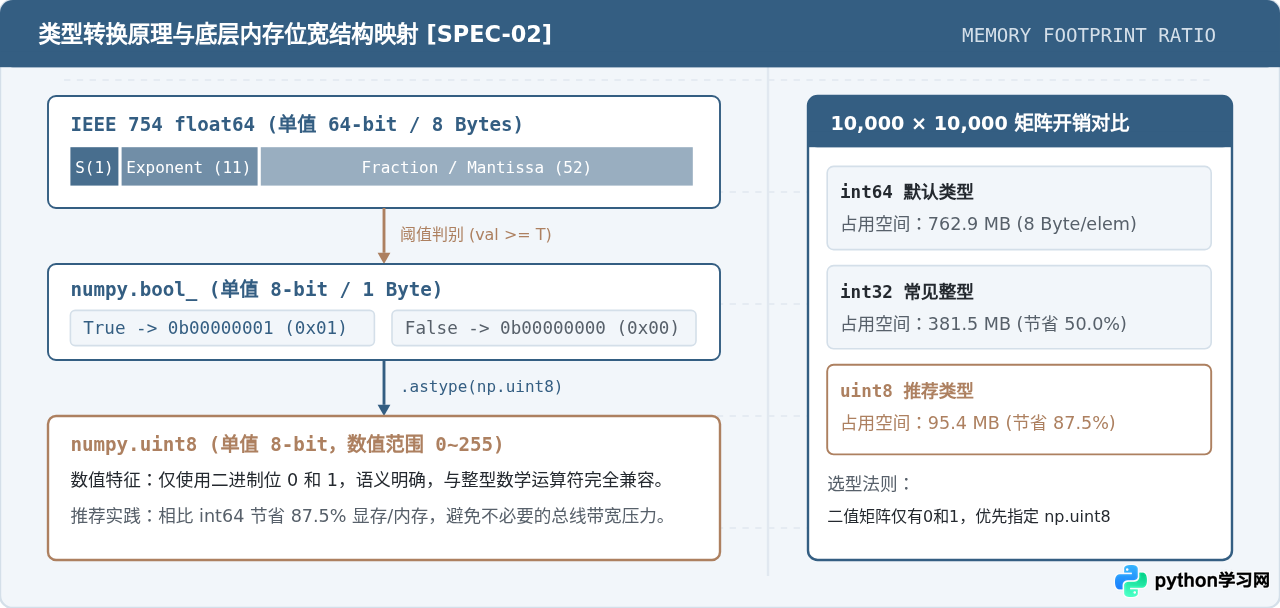
在处理超大规模矩阵(例如高光谱图像、用户行为邻接矩阵)时,数据类型(dtype)的选择直接决定了系统的内存吞吐与处理性能。很多开发者默认使用 .astype(int),在 64 位操作系统下通常会被隐式推导为 int64(单元素占用 8 字节),这与原矩阵的 float64 占用的内存完全一致,无法体现二值矩阵的轻量优势。
四、进阶二值化场景与规则处理
现实任务中,数值转换为01矩阵往往并非单一固定阈值所能涵盖。常见变体包括局部自适应阈值、双阈值区间判定以及缺失值(NaN)的隔离保护。
1. 行/列局部自适应均值二值化
当矩阵各行(例如不同传感器通道)基准数值范围相差极大时,使用统一全局阈值会导致部分行全为0或全为1。此时可以计算每行的均值作为动态阈值:
# 每一行按自身均值作为阈值
row_means = matrix.mean(axis=1, keepdims=True)
adaptive_binary = (matrix >= row_means).astype(np.uint8)
2. 双阈值区间二值化(带通判定)
若需要筛选落在某个有效数值区间 [min_val, max_val] 内的元素为 1,其余为 0,必须使用按位与运算符 & 并为各条件加上圆括号:
# 筛选 [0.3, 0.7] 区间内的元素为 1
in_range_binary = ((matrix >= 0.3) & (matrix <= 0.7)).astype(np.uint8)
3. 矩阵包含缺失值(NaN)的安全转换
在NumPy中,任何数值与 np.nan 的比较结果均为 False。如果不加处理直接使用 (matrix >= 0.5).astype(int),原本缺失的 NaN 元素会被悄然转换为 0,从而引入脏数据。若业务上需要保留缺失状态,可以使用 np.where 保持浮点型的 np.nan:
nan_matrix = np.array([
    [0.2, np.nan],
    [0.8, 0.4]
])

# 安全保留 NaN,其余部分转为 1.0 和 0.0
safe_binary = np.where(np.isnan(nan_matrix), np.nan, (nan_matrix >= 0.5).astype(float))

print(safe_binary)
# 示例输出:
# [[ 0. nan]
#  [ 1.  0.]]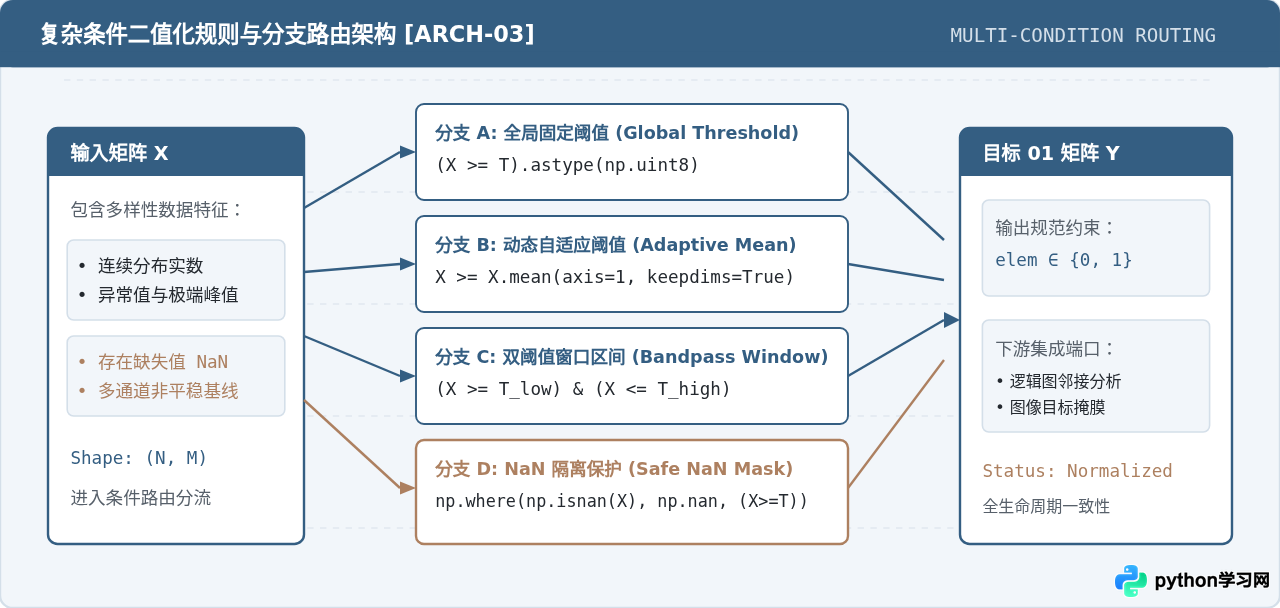
五、Pandas DataFrame 对象的二值化处理
当数值矩阵存储在 pandas.DataFrame 中时,通常伴随着行索引(Index)和列名(Columns)。直接转为NumPy数组会丢失这些元数据,因此建议直接在DataFrame上执行二值化:
import pandas as pd

# 创建带有行标签和列标签的数值表格
df = pd.DataFrame({
    'feature_A': [0.1, 0.9, 0.4],
    'feature_B': [0.8, 0.2, 0.7],
    'feature_C': [0.3, 0.6, 0.5]
}, index=['sample_1', 'sample_2', 'sample_3'])

# 全局阈值判定:直接与数值比较并强转类型
binary_df = (df >= 0.5).astype(int)

print(binary_df)
# 示例输出:
#           feature_A  feature_B  feature_C
# sample_1          0          1          0
# sample_2          1          0          1
# sample_3          0          1          1
若不同列具有不同的物理意义和阈值标准,可以传入字典或Series实现列级别的差异化二值化:
# 为不同特征列分别指定独立阈值
column_thresholds = {'feature_A': 0.3, 'feature_B': 0.5, 'feature_C': 0.4}
custom_binary_df = (df >= column_thresholds).astype(int)
六、技术方案选型与对比总结
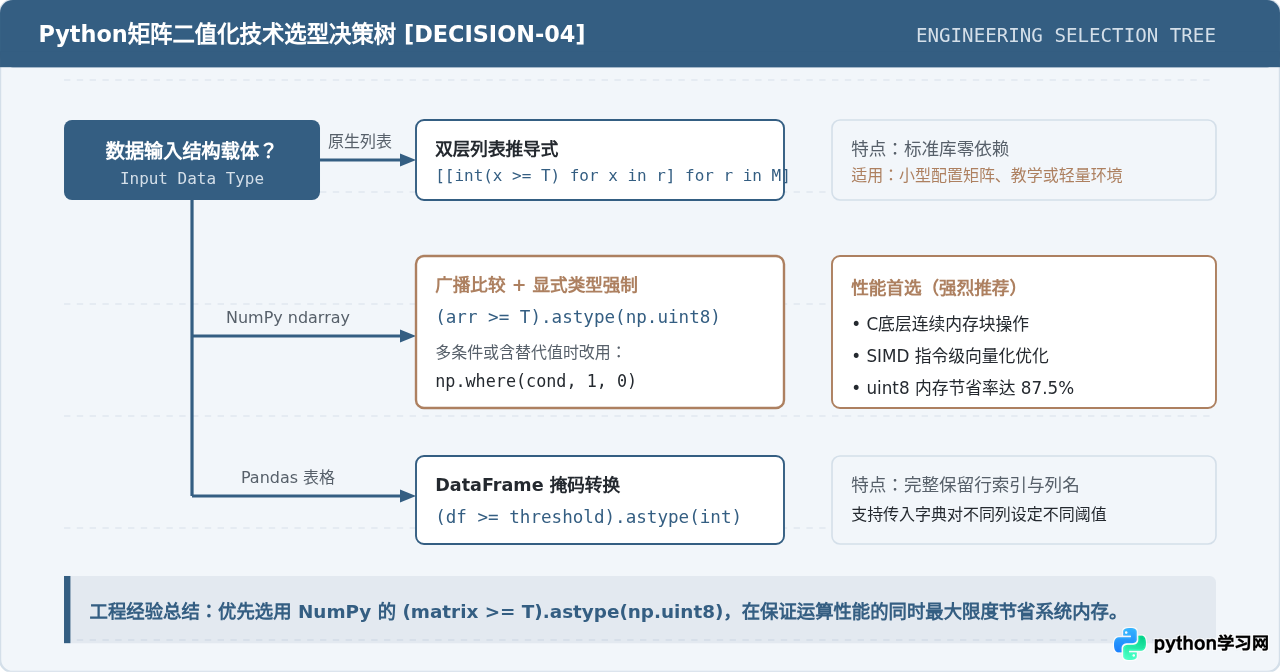
根据数据结构、环境约束和性能要求的不同,各实现方案的适用场景对比如下表所示:
| 实现方案 | 依赖库 | 适用数据结构 | 优点 | 注意事项 |
|---|---|---|---|---|
(arr >= T).astype(np.uint8) |
NumPy | ndarray |
向量化执行速度极快,内存占用最低 | 需显式指定 uint8 避免默认分配 int64 |
np.where(cond, 1, 0) |
NumPy | ndarray |
语法清晰直观,易于扩展多分支取值 | 当条件满足时返回新数组,注意内存分配 |
| 嵌套列表推导式 | 无(内置语法) | 原生 list |
零依赖,适合轻量脚本或无NumPy环境 | 矩阵规模达万级以上时存在解释器循环开销 |
(df >= T).astype(int) |
Pandas | DataFrame |
保留索引与列名元数据,支持按列多阈值 | 依赖较重,性能略低于原生NumPy计算 |
七、常见问题与注意事项
- 布尔型矩阵直接参与运算的隐患:虽然在纯Python与NumPy的加法运算中
True + True会得出2,看似与数值 1 等价,但在执行严格类型校验的下游系统(例如 JSON 序列化、PyTorch/TensorFlow 张量输入、数据库整型写入)中,布尔类型通常不会被自动兼容。因此务必显式执行.astype(int)或.astype(np.uint8)完成离散整数化。 - 比较运算符优先级问题:在构建复合判定条件时(如
matrix >= 0.2 & matrix <= 0.8),由于按位与&的优先级高于比较运算符>=和<=,不加括号会导致语法错误或逻辑异常,必须为每一个比较项外包裹圆括号:(matrix >= 0.2) & (matrix <= 0.8)。 - 就地修改(In-place)与副本机制:
(matrix >= 0.5)会在内存中开辟新的布尔数组。如果内存极端受限且希望在原矩阵上原地修改,可借助布尔索引:matrix[matrix < 0.5] = 0; matrix[matrix >= 0.5] = 1,但需要注意该操作会保留原矩阵的浮点数据类型(如 float64),不会自动将存储格式降阶为整型。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









