

Python脚本语言的优缺点:开发效率与运行性能的权衡
深入剖析Python作为脚本语言的核心优缺点,探讨开发效率与执行性能之间的工程权衡,并提供性能分析、分层架构与混合编程的最佳实践。
在现代软件工程中,选择一门编程语言本质上是在选择一组妥协方案。Python 的核心设计哲学非常明确:优先用机器的运行时间,换取工程师的开发与迭代时间。凭借简洁优雅的语法、动态类型系统以及丰富的生态库,Python 极大压缩了从业务需求到可用原型的时间成本;但与此同时,解释执行机制、动态对象的内存开销以及全局解释器锁(GIL)的存在,也让它在纯计算密集型场景下的原生吞吐明显落后于编译型语言。理解这种权衡,并不是在“快”与“慢”之间做二选一的评判,而是要在架构层面厘清不同层级的瓶颈,通过合理的技术选型和工程分工实现整体效能的最大化。
一、开发效率:为什么 Python 能够极大提升生产力?
谈及开发效率,很多人的第一直觉是“打字更少”,但这只是最表层的收益。Python 提升开发效率的深层原因在于其极低的心智负担与高度抽象的表达能力,主要体现在以下三个维度:
1. 语法直观与代码高可读性
Python 强制使用缩进来组织代码块,消除了繁琐的大括号和行尾分号。它的语法结构贴近自然英语表达,使开发者能够专注于业务逻辑本身,而不是与编译器的类型检查和语法规则周旋。在团队协作中,代码往往“被阅读的次数远多于被编写的次数”,Python 统一而清爽的代码风格大幅降低了代码交接与长期维护的心智负担。
2. 动态类型与交互式 REPL 迭代
作为一门动态脚本语言,Python 在变量声明时无需显式标注类型,支持在运行时自由绑定不同对象。配合交互式命令行(REPL)或 Jupyter Notebook 环境,开发者可以逐行执行逻辑、实时检查变量状态,并即时验证想法。这种“边写边验”的即时反馈循环,将传统编译、链接、打包、运行的漫长流程缩短至秒级,特别契合数据科学探索、敏捷脚本与快速原型验证场景。
3. 成熟完备的“电池内置”与第三方生态
Python 拥有覆盖网络请求、文件解析、加密解密、数学计算等领域的标准库,真正践行了“电池内置(Batteries Included)”的理念。更重要的是,在 Web 开发(FastAPI、Django)、数据工程(Pandas、Polars)和人工智能(PyTorch、Transformers)等领域,Python 已经形成了行业事实标准。开发复杂功能时,工程师通常只需组装成熟的社区构件,而不必从零造轮子。
二、运行性能:短板究竟来源于哪些底层机制?
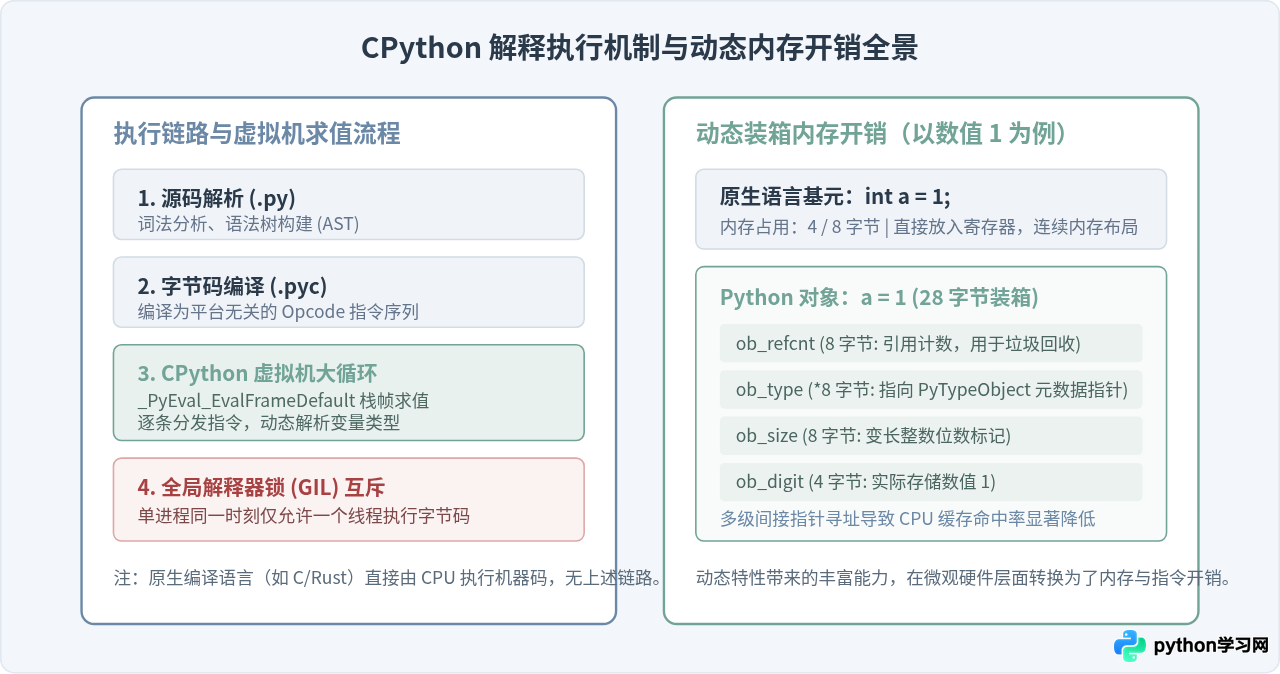
尽管开发体验极佳,但在纯 CPU 计算与高并发高吞吐场景下,官方标准实现(CPython)的性能常遭诟病。这种运行性能的短板并非语言设计的疏漏,而是实现高动态性所必须付出的工程代价。具体而言,性能损耗主要源于以下三个底层机制:
1. 解释执行与虚拟机循环开销
与 C、C++、Rust 等直接被编译器翻译为目标架构原生机器码(AOT 编译)的语言不同,Python 源码在运行时首先被编译为平台无关的字节码(Bytecode),随后由 CPython 虚拟机中的主求值循环(_PyEval_EvalFrameDefault)逐条解释执行。每次执行操作码,解释器都需要进行指令解码、跳转分发和运行时检查,这引入了大量的额外指令开销。
2. 动态类型带来的 PyObject 内存装箱与多级寻址
在 Python 中,一切皆为对象。即使是一个看似简单的整数 1,在底层的 CPython 也是一个完整的 PyLongObject 结构体。一个在 C 语言中仅占 4 或 8 字节的基元数值,在 64 位 Python 环境中需要消耗至少 28 字节,包含引用计数器、类型指针和数值缓冲区。这种“一切装箱”的机制带来了两重性能惩罚:一是巨大的内存占用膨胀;二是动态方法查找需要顺着对象指针多层解引用,严重破坏了 CPU 硬件缓存的局部性(Cache Miss)。
3. 全局解释器锁(GIL)对多核并行的限制
为了保证内部内存管理(特别是引用计数)的线程安全,CPython 引入了全局解释器锁(Global Interpreter Lock,GIL)。GIL 要求任何时刻只能有一个系统线程执行 Python 字节码。因此,在单个 Python 进程内,无论服务器拥有多少个物理 CPU 核心,使用内置 threading 模块编写的纯计算密集型任务都无法实现真正的多核并行,甚至可能由于线程频繁的上下文切换和锁竞争而导致性能比单线程更慢。
三、精准施治:Python 性能瓶颈的排查与分级优化路径
面对性能要求时,优秀工程师的第一反应不是立即推翻重写,而是首先确定瓶颈的具体性质。在实际生产系统中,超过 80% 的服务实际上属于 I/O 密集型(网络延迟、数据库读写、文件系统操作),在这类场景中,使用 C 语言或 Python 的端到端响应耗时差别往往只有几个毫秒,甚至被网络抖动完全抹平。
当系统确实遇到算力瓶颈时,应当遵循以下四步由浅入深的工程排查与优化路径:
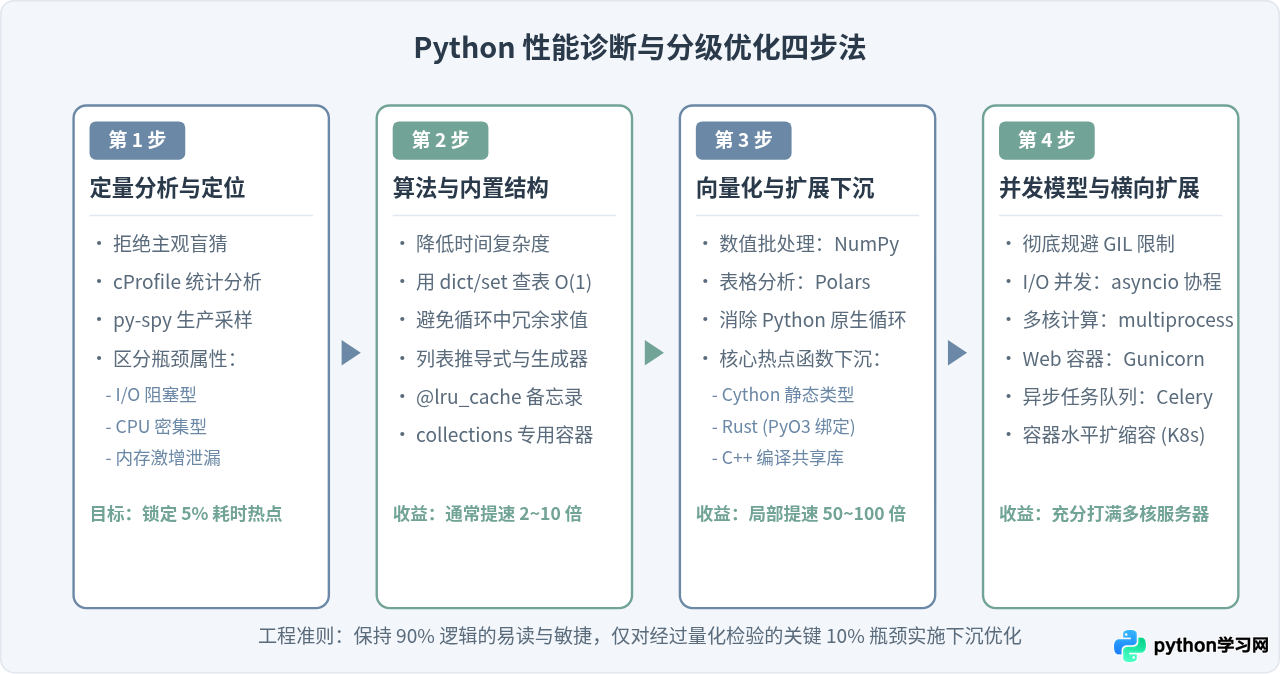
实战步骤说明:
- 使用性能分析器(Profiler)锁定热点:在优化前使用
cProfile导出执行调用树,或在生产环境中采用对系统负载极低的采样分析器py-spy抓取火焰图。未经测量的“优化”往往只是在浪费工程时间。 - 改进数据结构与算法复杂度:例如将大量元素的多重嵌套列表查找($O(N)$)重构为哈希集合查找($O(1)$),往往能在一行改动内实现数百倍的吞吐提升。
- 使用向量化与原生扩展加速热点计算:对于大量密集数组运算,利用 NumPy 将数据以连续原生 C 内存块组织,并通过底层编译好的 BLAS 库进行 SIMD 向量化计算;或者采用 PyO3 编写轻量的 Rust 模块替代纯 Python 循环。
- 选择契合的并发模型:处理海量网络请求时采用
asyncio单线程异步非阻塞 I/O;处理多核数学运算时采用multiprocessing衍生独立子进程,完全绕开 GIL 互斥限制。
四、工程选型:开发效率与运行性能的决策矩阵
技术选型从来不是对“完美语言”的追寻,而是根据具体的业务生命周期、团队规模、算力预算与延迟约束进行务实的平衡。为了更清晰地指导实际工程决策,我们可以依据“业务交付速度需求”与“运行吞吐/计算时延需求”建立二维决策模型:
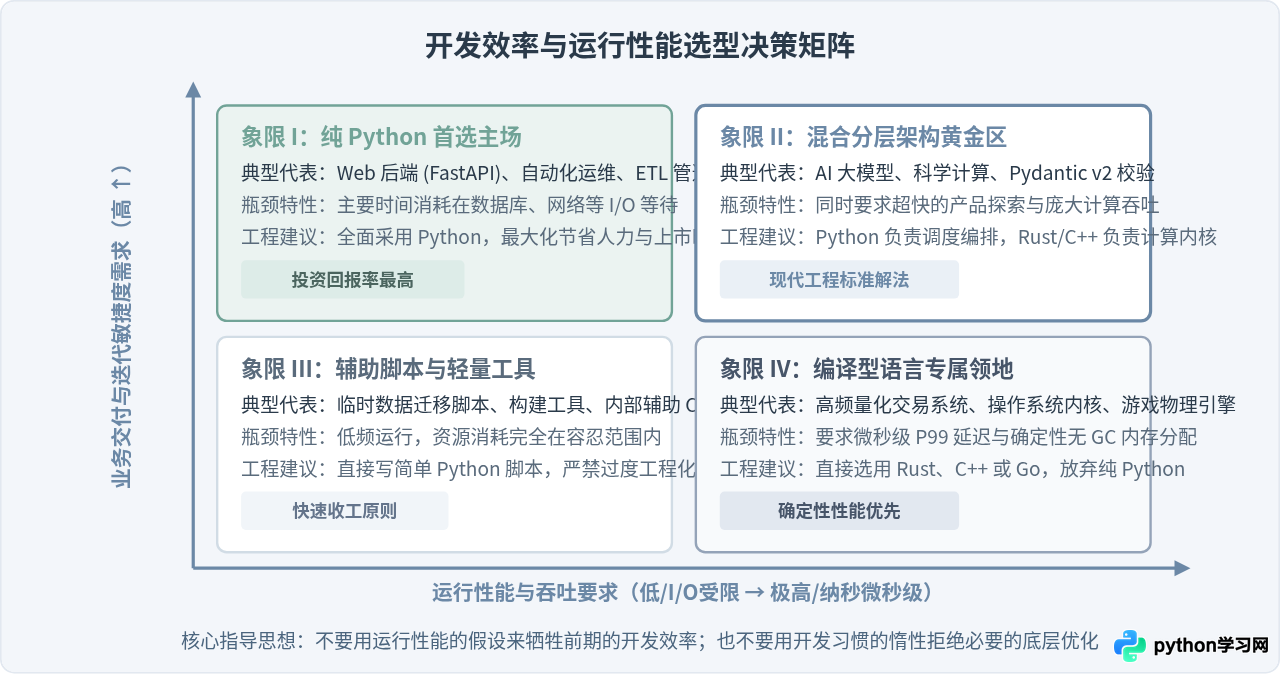
常见典型场景对比:
| 业务场景 | 瓶颈类型 | Python 适用度 | 推荐工程方案 |
|---|---|---|---|
| REST / GraphQL API 接口服务 | 网络与数据库 I/O 阻塞 | 非常高 | 使用 FastAPI / Starlette + 异步数据库驱动(asyncpg),搭配多进程 Gunicorn 部署。 |
| AI 深度学习与科学计算 | 重度 CPU/GPU 计算 | 极高(混合模式) | 以 Python 编写模型逻辑与数据读取管道,底层计算由 PyTorch (C++/CUDA) 或 NumPy 向量化承载。 |
| 数据清洗与离线 ETL | 内存吞吐与磁盘 I/O | 高 | 采用 Polars / DuckDB 替代传统低效的 Python 循环,直接调用原生多线程向量化引擎。 |
| 高频量化交易系统 | 极低延迟(微秒级) | 较低(仅适合回测) | Python 仅用于策略回测与特征验证;实盘订单路由和风控核心必须采用 C++ 或 Rust 原生构建。 |
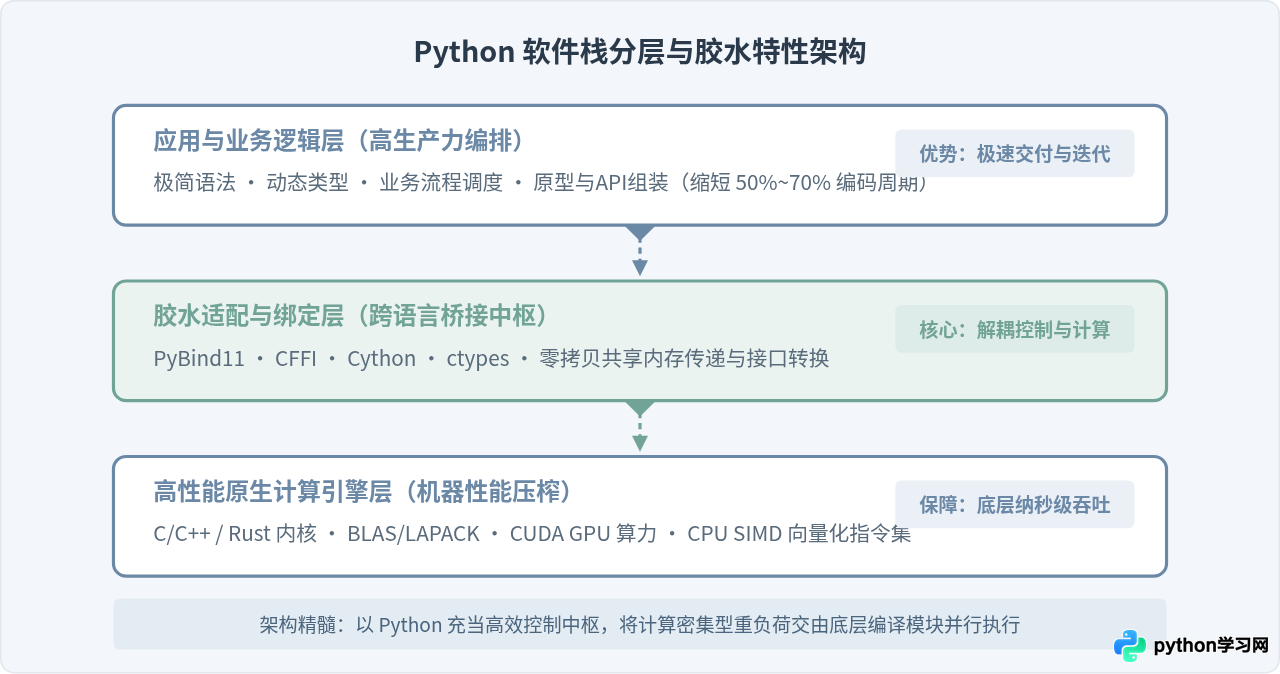
在当下的工业级软件体系中,“纯粹只用一种语言构建一切”的理念已经逐渐过时。Python 最强大的地方,不仅在于它自身的语法能写得多么简洁,更在于它拥有作为“顶层胶水”的包容能力。对于绝大部分团队而言:先用 Python 快速构建系统、验证产品价值并占领市场;当系统规模增长到一定阶段、产生明确的算力瓶颈时,再通过性能剖析精确定位热点,将 5%~10% 的核心密集计算下沉到编译型语言或专用扩展中——这才是兼顾开发效率与运行性能的最成熟工程实践。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









