

Python exe与LabVIEW之间的大数据传输方案
深入解析独立打包的Python exe与LabVIEW之间实现高速、稳定大数据传输的核心架构、实现步骤、代码示例与工程避坑指南。
在工业测控、机器视觉与自动化测试领域,通常由 LabVIEW 负责底层高频数据采集与实时仪器控制,而涉及深度学习推理、复杂现代信号处理时,工程上常将 Python 算法脚本通过 PyInstaller 或 Nuitka 编译打包为独立的 Windows .exe 进程运行。当单次传输的数据量达到数十兆甚至数百兆字节(如高帧率原始图像帧、多通道高速采集卡连续波形)时,传统的命令行参数、标准输入输出管道或磁盘中间文件会因内存拷贝开销大、解析耗时以及磁盘 IO 瓶颈发生严重丢帧或崩溃。本文将针对这一典型工程场景,详细讲解如何通过共享内存(Shared Memory)与本地裸二进制 TCP 流(Local Raw Binary Stream)两种高效机制,打通独立 Python 可执行程序与 LabVIEW 之间的高吞吐、低延迟大数据传输通路。
一、为什么常规进程间通信无法胜任大数据传输
假设工控机上一张 PCI-e 高速采集卡正以 100 MS/s 的采样率获取双通道 16 位浮点波形,数据在 LabVIEW 内存中以每秒百兆字节的速度积压,并需要实时交由一个预训练好的 Python exe 神经网络模型进行缺陷检测或频域反演。如果采用初学者最直观的做法,往往会遇到以下严峻瓶颈:
- 命令行启动参数传递:Windows 命令行对参数总长度有约 32 KB(32767 字符)的严格物理上限,且每次传递都需要频繁重启进程,进程冷启动与 Python 运行时初始化至少耗时数秒,完全不具备连续数据吞吐能力。
- 磁盘临时文件(CSV / JSON / HDF5 / Bin):频繁对硬盘(哪怕是 NVMe SSD)执行大尺寸写入与读取会引入不可控的文件系统缓存同步延迟(通常在 10 ms 到 50 ms 之间),并面临两端访问文件时的文件锁冲突(Sharing Violation),极易导致数据断流。
- 标准输入输出(stdin / stdout 文本流):字符串序列化与反序列化(如 float 转 string)消耗大量 CPU 时钟周期,且 Windows 默认管道缓冲区仅有 4 KB 到 64 KB,瞬时大数据极易将管道撑满引发死锁。
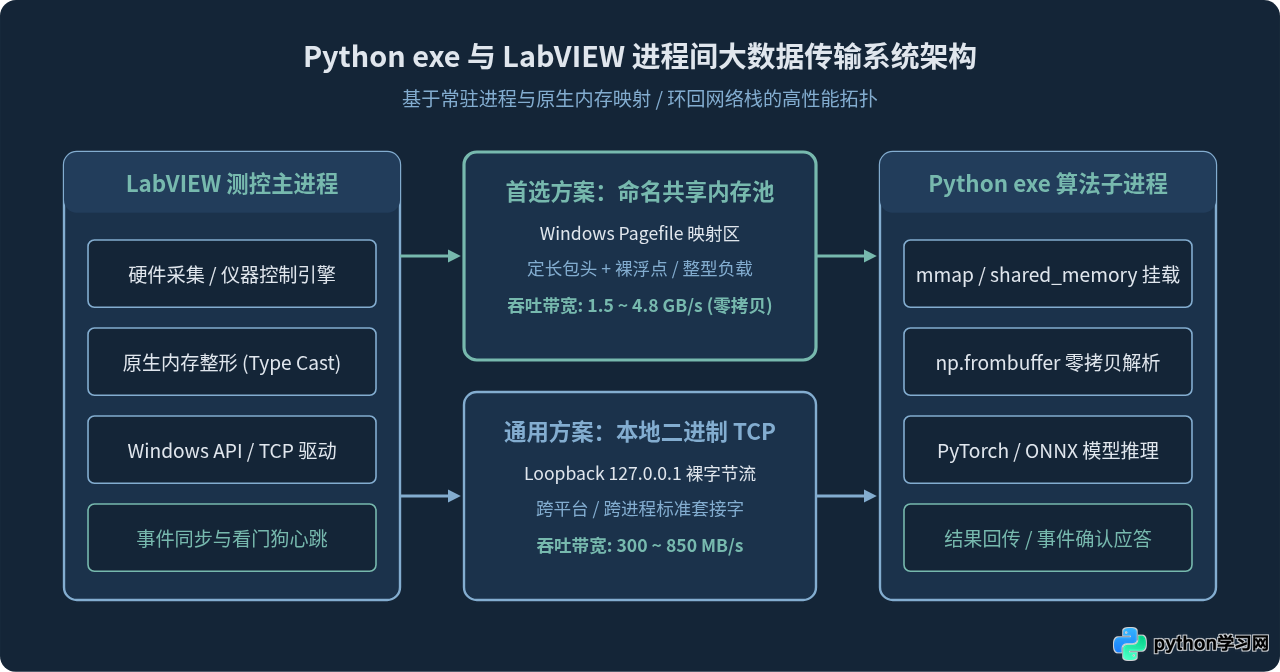
因此,解决该问题的核心在于:保持 Python exe 以后台守护进程形式常驻内存,并利用操作系统的内存映射机制或内核网络栈环回接口,以裸二进制(Raw Binary)形式进行零拷贝或单次拷贝传输。
二、主流进程间通信方案选型对比
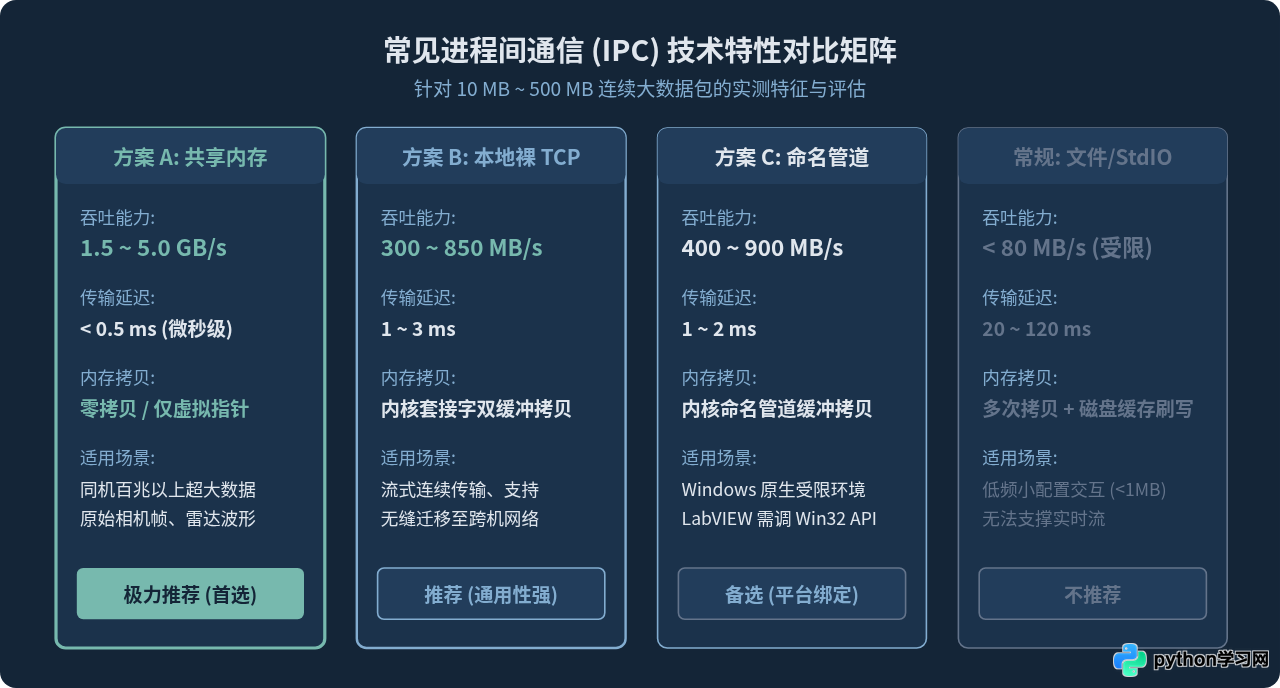
针对 Windows 环境下的独立进程通信,我们对比了工业界常用的四种技术方案在延迟、吞吐率、实现复杂度及开发维护成本上的综合表现:
三、方案 A:共享内存 + 命名事件同步机制(极致性能)
共享内存是同机两进程间传输大数据的最高性能方案。其原理是 Windows 操作系统在物理内存中开辟一块虚拟地址空间(通常基于分页文件 Pagefile),LabVIEW 与 Python exe 分别将其映射到各自的进程地址空间中。这样,LabVIEW 写入内存后,Python exe 即可直接通过指针读取,实现真正的零内存复制。
1. 数据帧协议设计
为避免两端由于数据尺寸动态变化导致越界,在共享内存首部必须规划固定长度的包头(Header),随后紧跟实际负载数据(Payload):
- Magic Code(4 字节,uint32):如
0x5A5AA5A5,用于校验内存是否已被正确初始化。 - Frame Index(4 字节,uint32):递增帧序号,便于 Python 诊断是否出现丢帧。
- Rows & Cols(各 4 字节,uint32):矩阵或多通道数据的行数与列数(如 1024 行 × 4096 列)。
- Data Type Code(4 字节,uint32):标明类型(如 1: float32, 2: int16, 3: double)。
- Data Length(8 字节,uint64):有效负载的精确字节长度。
- Raw Payload Buffer:从指定偏移量(如 64 字节)开始存放连续二进制数据。
2. 同步与并发控制
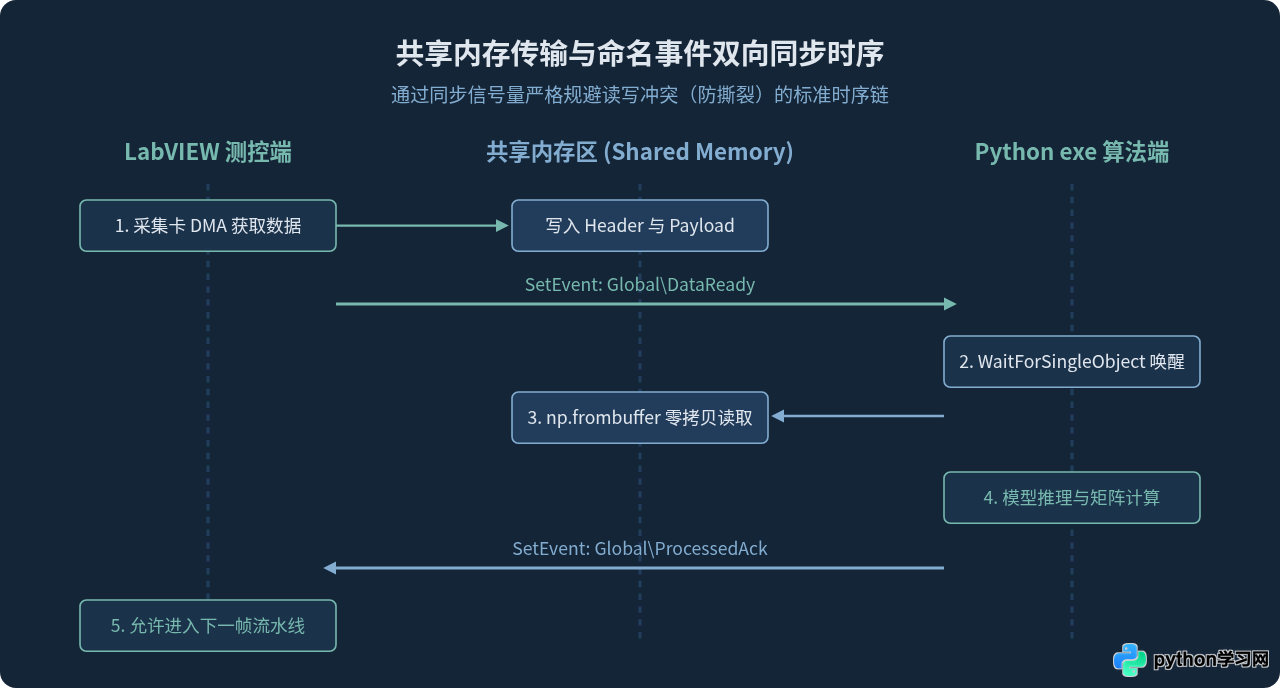
由于两进程异步运行,不能使用耗 CPU 的死循环轮询。推荐使用 Windows 原生命名事件(Named Event):
- 创建命名事件
Global\Event_LabVIEW_DataReady:LabVIEW 写完数据后触发(SetEvent)。 - 创建命名事件
Global\Event_Python_ProcessedAck:Python 处理完后触发,告知 LabVIEW 可以写入下一帧。
3. Python 端核心实现代码(包含打包兼容)
在 Python 中,通过标准库 mmap 或 multiprocessing.shared_memory 配合 win32event,可以简洁地完成挂载与数据重构。以下代码可直接通过 PyInstaller 打包:
import mmap
import struct
import numpy as np
import win32event
import win32api

SHM_NAME = "Global\\MyLabVIEW_SharedMemory"
SHM_SIZE = 64 * 1024 * 1024  # 64 MB 缓冲区
EVENT_READY = "Global\\Event_LabVIEW_DataReady"
EVENT_ACK = "Global\\Event_Python_ProcessedAck"

def run_worker():
    # 打开由 LabVIEW 初始化的命名共享内存
    shm = mmap.mmap(-1, SHM_SIZE, tagname=SHM_NAME, access=mmap.ACCESS_WRITE)

    # 打开 Windows 命名事件句柄
    h_ready = win32event.CreateEvent(None, False, False, EVENT_READY)
    h_ack = win32event.CreateEvent(None, False, False, EVENT_ACK)

    print("Python exe 算法引擎已启动,等待数据输入...")

    while True:
        # 等待 LabVIEW 写入完成信号,超时设定 5000ms
        wait_res = win32event.WaitForSingleObject(h_ready, 5000)
        if wait_res == win32event.WAIT_TIMEOUT:
            continue

        shm.seek(0)
        # 读取 64 字节包头: magic(4B), frame_id(4B), rows(4B), cols(4B), dtype(4B), data_len(8B)
        header_bytes = shm.read(28)
        magic, frame_id, rows, cols, dtype_code, data_len = struct.unpack("<IIIIIQ", header_bytes)

        if magic != 0x5A5AA5A5:
            continue  # 校验头错误

        # 零拷贝获取数据切片并转为 NumPy ndarray (假定传输 float32)
        shm.seek(64)  # 偏移至数据起始区
        raw_buffer = shm.read(data_len)
        data_matrix = np.frombuffer(raw_buffer, dtype=np.float32).reshape((rows, cols))

        # 执行实际算法运算(例如均值滤波或矩阵特征提取)
        feature_result = float(np.mean(data_matrix))

        # 将计算结果或处理状态回填至包头响应区,并触发 ACK
        win32event.SetEvent(h_ack)

if __name__ == "__main__":
    run_worker()
Call Library Function Node(调用库函数节点)直接加载系统核心动态库 kernel32.dll,调用 CreateFileMappingW、MapViewOfFile 以及 RtlMoveMemory(或使用开源成熟的 LabVIEW Shared Memory VI 库)。写入完成后调用 SetEvent 触发事件。四、方案 B:本地二进制 TCP 流式传输(高通用性)
如果开发团队希望降低 Windows 底层 Win32 API 与内存对齐的调试难度,或者未来可能将 Python 算法进程迁移到局域网内的 GPU 推理服务器上,**基于环回网卡(127.0.0.1)的本地裸二进制 TCP 流**是最稳健且兼具良好性能的选择。
1. 二进制传输协议
TCP 是字节流协议,存在粘包和拆包特性。绝不能依赖发送次数,必须在包头显式声明数据长度。协议定义如下:
- 帧起始标识(4 字节):固定为
0xAA55AA55。 - 有效载荷字节数 Payload Size(4 字节,大端 / 小端对齐):指明随后的数据长度。
- 矩阵形状维度信息(8 字节):两个 32 位整型分别代表维度 1 与维度 2。
- 裸数据体(N 字节):直接由 LabVIEW 的原生一维/二维数组经过强制类型转换(Type Cast)后生成的连续字节块。
2. Python exe 端高效接收逻辑
为了达到百兆以上的吞吐量,Python 端禁止在接收到字节后进行字符串拼接,必须预先分配内存并通过 socket.recv_into 填充缓冲区:
import socket
import struct
import numpy as np

HOST = "127.0.0.1"
PORT = 9999

def start_tcp_receiver():
    server = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    # 扩大系统接收缓冲区以适应瞬时大流量
    server.setsockopt(socket.SOL_SOCKET, socket.SO_RCVBUF, 16 * 1024 * 1024)
    server.bind((HOST, PORT))
    server.listen(1)

    print(f"TCP 接收端已就绪,正在监听 {HOST}:{PORT}...")
    conn, addr = server.accept()

    header_struct = struct.Struct("!III") # 大端: magic(4B), length(4B), frame_id(4B)
    header_size = header_struct.size

    while True:
        header_data = conn.recv(header_size)
        if not header_data:
            break

        magic, payload_len, frame_id = header_struct.unpack(header_data)
        if magic != 0xAA55AA55:
            continue

        # 预先分配定长内存块,利用 memoryview 零内存拷贝分块填充
        buffer = bytearray(payload_len)
        view = memoryview(buffer)
        bytes_received = 0

        while bytes_received < payload_len:
            nbytes = conn.recv_into(view[bytes_received:], payload_len - bytes_received)
            if nbytes == 0:
                raise ConnectionError("传输途中连接断开")
            bytes_received += nbytes

        # 直接使用 NumPy 解析二进制流
        data_array = np.frombuffer(buffer, dtype=np.float32)

        # 模拟响应:回传 4 字节的确认状态
        conn.sendall(struct.pack("!I", 1))

if __name__ == "__main__":
    start_tcp_receiver()
五、工程实施与避坑指南
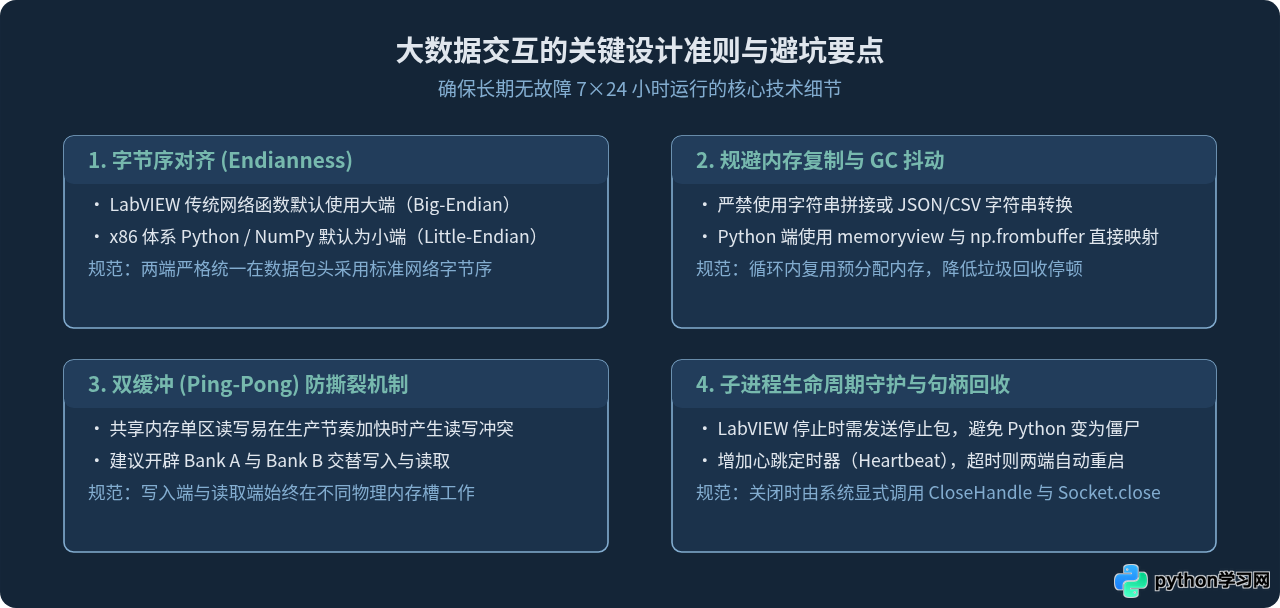
1. 字节序(Endianness)校准
LabVIEW 的 Flatten To String 节点以及默认网络函数使用的是大端格式(Big-Endian / 网络字节序),而 Windows 平台运行的 x86/x64 Python 解释器和 NumPy 默认采用小端格式(Little-Endian)。如果在 LabVIEW 端未进行转换,直接将单精度浮点数数组发送,Python 端直接解析将会变成完全错误的极大值或非数(NaN)。
解决办法:在 LabVIEW 发送前,通过 Swap Bytes 或 Swap Words 转换为小端;或者在 Python 端使用 np.dtype(">f4")(强制大端解析)直接读取:
# 若 LabVIEW 发送的是大端浮点流,NumPy 解析时指定 '>' 前缀即可直接零拷贝校正
data_array = np.frombuffer(raw_bytes, dtype=">f4")
2. 内存对齐与垃圾回收防抖动
在连续处理 100 MB/s 以上的数据流时,Python 频繁创建和销毁大尺寸 bytes 对象会导致 Python 内存分配器压力骤增,频繁触发完整的垃圾回收(GC Generation 2),造成程序出现数十毫秒的卡顿。建议在程序启动时一次性预先分配一个固定容量的 bytearray 缓冲区,全生命周期内重复使用 memoryview 切片写入。
3. PyInstaller 打包与依赖精简
将 Python 脚本打包为 exe 时,由于涉及多进程及动态库加载,建议在打包命令中指定关键参数:
pyinstaller --clean --noconfirm --onedir --console worker.py
尽量采用 --onedir(生成文件夹)而不是 --onefile(单文件)。单文件模式在每次启动时都会将几十兆的库文件解压到操作系统的 %TEMP% 临时文件夹,造成极其缓慢的启动延迟,不利于生产环境的热重载与调试。
六、总结与方案决策
在 Python exe 与 LabVIEW 的跨语言大数据集成场景中,必须摒弃低效的文本转换与磁盘文件过渡思路:
- 如果对吞吐量和延迟要求极为严苛(如传输 4K 原始工业相机图像、高速多通道示波器裸波形,吞吐需求 > 1 GB/s),共享内存 + Windows 命名事件是唯一能够消除 CPU 内存拷贝开销的极致方案。
- 如果系统更加看重架构解耦、协议调试便利性,或者未来有分布式多机部署需求,本地裸二进制 TCP 环回通信以数百 MB/s 的实用吞吐能力和极高稳定性,构成了性价比最高、最通用的工业级工程实践。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









