

Python多进程通信详解:管道、队列、共享内存与Socket实战

本文深入解析Python中五种主流进程间通信(IPC)机制。通过具体代码实例,详细演示无名管道、具名管道(FIFO)、消息队列(Queue)、共享内存及Socket通信的实现原理与用法。重点涵盖全双工/半双工管道配置、Queue容量限制与阻塞行为、共享内存映射原理及跨主机Socket通信流程,帮助开发者根据场景选择高效通信方案。
Python多进程通信概述
操作系统为每个创建的进程分配独立的地址空间,确保不同进程的内存完全隔离,使得它们在默认情况下互不可见。为了实现进程间的数据交换,必须借助特定的通信机制。本文旨在通过Python实例,简明阐述进程间通信(IPC)的关联方式与实现原理,帮助读者透过代码理解其本质。
下文将采用简明的方式介绍各类通信方式,具体细节建议参考官方文档。
管道通信(Pipe)
1. 管道
首先介绍最经典且基础的IPC方式:管道。通常指无名管道,其本质类似文件,仅存在于内存中,不持久化存储。不同进程通过系统接口向管道读写数据即可实现交互。
这种中间介质为进程提供了交流途径。无名管道的局限在于通常仅适用于具有直接关联的父子进程。以下通过简单示例展示其用法。
from multiprocessing import Process, Pipe

def pstart(pname, conn):
  conn.send("Data@subprocess")
  print(conn.recv())     # Data@parentprocess

if __name__ == '__main__':
  conn1, conn2 = Pipe(True)
  sub_proc = Process(target=pstart, args=('subprocess', conn2,))
  sub_proc.start()
  print (conn1.recv())    # Data@subprocess
  conn1.send("Data@parentprocess")
  sub_proc.join()
管道通信主要包含三个步骤:
- 创建Pipe,获取两个connection对象conn1和conn2;
- 父进程持有conn1,并将conn2传递给子进程;
- 父子进程通过持有的connection对象执行send和recv操作,完成数据的发送与接收;
上述示例创建的是全双工管道,也可创建半双工管道,具体用法请参考官网说明:
Returns a pair
(conn1, conn2)ofConnectionobjects representing the ends of a pipe.If duplex is
True(the default) then the pipe is bidirectional. If duplex isFalsethen the pipe is unidirectional:conn1can only be used for receiving messages andconn2can only be used for sending messages.
具名管道(FIFO)
2. 具名管道(FIFO)
前述管道主要适用于有直接关联的进程,适用范围有限。接下来介绍可在任意进程间通信的具名管道。
由于Windows平台的os模块未提供mkfifo属性,此示例仅在Linux环境下运行(测试环境为CentOS 7,Python 2.7.5):
#!/usr/bin/python
import os, time
from multiprocessing import Process

input_pipe = "./pipe.in"
output_pipe = "./pipe.out"

def consumer():
  if os.path.exists(input_pipe):
    os.remove(input_pipe)
  if os.path.exists(output_pipe):
    os.remove(output_pipe)

  os.mkfifo(output_pipe)
  os.mkfifo(input_pipe)
  in1 = os.open(input_pipe, os.O_RDONLY)    # read from pipe.in
  out1 = os.open(output_pipe, os.O_SYNC | os.O_CREAT | os.O_RDWR)
  while True:
    read_data = os.read(in1, 1024)
    print("received data from pipe.in: %s @consumer" % read_data)
    if len(read_data) == 0:
      time.sleep(1)
      continue

    if "exit" in read_data:
      break
    os.write(out1, read_data)
  os.close(in1)
  os.close(out1)

def producer():
  in2 = None
  out2 = os.open(input_pipe, os.O_SYNC | os.O_CREAT | os.O_RDWR)

  for i in range(1, 4):
    msg = "msg " + str(i)
    len_send = os.write(out2, msg)
    print("------product msg: %s by producer------" % msg)
    if in2 is None:
      in2 = os.open(output_pipe, os.O_RDONLY)    # read from pipe.out
    data = os.read(in2, 1024)
    if len(data) == 0:
      break
    print("received data from pipe.out: %s @producer" % data)
    time.sleep(1)

  os.write(out2, 'exit')
  os.close(in2)
  os.close(out2)

if __name__ == '__main__':
  pconsumer = Process(target=consumer, args=())
  pproducer = Process(target=producer, args=())
  pconsumer.start()
  time.sleep(0.5)
  pproducer.start()
  pconsumer.join()
  pproducer.join()
运行流程如下:
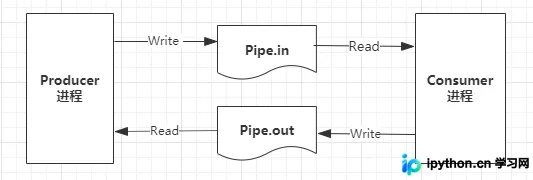
每一轮的处理过程如下:
- producer进程向pipe.in文件写入消息数据;
- consumer进程从pipe.in文件读取消息数据;
- consumer进程向pipe.out文件写入回执消息数据;
- producer进程从pipe.out文件读取回执消息数据;
运行结果如下:
[shijun@localhost python]$ python main.py
------product msg: msg 1 by producer------
received data from pipe.in: msg 1 @consumer
received data from pipe.out: msg 1 @producer
------product msg: msg 2 by producer------
received data from pipe.in: msg 2 @consumer
received data from pipe.out: msg 2 @producer
------product msg: msg 3 by producer------
received data from pipe.in: msg 3 @consumer
received data from pipe.out: msg 3 @producer
received data from pipe.in: exit @consumer
两个进程无需直接关联,只要各自拥有读写文件且文件路径相互对应,即可实现通信。
消息队列(Queue)
3. 消息队列(Queue)
进程通过向队列添加数据或从队列获取数据来传递消息。以下是一个简单示例。
from multiprocessing import Process, Queue
import time

def producer(que):
  for product in ('Orange', 'Apple', ''):
    print('put product: %s to queue' % product)
    que.put(product)
    time.sleep(0.5)
    res = que.get()
    print('consumer result: %s' % res)

def consumer(que):
  while True:
    product = que.get()
    print('get product:%s from queue' % product)
    que.put('suc!')
    time.sleep(0.5)
    if not product:
      break

if __name__ == '__main__':
  que = Queue(1)
  p = Process(target=producer, args=(que,))
  c = Process(target=consumer, args=(que,))
  p.start()
  c.start()
  p.join()
  c.join()
该示例较为简单,Queue的具体用法可参考官网文档。
运行结果:
put product: Orange to queue
consumer result: suc!
put product: Apple to queue
consumer result: suc!
put product: to queue
consumer result: suc!
get product:Orange from queue
get product:Apple from queue
get product: from queue
此处需注意以下几点:
- 可指定队列容量,若超出容量将触发Full异常:raise Full;
- 默认情况下,put和get操作均会阻塞当前进程;
- 若put未设置为阻塞模式,进程可能从队列中取出自己放入的数据;
共享内存机制
4. 共享内存
共享内存是一种常用且高效的进程间通信方式。为保证访问的有序性,需对进程采取额外的同步措施。
以下示例简要演示了Python中如何在不同进程间利用共享内存进行通信。
from multiprocessing import Process
import mmap
import contextlib
import time

def writer():
  with contextlib.closing(mmap.mmap(-1, 1024, tagname='cnblogs', access=mmap.ACCESS_WRITE)) as mem:
    for share_data in ("Hello", "Alpha_Panda"):
      mem.seek(0)
      print('Write data:== %s == to share memory!' % share_data)
      mem.write(str.encode(share_data))
      mem.flush()
      time.sleep(0.5)

def reader():
  while True:
    invalid_byte, empty_byte = str.encode('\x00'), str.encode('')
    with contextlib.closing(mmap.mmap(-1, 1024, tagname='cnblogs', access=mmap.ACCESS_READ)) as mem:
      share_data = mem.read(1024).replace(invalid_byte, empty_byte)
      if not share_data:
        """ 当共享内存没有有效数据时结束reader """
        break
      print("Get data:== %s == from share memory!" % share_data.decode())
    time.sleep(0.5)


if __name__ == '__main__':
  p_reader = Process(target=reader, args=())
  p_writer = Process(target=writer, args=())
  p_writer.start()
  p_reader.start()
  p_writer.join()
  p_reader.join()
执行结果:
Write data:== Hello == to share memory!
Write data:== Alpha_Panda == to share memory!
Get data:== Hello == from share memory!
Get data:== Alpha_Panda == from share memory!
下面简要说明共享内存的原理;
进程虚拟地址到物理地址的映射关系如下:
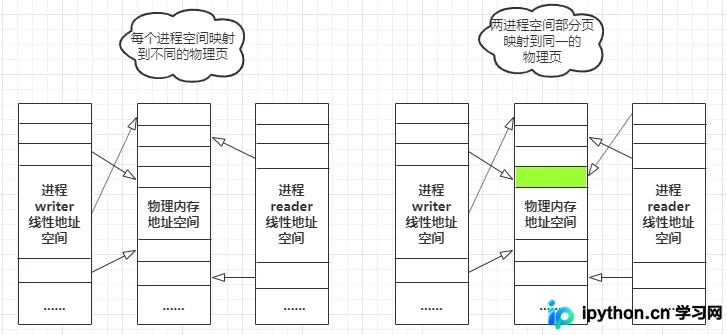
上图清晰展示了共享内存的工作原理。
左侧为正常情况,不同进程的线性地址空间映射到不同的物理内存页,其他进程修改物理内存不会影响当前进程;
右侧表示共享内存情况,不同进程的部分线性地址映射到同一物理页,一个进程对该物理页的修改会立即对另一个进程可见;
潜在问题在于需采取进程同步措施,即对共享内存的访问必须互斥,这可通过信号量实现。
Socket通信
5. socket通信
最后介绍一种支持跨主机进程间通信的方式:socket。
熟悉网络编程的读者对此应不陌生。Socket不仅支持跨主机通信,有时也可用于同一主机上不同进程间的通信。
这部分代码较为常见,此处仅使用流程图展示socket通信的流程及相关接口。
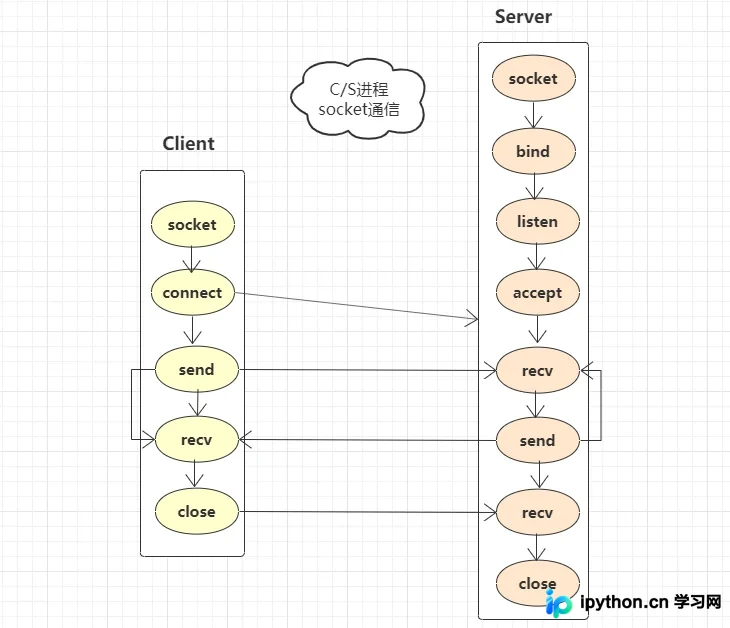
上图展示了客户端某进程与服务器监听程序进行socket通信的流程。
小结
至此,已简要介绍了常见进程间通信的相关概念与实例。希望本文能帮助您更深入地理解进程间通信。
结合此前关于线程、进程概念及线程同步措施的介绍,相信您已对线程和进程相关概念有了清晰的认识。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









