

Python中用NumPy创建矩阵的常用方法
全面介绍在Python中使用NumPy创建二维矩阵的常用方法,涵盖已有数据转换、特殊常数矩阵、序列变形重塑、单位与对角矩阵以及随机矩阵生成,提供清晰规范的代码示例与维度控制技巧。
在 Python 科学计算与工程分析中,矩阵通常使用 NumPy 的二维数组(ndarray)来承载与运算。虽然早期的 NumPy 提供了专用的 numpy.matrix 类,但官方目前已明确建议统一采用二维 ndarray 进行矩阵表达与计算。本文全面梳理从已有数据转换、特殊常数填充、序列变换重塑、特殊对角矩阵到随机矩阵生成的全套常用创建方法,帮助读者根据具体计算场景快速选择最适用的构造手段。
一、核心认知:NumPy 中的二维矩阵与维度规范
在编写代码前,必须厘清两个关键机制:矩阵的载体类型与多维数组的轴向组织。
首先,早期教程中经常出现 np.mat() 或 np.matrix(),它们会强行将变量限定在二维空间中,并重载乘法运算符 * 为矩阵乘法。然而在现代 NumPy 标准中,官方已明确不推荐(discouraged)使用 np.matrix 类,建议统一使用标准的二维 np.ndarray。在 ndarray 架构下,矩阵点乘通过 @ 运算符或 np.matmul() / np.dot() 完成,元素逐位相乘使用 *,转置操作使用 .T 属性。这种写法语义清晰且能无缝兼容更高维度的张量计算。
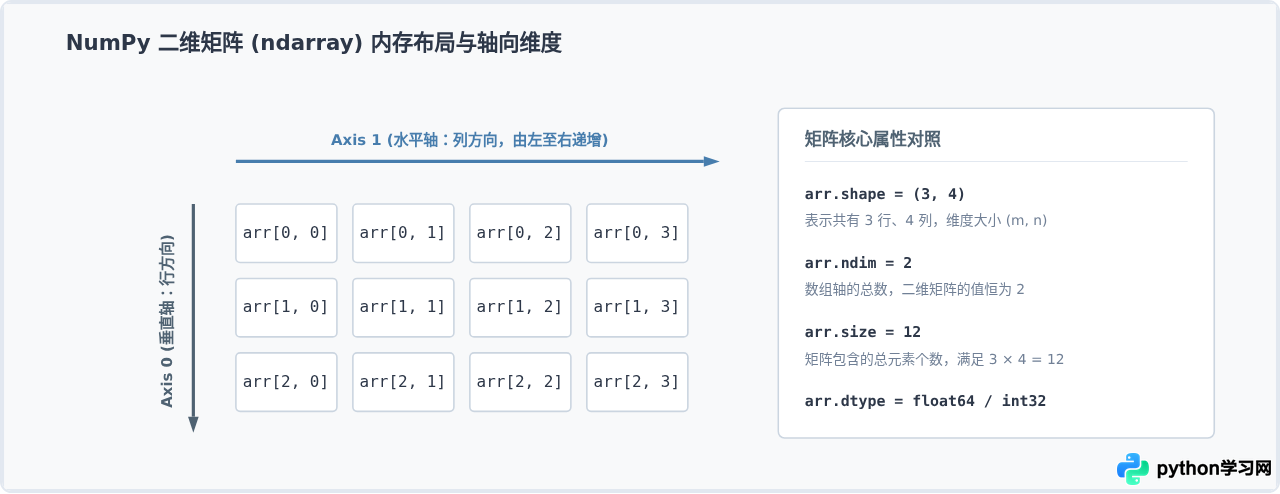
其次,二维矩阵的形状(Shape)由一个两元组 (m, n) 定义,分别对应行数(rows)与列数(columns):
- Axis 0(垂直轴):沿着行方向纵向延伸,坐标对应第 0 行、第 1 行、直到第 m-1 行;
- Axis 1(水平轴):沿着列方向横向延伸,坐标对应第 0 列、第 1 列、直到第 n-1 列。
二、从 Python 原生嵌套列表转换:np.array()
当手头已有固定的数值,或从文件解析出了行列表数据时,最直接的方法是使用 np.array() 将 Python 嵌套列表或元组转换为二维矩阵。
嵌套列表的外层列表代表行序列,内层每个子列表代表该行中的各个列元素。传入时必须确保每个内层子列表的长度完全一致,否则无法构成合法的二维矩形结构。
import numpy as np

# 通过二维嵌套列表创建 3x3 整数矩阵
matrix_a = np.array([
    [10, 20, 30],
    [40, 50, 60],
    [70, 80, 90]
])

print("矩阵维度:", matrix_a.shape)
print("矩阵内容:\n", matrix_a)

# 示例输出:
# 矩阵维度: (3, 3)
# 矩阵内容:
#  [[10 20 30]
#   [40 50 60]
#   [70 80 90]]
在创建时,还可以通过 dtype 参数强制指定元素在底层内存中的存储类型,例如 np.float32、np.float64 或 np.int32:
# 显式指定数据类型为单精度浮点数 float32
matrix_float = np.array([[1, 2], [3, 4]], dtype=np.float32)

print("数据类型:", matrix_float.dtype)
print("内容:\n", matrix_float)

# 示例输出:
# 数据类型: float32
# 内容:
#  [[1. 2.]
#   [3. 4.]]
三、快速生成特定数值的矩阵:zeros、ones 与 full
在算法迭代、模型权重初始化或预分配内存空间时,往往不需要手动编写元素列表,而是需要直接生成指定尺寸的初始矩阵。NumPy 针对这一场景提供了几个高度优化的内置函数:
1. 全零矩阵:np.zeros()
生成所有元素皆为 0 的矩阵。首个参数必须是表示形状的元组 (m, n),默认数据类型为双精度浮点数 float64。
# 创建 2 行 4 列的全 0 浮点矩阵
zero_mat = np.zeros((2, 4))
print(zero_mat)

# 示例输出:
# [[0. 0. 0. 0.]
#  [0. 0. 0. 0.]]
2. 全一矩阵:np.ones()
生成所有元素皆为 1 的矩阵。同样接收形状元组 (m, n),常用于掩码(mask)初始化或偏置矩阵的预填充。
# 创建 3 行 2 列的整数 1 矩阵
ones_mat = np.ones((3, 2), dtype=int)
print(ones_mat)

# 示例输出:
# [[1 1]
#  [1 1]
#  [1 1]]
3. 常数填充矩阵:np.full()
如果需要填充任意指定常数(例如全 7 或全 -1),无需先生成全 1 矩阵再做乘法,直接调用 np.full(shape, fill_value) 执行速度更快、表达更直观。
# 创建 2 行 3 列、全部填充为 8.5 的矩阵
full_mat = np.full((2, 3), 8.5)
print(full_mat)

# 示例输出:
# [[8.5 8.5 8.5]
# [8.5 8.5 8.5]]注意内存开销:如果需要快速开辟大尺寸矩阵并在随后立即全部覆写,可使用 np.empty((m, n))。它只向系统申请指定内存空间而不做数值初始化,元素值将是未清除的内存随机垃圾数据,因而比 zeros() 速度更快,但使用前必须确保所有位置均被正确写入。
四、构造特殊方阵:单位矩阵与对角矩阵
在线性代数计算(如特征值分解、解线性方程组或正则化项构建)中,单位矩阵和对角矩阵是两类最常见的基础结构。
1. 单位矩阵:np.eye() 与 np.identity()
两者的主对角线元素均为 1,其余元素均为 0。它们在功能上有细微差异:
np.identity(n):仅能生成n × n的严格方阵;np.eye(N, M=None, k=0):更为灵活,支持生成非方阵(N行M列),且可以通过参数k指定对角线偏移量(k=0代表主对角线,k>0代表主对角线上方偏移,k<0代表主对角线下方偏移)。
# 1. 创建 3x3 标准单位方阵
eye_3x3 = np.eye(3)
print("3x3 单位矩阵:\n", eye_3x3)

# 2. 创建 3 行 4 列、对角线上移 1 位的矩阵 (k=1)
eye_offset = np.eye(3, 4, k=1)
print("偏移对角矩阵 (k=1):\n", eye_offset)

# 示例输出:
# 3x3 单位矩阵:
#  [[1. 0. 0.]
#   [0. 1. 0.]
#   [0. 0. 1.]]
# 偏移对角矩阵 (k=1):
#  [[0. 1. 0. 0.]
#   [0. 0. 1. 0.]
#   [0. 0. 0. 1.]]
2. 对角矩阵:np.diag()
np.diag() 具有智能双重作用:
- 构建矩阵:当传入一维数组
v时,它会返回一个以v为主对角线、其余位置补 0 的二维对角方阵; - 提取对角线:当传入二维矩阵时,它会抽取出该矩阵的对角线元素并返回一维数组。
# 传入一维数组构建对角矩阵
diag_matrix = np.diag([5, 10, 15])
print("构建对角矩阵:\n", diag_matrix)

# 示例输出:
# 构建对角矩阵:
#  [[ 5  0  0]
#   [ 0 10  0]
#   [ 0  0 15]]
五、数值序列变形重塑:arange/linspace + reshape()
在测试数值算法或构造网格矩阵时,经常需要包含连续或等间隔数值的规则矩阵。NumPy 的标准做法是:先生成一维规律序列,再通过 .reshape(m, n) 方法将其重新组织为目标二维矩阵。
1. 等差整数序列矩阵:np.arange().reshape()
np.arange(start, stop, step) 生成半开区间 [start, stop) 内的数值。通过 .reshape((m, n)),元素会按照行优先(C-order)顺序依次填入矩阵各行。
# 生成包含 0 到 11 的一维序列,并变形为 3 行 4 列矩阵
seq_matrix = np.arange(12).reshape(3, 4)
print(seq_matrix)

# 示例输出:
# [[ 0  1  2  3]
#  [ 4  5  6  7]
#  [ 8  9 10 11]]
2. 等间距浮点数矩阵:np.linspace().reshape()
当需要在指定物理区间内均匀采集固定点数时,使用 np.linspace(start, stop, num)。其生成的区间两端默认均为闭区间。
# 在 0 到 1 之间均匀采样 6 个点,重组为 2 行 3 列浮点矩阵
grid_mat = np.linspace(0, 1, 6).reshape(2, 3)
print(grid_mat)

# 示例输出:
# [[0.  0.2 0.4]
#  [0.6 0.8 1. ]]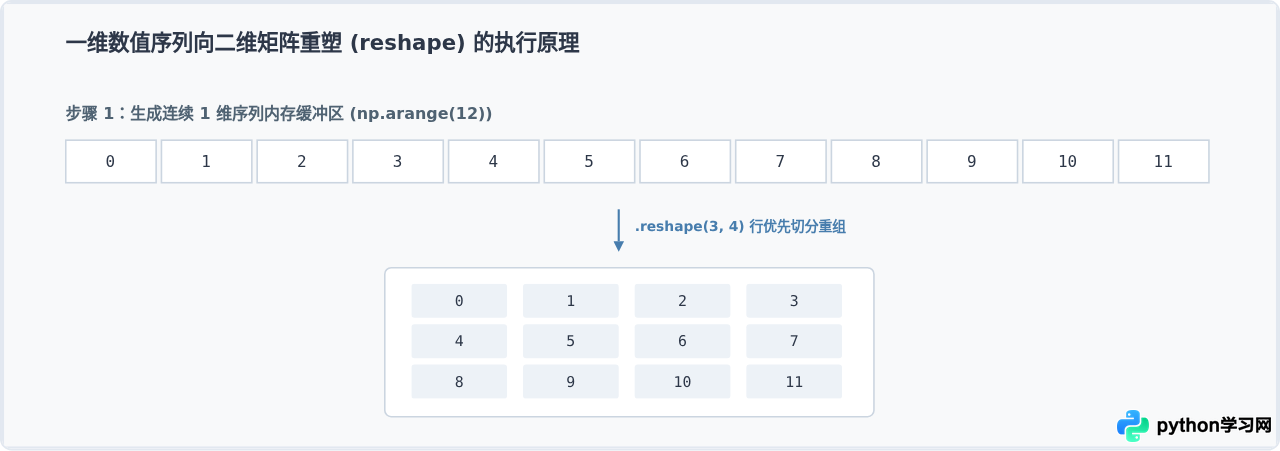
六、生成随机分布矩阵:np.random 模块
在模拟实验、神经网络权重初始化或蒙特卡洛算法中,需要构建服从特定概率分布的随机数值矩阵。NumPy 的 random 模块提供了丰富的分布支持:
1. 0 到 1 均匀分布矩阵:rand() 与 random()
生成每个元素都在 [0.0, 1.0) 区间内均匀分布的矩阵。注意传参差异:np.random.rand(d0, d1) 直接接收多个整数作为维度,而 np.random.random(size) 接收形状元组。
# 创建 2 行 3 列的均匀分布随机矩阵
rand_mat = np.random.rand(2, 3)
print("均匀分布矩阵:\n", rand_mat)
2. 标准正态分布矩阵:randn()
生成的元素服从均值为 0、标准差为 1 的高斯正态分布($X \sim \mathcal{N}(0, 1)$)。传参方式同 rand(),直接传入行列整数。
# 创建 3x3 标准正态分布矩阵
randn_mat = np.random.randn(3, 3)
print("标准正态分布矩阵:\n", randn_mat)
3. 随机整数矩阵:randint()
当需要生成离散状态矩阵时,调用 np.random.randint(low, high, size),生成区间 [low, high) 内的随机整数。
# 生成元素在 1 到 100 之间(左闭右开)的 3x4 整数矩阵
randint_mat = np.random.randint(1, 101, size=(3, 4))
print("随机整数矩阵:\n", randint_mat)
七、创建矩阵的关键参数与高频易错点
初学者在利用 NumPy 创建矩阵时,极易踩入以下几个语法与机制陷阱:
避坑 1:形状参数的括号丢失
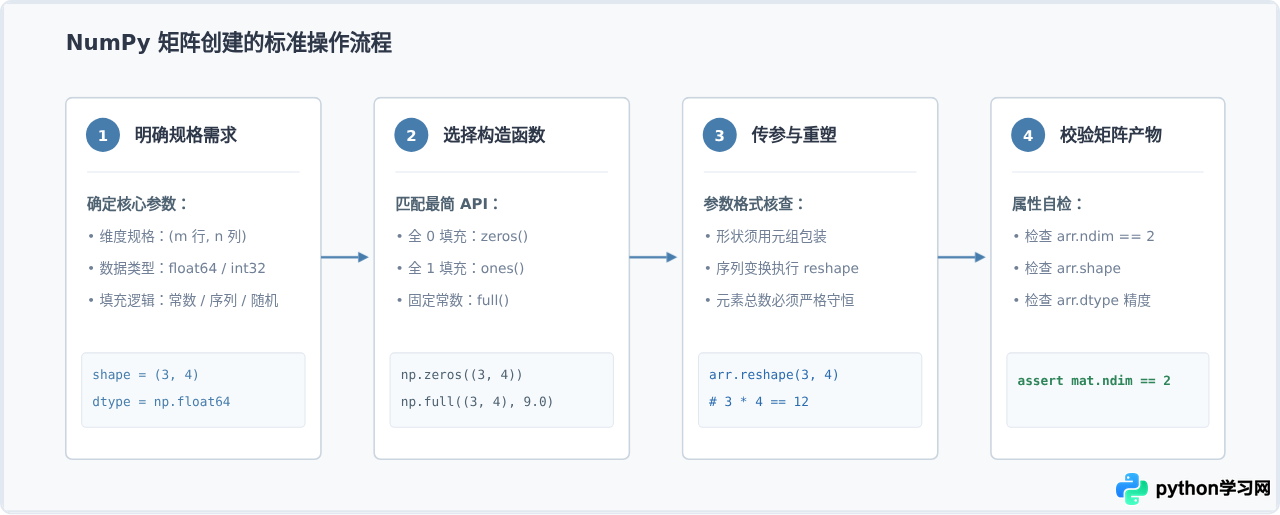
np.zeros、np.ones、np.empty 的第一个参数是形状元组。写成 np.zeros(3, 4) 会报错 TypeError: Field elements must be 2- or 3-tuples,因为第二个参数 4 会被误识别为 dtype 参数。必须明确写成元组形式:np.zeros((3, 4))。
与此相对,np.random.rand(3, 4) 和 np.random.randn(3, 4) 接收的却是解包参数(直接传整数)。这是历史 API 设计不一致遗留的特点,写代码时必须区分。
避坑 2:reshape 元素总数不匹配
调用 .reshape(m, n) 时,$m \times n$ 的乘积必须与源数组的总元素数严格相等。如果不确定其中一个维度,可以传入 -1 让 NumPy 自动推导计算,例如 arr.reshape(3, -1) 会根据总元素数自动计算出对应的列数。
避坑 3:视图(View)与副本(Copy)的内存混淆
使用 reshape() 生成的二维矩阵通常只是原一维数组的一个视图(View),两者共享同一块底层内存。修改矩阵中的某一个单元格,原一维数组中的数值也会同步改变。如果需要完全独立的副本,必须显式调用 .copy()。
八、常用方法速查与决策总结
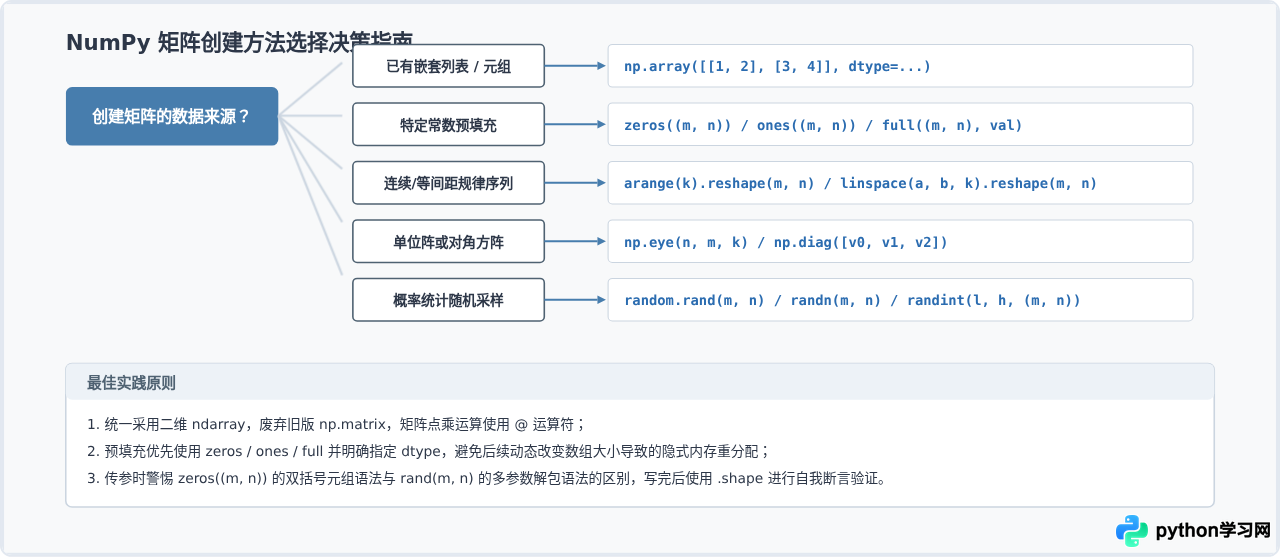
为了在实际编码时快速查阅并准确选取最适用的函数,下表总结了各类常用矩阵创建函数的参数形式与典型输出:
| 方法名称 | 核心参数示例 | 形状输入形式 | 典型适用场景 |
|---|---|---|---|
np.array() |
np.array([[1, 2], [3, 4]]) |
由嵌套列表自推导 | 已有 Python 列表转换、硬编码固定矩阵 |
np.zeros() |
np.zeros((3, 4)) |
形状元组 (m, n) |
数值累加容器预分配、全 0 掩码 |
np.ones() |
np.ones((2, 3)) |
形状元组 (m, n) |
乘法单位元、模型偏置项基底 |
np.full() |
np.full((3, 3), 7.5) |
形状元组 (m, n) |
任意特定常数填充矩阵 |
np.eye() |
np.eye(4, k=0) |
整数尺寸 N, [M] |
单位方阵、主对角线上/下偏移矩阵 |
np.diag() |
np.diag([1, 2, 3]) |
一维数组 / 列表 | 对角矩阵构造、协方差矩阵对角线提取 |
np.arange().reshape() |
np.arange(12).reshape(3, 4) |
重塑元组 (m, n) |
连续等差整数序列构成的网格矩阵 |
np.linspace().reshape() |
np.linspace(0, 1, 9).reshape(3, 3) |
重塑元组 (m, n) |
等间距实数网格、物理空间采样点阵 |
np.random.rand() |
np.random.rand(3, 3) |
可变参数 m, n |
[0, 1) 区间均匀分布随机矩阵 |
np.random.randn() |
np.random.randn(3, 3) |
可变参数 m, n |
标准高斯正态分布矩阵 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









