

Python多进程共享NumPy数组的实现方案

发布时间:2026-10-14| 5人浏览过
本文介绍在Python多进程环境下共享大型NumPy数组的方法,以解决数据复制导致的内存浪费问题。通过multiprocessing.Array创建共享内存,并利用numpy.frombuffer和reshape将其封装为NumPy数组,实现进程间高效数据访问。文中提供了完整的代码示例及运行结果分析。
为什么要使用NumPy
Python内置的list容器常被用作数组,但由于其元素可以是任意对象,因此列表实际存储的是指向对象的指针。例如,存储简单的列表[1, 2, 3]需要三个指针和三个整数对象,这种结构在进行数值运算时效率较低。虽然Python提供了array模块,但它仅支持一维数组,缺乏多维数组支持(而在TensorFlow等框架中通常涉及矩阵概念)以及丰富的运算函数,因此不适合复杂的数值计算。NumPy的出现填补了这一空白,提供了高效的多维数组对象和丰富的数学运算支持。
引用:https://zhuanlan.zhihu.com/p/32513483
共享NumPy数组的实现
在处理大规模数据时,直接复制数组会导致巨大的内存开销。通过共享NumPy数组可以有效解决这一问题。具体实现方式是利用前文提到的Array机制创建共享内存块,然后使用numpy.frombuffer函数将该共享内存转换为NumPy数组,并通过reshape调整形状,从而在多个进程间共享数据。以下是具体的代码实现:
# encoding:utf8
import ctypes
import os
import multiprocessing

import numpy as np

NUM_PROCESS = multiprocessing.cpu_count()


def worker(index):
    main_nparray = np.frombuffer(shared_array_base, dtype=ctypes.c_double)
    main_nparray = main_nparray.reshape(NUM_PROCESS, 10)
    pid = os.getpid()
    main_nparray[index, :] = pid
    return pid


if __name__ == "__main__":
    shared_array_base = multiprocessing.Array(
        ctypes.c_double, NUM_PROCESS * 10, lock=False)
    pool = multiprocessing.Pool(processes=NUM_PROCESS)
    result = pool.map(worker, range(NUM_PROCESS))
    main_nparray = np.frombuffer(shared_array_base, dtype=ctypes.c_double)
    main_nparray = main_nparray.reshape(NUM_PROCESS, 10)
    print( main_nparray )
运行结果:
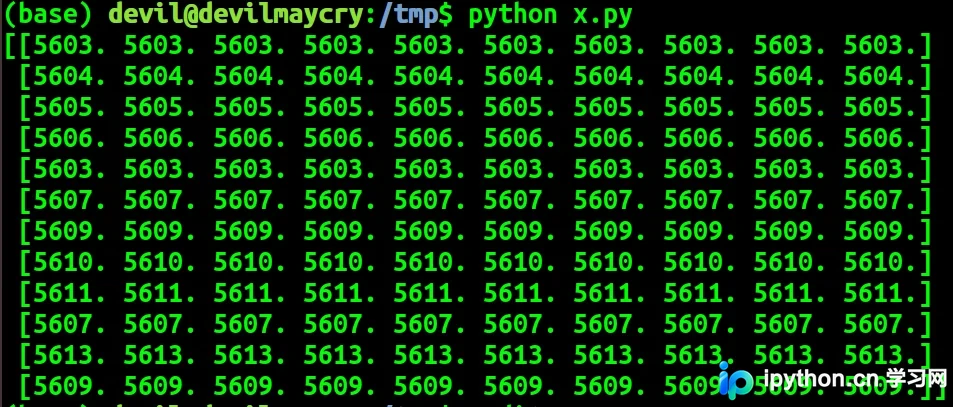
至此,关于Python多进程共享NumPy数组的方法介绍完毕。如需了解更多相关Python多进程内容,建议查阅本站往期文章或继续浏览后续相关教程。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









