

数据科学必备:为什么Jupyter Notebook是Python数据分析的首选IDE
深入解析Jupyter Notebook成为Python数据分析与数据科学首选IDE的核心原因,剖析交互式计算架构、分块执行机制、工作流闭环以及与传统工程IDE的差异。
在数据科学与数据分析场景中,开发者面对的不是固定的输入输出流水线,而是一个充满未知的探索过程:需要频繁检查数据分布、测试统计假设、即时观察绘图结果并不断修正参数。Jupyter Notebook 凭借“状态常驻内存”的分块交互执行机制、高度集成的图文排版能力以及与 IPython 底层的解耦设计,填补了传统脚本式 IDE 在试错成本与探索敏捷度上的结构性短板,因而成为数据分析领域的标配工作台。
一、探索性数据分析的痛点与交互式计算的本质
如果你用纯脚本方式在传统 IDE(如 PyCharm 或 VS Code)中进行数据分析,最常见的一个痛苦体验是:为了调试第 80 行的一处绘图颜色设置,你不得不重新运行前 79 行——从磁盘加载数个几百兆的 CSV 文件、执行耗时 3 分钟的分组聚合运算。这种“全量重新启动进程”的机制在普通软件开发中保证了状态干净,但在数据科学中却将探索节拍彻底撕碎。
数据科学的核心特征是“探索驱动”(Exploratory Data Analysis, EDA)。分析人员在刚拿到数据集时,通常并不知道最终的算法或图表形态,而是需要逐步敲开数据外壳:先看 df.head() 确认列名,再做 df.describe() 查看极值与分位数,发现缺失值后再试验不同填充方案。
Jupyter Notebook 的解决之道在于引入了**独立分块执行单元(Cell)**与**持久化内核进程(Kernel)**。一旦数据集被读入内存,只要 Kernel 没有重启,所有变量、DataFrame 和拟合模型就会一直驻留在内存中。后续无论是在新单元格中调用可视化函数,还是切片过滤某些字段,都可以以毫秒级速度直接使用现有内存对象。
二、底层解耦设计:Web 前端、Server 与 IPython Kernel
很多初学者把 Jupyter 简单理解为一个“网页版 Python 编辑器”,其实它的底层架构有着严格的模块解耦。Jupyter 体系结构由三大部分组成:
- 前端界面(Web Browser / Client):用户通过网页交互或支持 Notebook 协议的客户端输入代码、Markdown 和交互式小部件(Widgets)。
- Jupyter Server(Tornado HTTP / WebSocket 服务):负责监听网络请求、管理文件存储(
.ipynb格式的 JSON 文件)、分发会话,并通过 WebSocket 协议与浏览器保持实时全双工通信。 - 计算内核(IPython Kernel):独立的底层执行进程。Server 与 Kernel 之间通过高性能的 ZeroMQ 消息队列进行协议通信,包括心跳监测、标准输入输出流(IOPub / Stdin)以及执行请求(Shell 通道)。
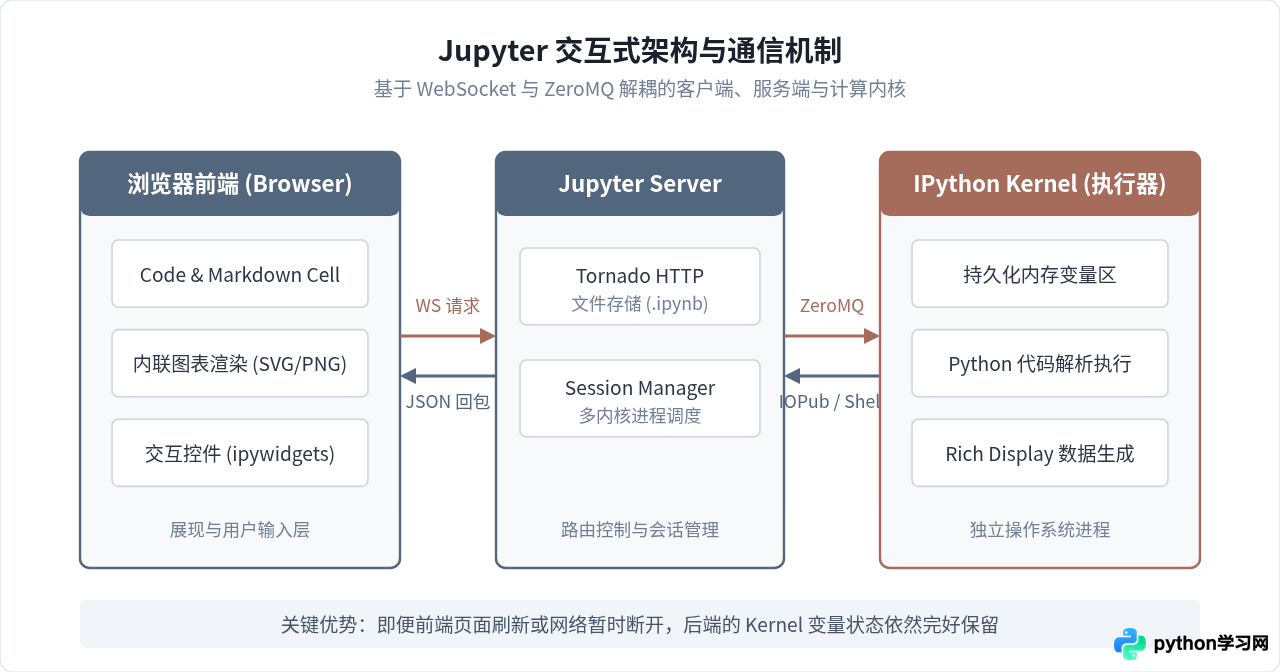
这种解耦带来了一个极为重要的工程优势:执行环境与展现环境分离。你可以把 Jupyter Server 和 Kernel 部署在机房配有高显存 GPU、大内存的高性能计算服务器上,而数据分析师只需在轻薄笔记本的浏览器中打开 URL,就能享用远端算力与数据。
三、核心操作工作流:从数据加载到迭代成型
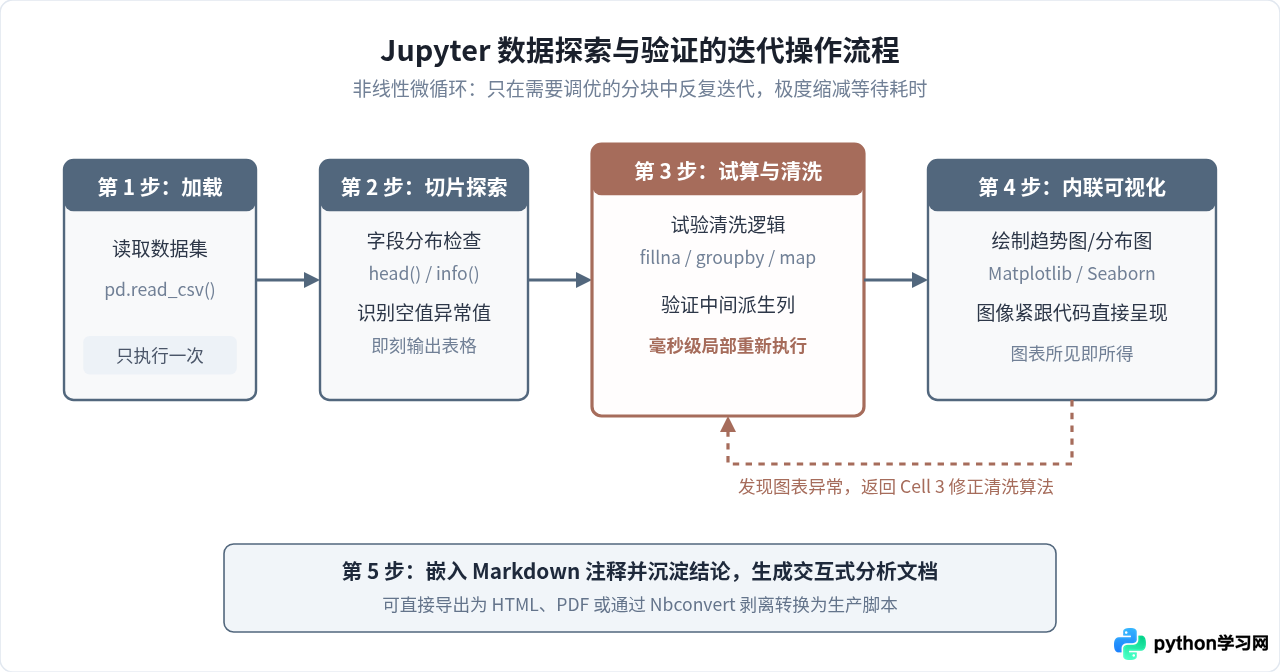
在实际工作中,数据分析师使用 Jupyter Notebook 的典型步骤并非自上而下单向执行到底,而是一个紧凑的“试探-观察-修正”闭环:
- 准备与初始化环境:导入 Pandas、NumPy、Matplotlib、Seaborn 等常用库,并使用
%matplotlib inline等魔术命令配置富媒体输出。 - 数据加载与内存驻留:一次性读取大规模数据文件,将其转化为 DataFrame 驻留内存。
- 切片检验与清洗验证:在独立 Cell 中执行去重、空值填充或字段映射,执行后紧接着打印统计概览或
.info()输出。 - 内联可视化与特征洞察:调用绘图库直接在代码下方渲染直方图、散点图或热力图,无需跳转弹出窗口。
- 固化逻辑与输出分析报告:通过 Markdown 单元格记录分析思路与业务结论,形成结构清晰、图文并茂的数据说明书。
实战示例:体验分块执行与即时绘图
为了直观理解这种工作模式,我们来看一段典型的 Notebook 操作片段。在分析时,我们把数据生成与可视化拆分在两个连续的单元格中:
# [Cell 1] 数据加载与特征准备(执行一次,常驻内存)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

np.random.seed(42)
dates = pd.date_range('2026-01-01', periods=100)
sales = np.random.normal(loc=200, scale=30, size=100).cumsum()
df = pd.DataFrame({'date': dates, 'sales': sales})

# 查看前 5 行确认数据形态
df.head()
执行完上述 Cell 后,DataFrame df 就已经在内存中生成完毕。此时如果需要修改下游图表的展示参数(例如添加 7 日移动平均线或修改线条颜色),只需要在下方 Cell 独立运行:
# [Cell 2] 动态可视化(反复调试运行,耗时仅几毫秒)
df['ma_7'] = df['sales'].rolling(window=7).mean()

plt.figure(figsize=(10, 4))
plt.plot(df['date'], df['sales'], label='Daily Sales', color='#52677D', alpha=0.6)
plt.plot(df['date'], df['ma_7'], label='7-Day MA', color='#A66C5B', linewidth=2)
plt.title('Sales Trend Exploration')
plt.xlabel('Date')
plt.ylabel('Volume')
plt.legend()
plt.tight_layout()
plt.show()
无论你在 [Cell 2] 中修改了多少次图表标题、配色或滑动窗口参数,[Cell 1] 里的原始数据都不会被重新计算或重复读取。这种敏捷度正是日常探索工作的刚需。
四、深度对比:Jupyter 与传统工程 IDE 的权衡
很多初学者常有一个疑问:“既然 VS Code 和 PyCharm 拥有强大的代码自动补全、断点调试和重构功能,为什么数据科学家不一开始就用它们编写纯 Python 脚本?”
原因在于两者的设计哲学服务于完全不同的目标场景:
- 通用工程 IDE 面向确定性软件工程:目标是构建模块化、低耦合、经过严格单元测试、能在无人值守服务器上稳定运行的服务或包。这类场景重视类型提示、语法检查、代码规范、Git 版本合并。
- Jupyter Notebook 面向探索性科学研究与商业决策:目标是验证假说、洞察规律、寻找模式。此时代码往往伴随大量表格输出和图像,代码本身就是思考过程与实验笔记的载体(Literate Computing,文学化编程)。
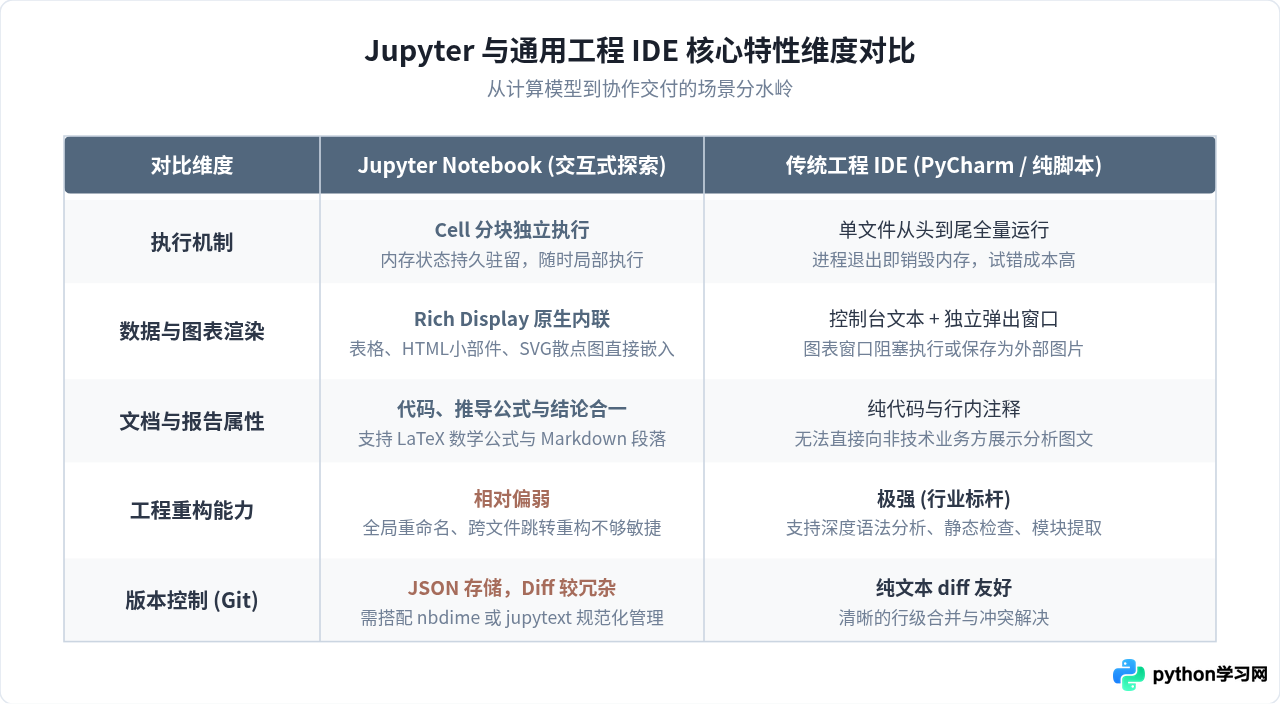
值得一提的是,目前业界主流的开发者体验正在走向**融合**:VS Code 与 PyCharm 均内置了对 .ipynb 的直接渲染与执行支持。你可以直接在 VS Code 中启动 Jupyter Kernel,既享受右键重命名、Git 变更标注等工程利器,又完整保留了 Cell 分块执行与富媒体内联输出。但其背后的核心理念与交互协议,依然完全沿袭了 Jupyter 的交互式计算范式。
五、常见陷阱与工程边界:如何正确驾驭 Notebook
.ipynb 文件提交到生产环境,会带来极大的维护隐患。
为了避免将 Notebook 用成“难以复现的草稿本”,在日常数据分析中应遵循以下三条工程准则:
-
谨防“无序执行陷阱”(Hidden State):Notebook 允许用户跳跃式运行单元格(例如先跑第 5 块,再回过头跑第 2 块)。这可能导致当前内存中的变量状态与页面上自上而下的代码展示不一致。
解决规范:在提交分析结果或共享前,务必点击Kernel -> Restart & Run All,确保整篇 Notebook 从第一行顺次执行至最后一行无报错。 -
成熟逻辑及时下沉为标准模块:当某段数据清洗、特征提取或模型评估代码在多个 Notebook 中反复出现时,应将其封装进标准的
.py工具类库中,在 Notebook 中通过import my_tools调用,保持 Notebook 核心层聚焦于业务分析。 -
版本控制治理:
.ipynb文件的本质是一个包含了输入代码、执行计数、富媒体 Base64 编码的庞大 JSON 对象。Git 对其产生的 diff 往往极难阅读。可以配置nbdime进行直观的 Notebook 对比,或使用jupytext将 Notebook 同步为 Markdown / 纯 Python 格式进行协同。
六、总结:数据分析工作流的阶段选型指南
综合来看,Jupyter Notebook 能够长期统治数据科学与 Python 数据分析领域,本质上是因为它精准匹配了人类进行实验探索的心智模型:**先尝试、再观察、后调整**。它不是要取代传统 IDE,而是与传统工程 IDE 在不同阶段各司其职。
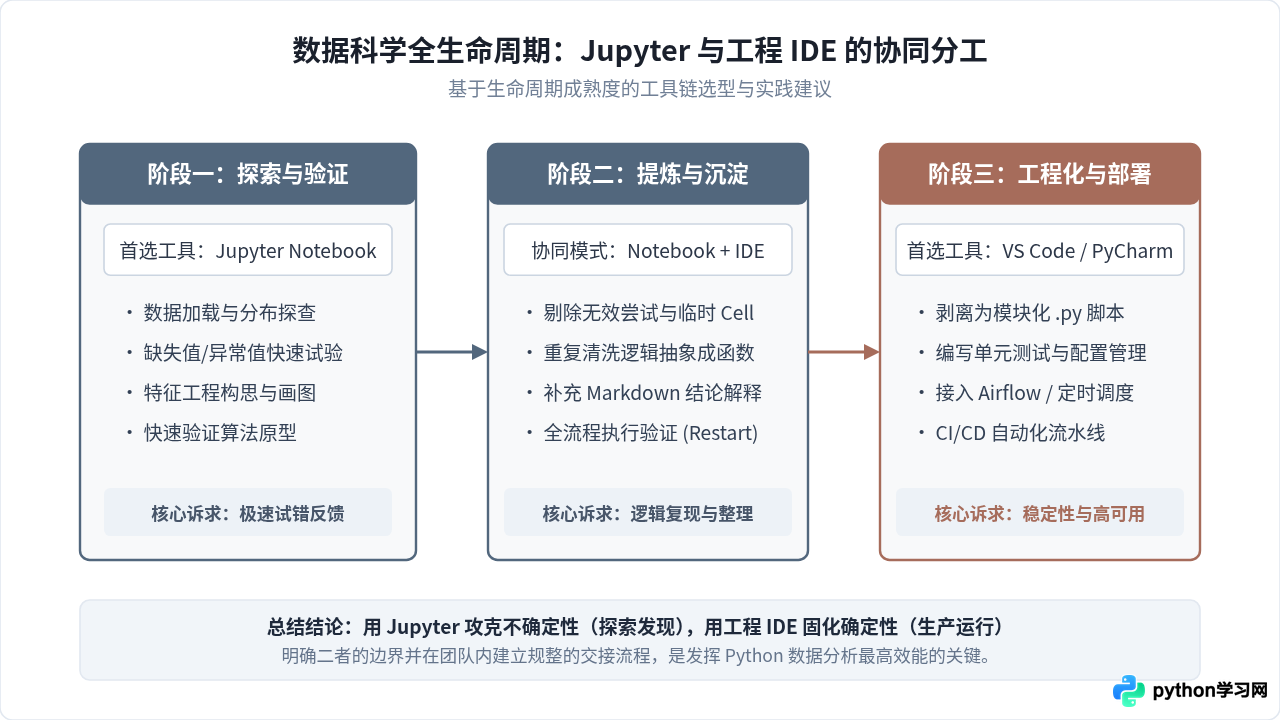
掌握 Jupyter Notebook 的真正意义,不在于记住它的快捷键,而在于学会善用它的“状态常驻”与“富媒体内联”特性,把数据探索的反馈周期缩短到极致。在面对海量特征工程、参数调优和图表呈现时,Jupyter Notebook 依然是目前 Python 数据分析领域最顺手、最高效的首选工具。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









