

怎么用Python将字典列表转换为CSV文件
详细讲解在Python中如何使用内置csv模块的DictWriter以及第三方pandas库将字典列表高效导出并转换为CSV文件,包含字段提取、中文乱码处理与缺失键容错指南。
在日常数据处理与爬虫抓取中,Python程序从接口或数据库提取到的数据往往是字典列表(List of Dictionaries)的形式。将这种结构化数据保存为CSV纯文本表格,是进行数据交付、归档以及导入Excel分析的标准动作。本文将直接介绍如何使用Python内置的标准库模块 csv.DictWriter 完成转换,并说明面对字段缺失、中文乱码及大量数据处理时的常见实践方案。
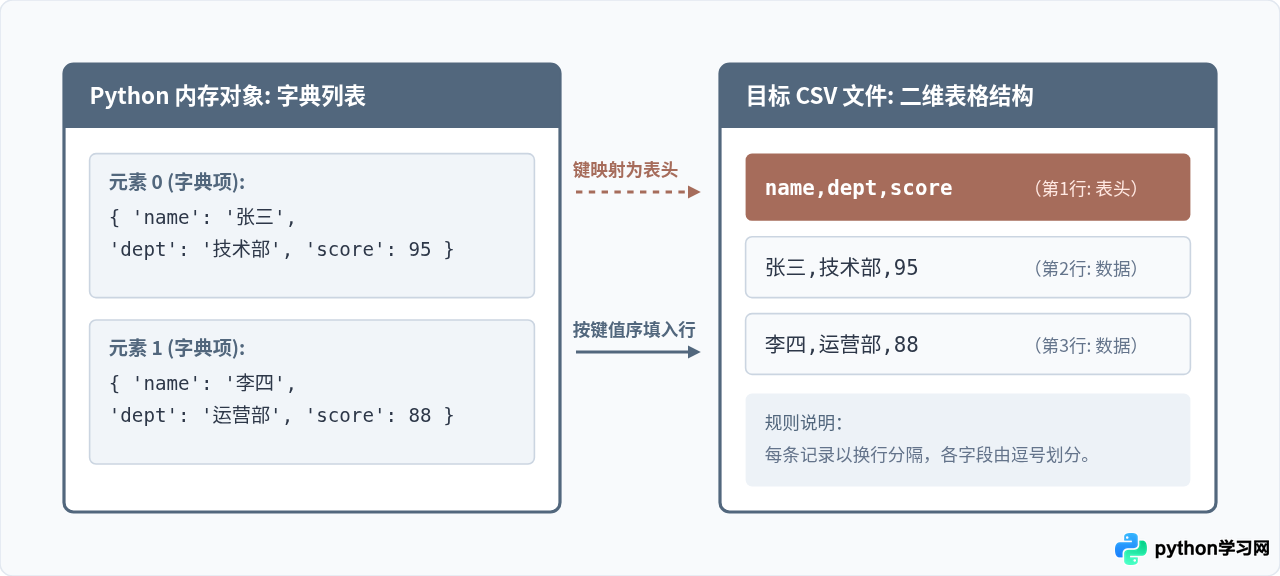
一、字典列表与CSV的映射原理
字典列表本质上是由多个键值对对象构成的序列。要将此类数据转换为由行和列构成的二维表格,关键在于建立两层映射关系:第一层是将所有字典共有的键(Keys)提取为CSV的第一行表头(Header);第二层是遍历列表中的每个字典,将对应键的值(Values)按照表头顺序逐行写入为数据行。
二、使用内置 csv.DictWriter 的标准操作步骤
Python 标准库自带 csv 模块,无需额外安装第三方依赖。其中专为字典结构设计的 csv.DictWriter 类能自动把字典的值对齐到对应字段名下,使用流程分为规范的四个步骤。
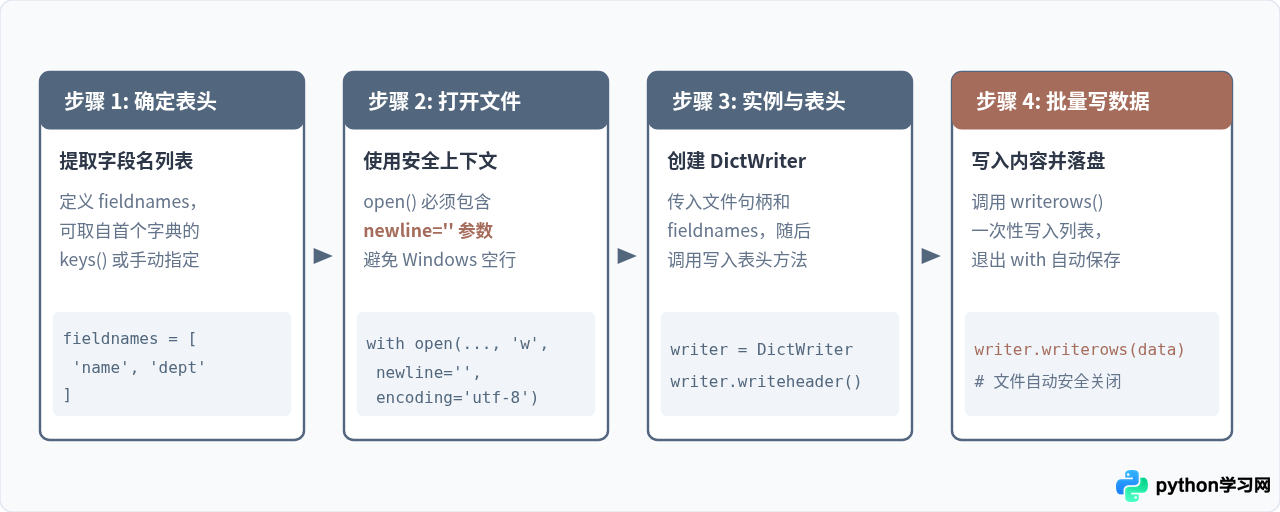
下面是一个可直接执行的完整代码示例:
import csv

# 准备字典列表数据
students = [
    {"name": "张三", "age": 20, "city": "北京"},
    {"name": "李四", "age": 22, "city": "上海"},
    {"name": "王五", "age": 21, "city": "广州"}
]

# 1. 指定输出文件路径与表头字段顺序
csv_file_path = "students.csv"
field_headers = ["name", "age", "city"]

# 2. 打开文件并写入数据
with open(csv_file_path, mode="w", newline="", encoding="utf-8-sig") as f:
    writer = csv.DictWriter(f, fieldnames=field_headers)

    # 写入第一行表头
    writer.writeheader()

    # 一次性写入全部字典记录
    writer.writerows(students)

print("CSV文件生成完成!")
运行该脚本后,当前目录下会生成 students.csv 文件,其文本内容如下:
name,age,city
张三,20,北京
李四,22,上海
王五,21,广州
三、容易忽视的关键细节与避坑提醒
在实际编码中,很多初学者虽然掌握了基本语法,但在不同操作系统或复杂数据源下仍会遭遇异常。以下两个细节必须在编写时加以预防:
1. 为什么 open 函数必须加入 newline=""
在 Windows 环境下,如果不添加 newline="",open() 默认会在写入字符串换行符 \n 时将其转换为系统的回车换行符 \r\n;而 csv 模块内部本身也会按 CSV 规范输出 \r\n。这会导致每一行数据之间多出一个空行。显式传入 newline="" 即可指示 Python 不对换行符做额外翻译,由 csv 模块全权控制输出格式。
2. 防止 Windows Excel 打开出现中文乱码
如果直接使用 encoding="utf-8" 编码保存,在部分旧版 Windows 系统的 Microsoft Excel 中双击打开 CSV 时,中文很容易显示为“???”或生僻乱码。这是因为 Excel 默认按照系统区域编码(如 GBK)解析无标记的文本。解决办法是将编码指定为 encoding="utf-8-sig"。该编码会在文件开头加入 UTF-8 BOM 签名,明确通知 Excel 使用 UTF-8 规则解码。
四、非规范字典列表的容错处理
从外部网络爬虫或动态 API 获取的字典列表中,各字典项的键名常常不是完全齐整的。某些元素可能缺少键,或者临时多出非必要字段。如果直接交由 DictWriter 处理,可能会出现未定义行为或触发 ValueError。
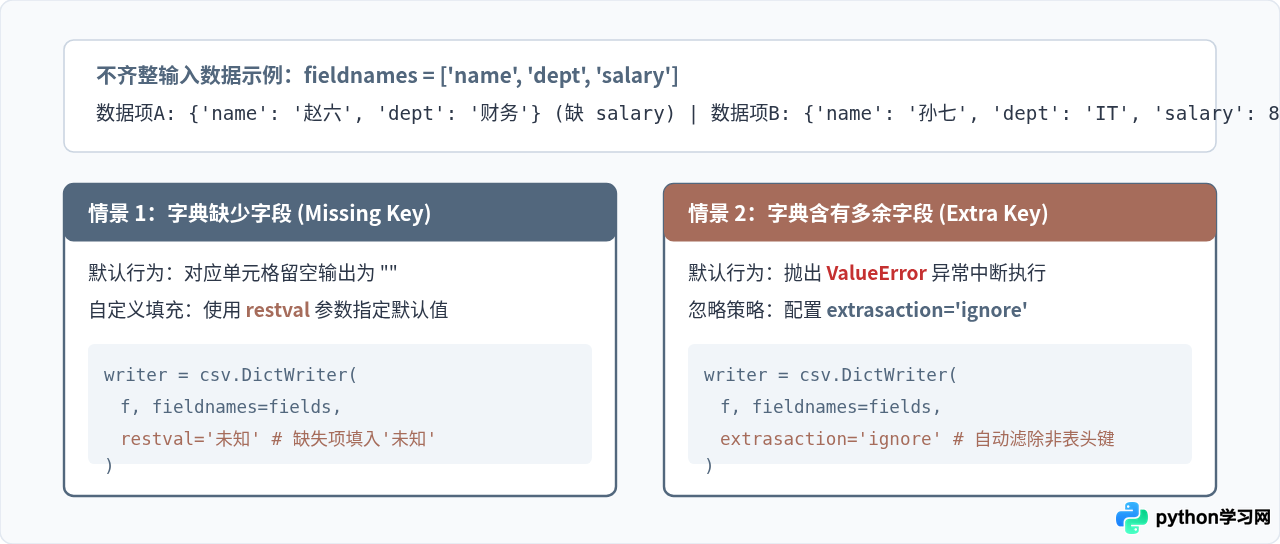
当字典键不齐整时,建议在初始化 DictWriter 时同时指明 restval 和 extrasaction:
import csv

raw_data = [
    {"name": "赵六", "dept": "财务"},  # 缺失 salary 键
    {"name": "孙七", "dept": "IT", "salary": 8000, "hobby": "篮球"}  # 含有多余键 hobby
]

headers = ["name", "dept", "salary"]

with open("robust_output.csv", "w", newline="", encoding="utf-8-sig") as f:
    writer = csv.DictWriter(
        f,
        fieldnames=headers,
        restval="N/A",           # 缺失的键使用 "N/A" 填充
        extrasaction="ignore"    # 字典中不在 headers 的键自动被丢弃
    )
    writer.writeheader()
    writer.writerows(raw_data)
动态提取完整表头技巧:如果无法预先得知可能存在哪些键,可以通过集合运算或有序字典遍历所有元素收集全量键集合:
all_keys = list(dict.fromkeys(k for item in raw_data for k in item.keys()))
这样提取出的 all_keys 既保证了字段完整性,又保留了键出现的先后相对顺序。
五、数据科学场景下的替代方案:Pandas
如果项目中已经引入了数据分析库 pandas,将字典列表转换为 CSV 只需两行代码,并且 Pandas 能够自动对齐所有字典的键(缺失项自动设为 NaN):
import pandas as pd

data = [
    {"name": "周八", "score": 90, "city": "深圳"},
    {"name": "吴九", "city": "杭州", "level": "VIP"}
]

# 直接由字典列表构造 DataFrame,并输出到 CSV
df = pd.DataFrame(data)
df.to_csv("pandas_output.csv", index=False, encoding="utf-8-sig")
六、方案选型与技术总结
在工程落地时,应根据项目的依赖要求和数据规模选择最合适的转换工具:
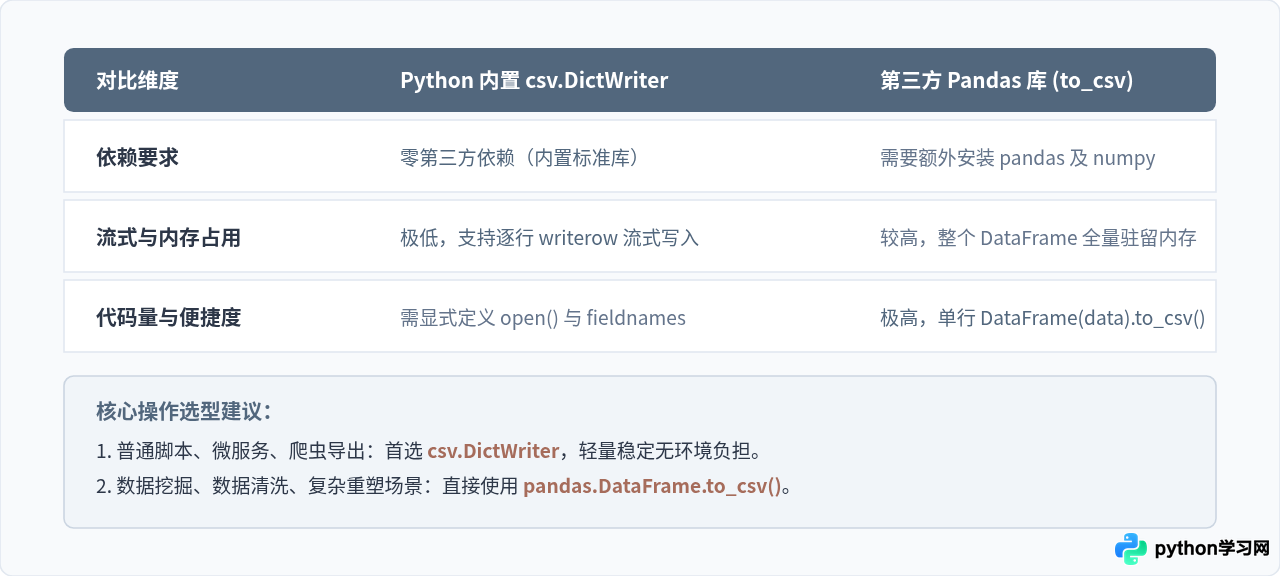
综上所述,将 Python 字典列表导出为 CSV 文件是一项基础而关键的数据操作。只要在文件打开阶段固定 newline="" 与 encoding="utf-8-sig" 两个参数,并通过 DictWriter 的 fieldnames 明确字段序列,即可写出稳定、规范且兼容各类办公软件的标准表格文件。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









