

Python中使用re.search进行复杂模式的字符串包含匹配
深入讲解如何在Python中使用re.search进行复杂正则模式的字符串包含匹配,分析re.search与in运算符、re.match的区别及实际开发规范。
在Python中判断一个字符串是否包含某个子串,最简便的方法是使用 in 关键字。然而,当匹配需求不仅是固定字符,而是需要校验动态数字、特定前缀组合、可选符号或模糊规则时,简单的字面比较就无能为力了。此时,标准库提供的 re.search 函数是处理“复杂模式包含匹配”的首要工具。本文将详细讲解 re.search 的核心逻辑、代码实现方式、与相近方法的差异以及实战优化策略。
一、re.search 的基本机制与执行流程
re.search(pattern, string, flags=0) 的核心功能是在目标字符串的任意位置扫描并寻找与正则表达式模式匹配的第一个子串。若匹配成功,它会返回一个 re.Match 对象;若全串都不存在符合规则的片段,则返回 None。
使用 re.search 进行包含匹配的基本流程可以归纳为四步:确定匹配规则、调用函数搜索、通过真值测试判定是否存在、在需要时从匹配对象中提取具体内容。
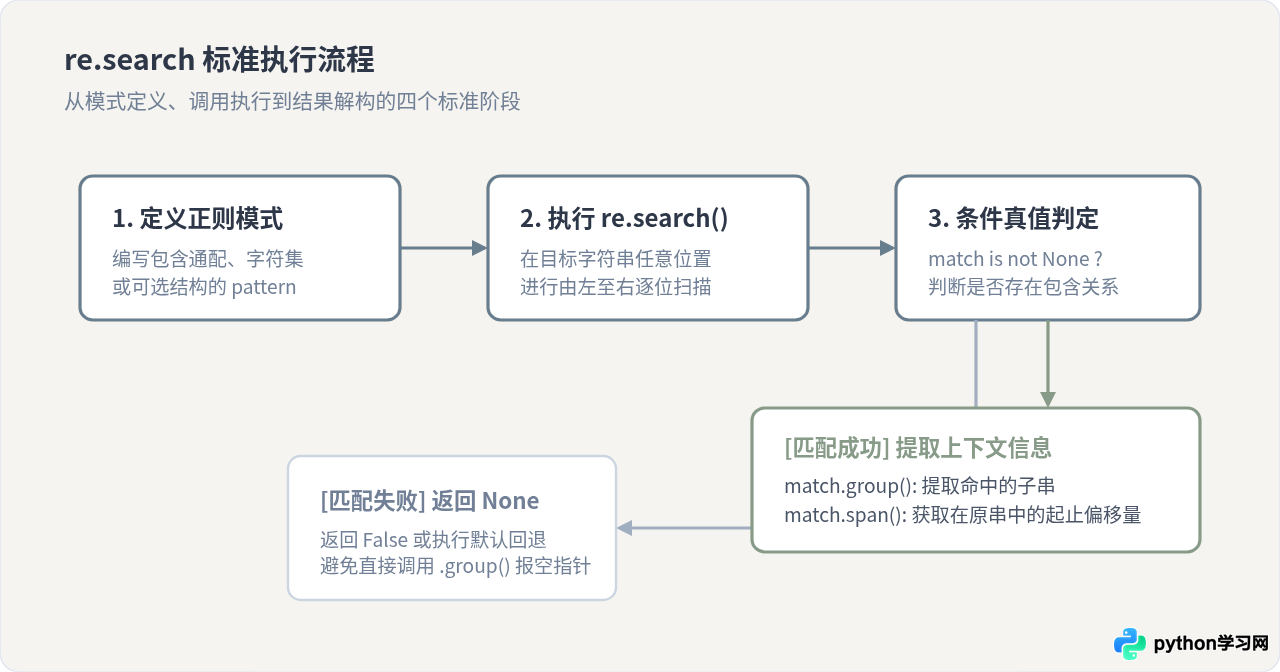
下面是一个标准的判断包含关系的基础代码示例:
import re

text = "系统提示:任务 TASK_8921 已在 2026-10-17 处理完毕。"
# 匹配包含形如 TASK_后接数字的结构
pattern = r"TASK_\d+"

match = re.search(pattern, text)
if match:
    print(f"包含目标模式,匹配到的具体内容为: {match.group()}")
    print(f"子串在原文本中的位置范围: {match.span()}")
else:
    print("未包含符合模式的内容")
示例输出:
包含目标模式,匹配到的具体内容为: TASK_8921
子串在原文本中的位置范围: (9, 18)
二、核心机制解析:滑动窗口与任意位置扫描
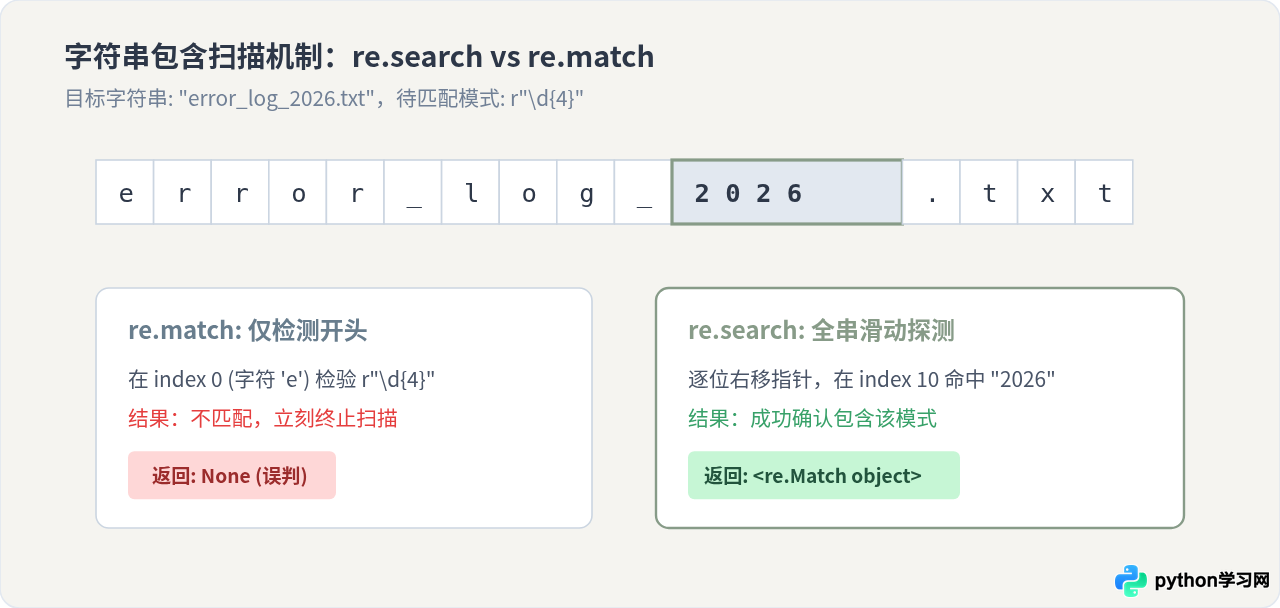
许多初学者容易混淆 re.search 与 re.match。它们的关键差异在于对起始位置的假设:
- re.match:始终强制从字符串索引 0 开始检验。如果索引 0 处的字符不符合模式,立刻宣告匹配失败并返回
None,类似于在正则表达式最前端隐式增加了^锚点。 - re.search:则是真正的“包含匹配”。它将整个字符串视作连续空间,若位置 0 处不匹配,引擎会自动向右移动指针,在后续位置继续尝试,直到找到第一个匹配点或遍历结束。
三、复杂模式下的实战匹配技巧
日常业务中面对的复杂包含匹配,往往涉及前瞻断言、命名捕获组以及跨行匹配。掌握这些模式写法能极大提升代码的稳健度。
1. 命名捕获组与多重分支
当包含匹配的模式较长时,使用 (?P<name>...) 能够直接在匹配对象中按键名读取内容,提升代码可读性:
import re

log_entry = "2026-10-17 14:32:05 [WARN] 节点 node-08 内存占用超过阈值 85%"
# 包含形如 [WARN] 或 [ERROR] 且后续包含具体节点编号和百分比数值
pattern = r"\[(?P<level>WARN|ERROR)\]\s+节点\s+(?P<node>[\w-]+).*?(?P<percent>\d+)%"

match = re.search(pattern, log_entry)
if match:
    data = match.groupdict()
    print(f"日志级别: {data['level']}")
    print(f"告警节点: {data['node']}")
    print(f"超标数值: {data['percent']}%")
示例输出:
日志级别: WARN
告警节点: node-08
超标数值: 85%
2. 利用零宽断言进行“无污染”包含匹配
有时候我们需要判断字符串中是否包含满足某种上下文条件的数值,但又不想将上下文本身归入匹配子串。此时可以使用正向先行断言 (?=...) 或后行断言 (?<=...):
import re

text = "订单总额为 USD: 450.00,折扣后实付 USD: 380.00"
# 仅包含匹配货币为 USD 后的金额数值
pattern = r"(?<=USD:\s)\d+\.\d{2}"

match = re.search(pattern, text)
if match:
    print(f"首个匹配到的金额是: {match.group()}")
示例输出:
首个匹配到的金额是: 450.00四、匹配方式对照与技术选型
在 Python 中做包含或格式校验,开发者经常在 in、re.search、re.match 和 re.fullmatch 之间选择。各方式的功能定位有明确边界:
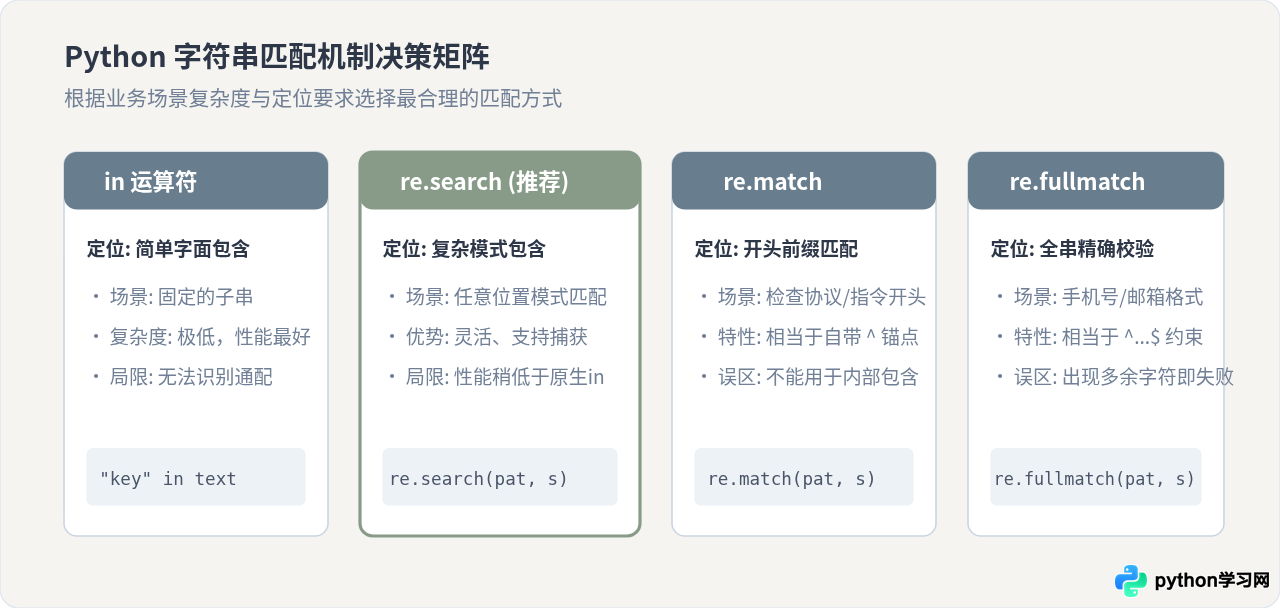
| 方法/方式 | 扫描范围 | 模式能力 | 返回值类型 | 典型适用场景 |
|---|---|---|---|---|
sub in str |
全串任意位置 | 仅支持固定纯文本 | bool | 简单关键词命中、白名单判断 |
re.search |
全串任意位置 | 支持完整正则表达式 | Match 或 None | 日志复杂提取、非固定格式的包含判定 |
re.match |
仅限字符串索引 0 | 支持完整正则表达式 | Match 或 None | 协议头判定、固定命令行前缀解析 |
re.fullmatch |
全串(首尾完全覆盖) | 支持完整正则表达式 | Match 或 None | 表单字段验证(如身份证、邮箱规范性) |
五、工程实践中的注意事项与性能调优
在生产环境中使用 re.search 处理大量长文本或高并发请求时,应注意以下要点:
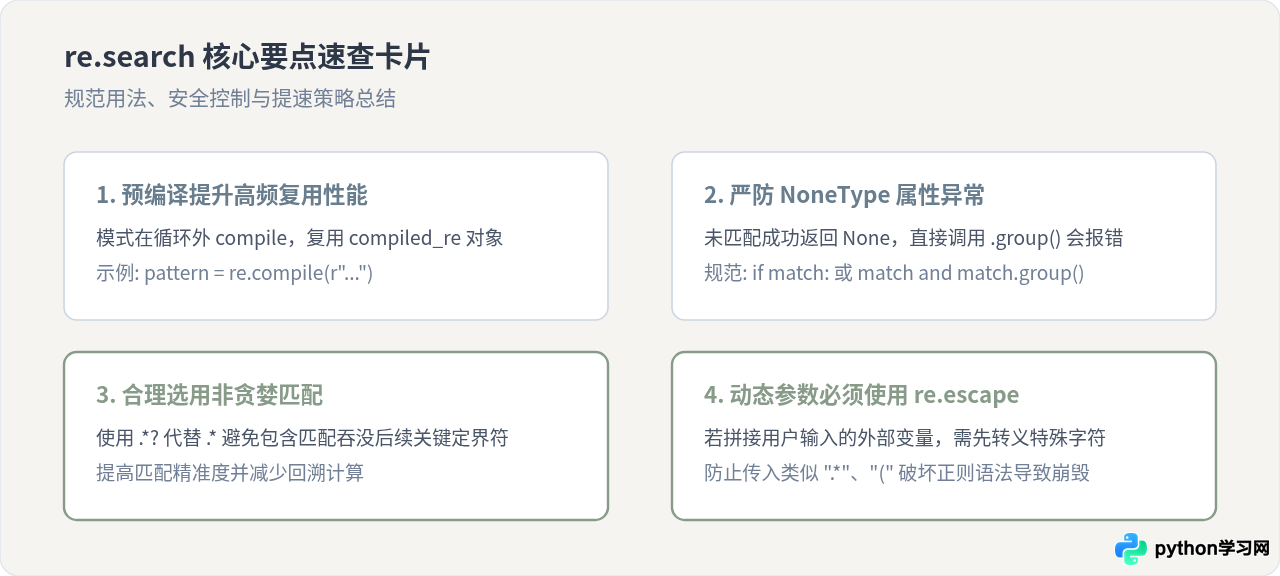
1. 大量调用时优先使用 re.compile 预编译:每次调用 re.search("...", text),Python 内部虽然对近期使用的模式做了轻量 LRU 缓存,但在高频循环内,显式通过 compiled = re.compile(pattern) 预编译后调用 compiled.search(text) 能够减少解析开销并让代码职责更清晰。
2. 区分大小写与换行标志位:如果需要忽略大小写,应显式传入 flags=re.IGNORECASE;如果匹配跨越多行文本且希望通配符 . 包含换行符,应启用 flags=re.DOTALL。可以通过管道符同时启用多个标志:flags=re.IGNORECASE | re.DOTALL。
3. 防范灾难性回溯 (ReDoS):避免编写形如 (a+)+$ 或多层嵌套量词的正则表达式。在未锚定的包含搜索中,长字符串配合贪婪嵌套量词可能导致正则引擎进入指数级回溯,耗尽 CPU 资源。
六、总结
re.search 是 Python 正则表达式模块中用于“字符串包含判定”的核心手段。与仅检测前缀的 re.match 以及全串精确校验的 re.fullmatch 相比,re.search 提供了真正的滑动窗口扫描能力。在面对包含通配规则、特定上下文前瞻条件以及复杂多变字段时,只要遵循预编译、防御空值与非贪婪原则,即可写出高效且健壮的包含匹配代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









