

Python数据分析必备:NumPy、Pandas与Matplotlib核心功能解析
深入解析Python数据分析核心库NumPy、Pandas与Matplotlib的功能定位、底层机制、协作流程与实战用法,涵盖高效矩阵计算、表格清洗与专业图表绘制。
在Python数据科学技术栈中,NumPy、Pandas与Matplotlib构成了最基础且无可替代的核心三角。本文将抛弃泛泛的概念罗列,直接从工程与分析视角切入,解析三个库的职责划分、底层运作逻辑、核心高频操作及协同工作流,帮助读者建立系统、清晰且可直接落地的数据分析技能框架。
一、核心协作模式:三大库在数据分析全流程中的分工
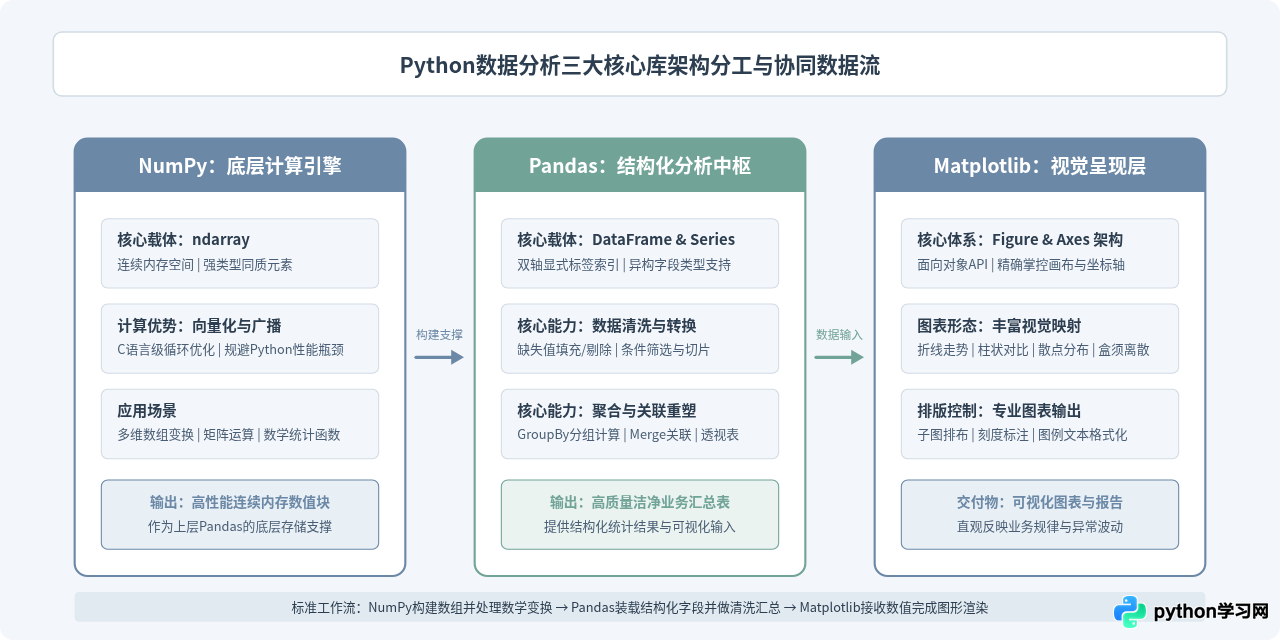
数据分析不是单一工具的独立运作,而是一个包含“原始数据载入”、“矩阵与数学计算”、“结构化整理与聚合统计”、“视觉结论呈现”的完整链路。在这套流水线中,三个库并非竞争关系,而是按层分工的共生体系:
- NumPy(底层计算引擎):提供高性能的多维同质数组(ndarray)与底层C/Fortran实现的线性代数与数值计算能力,作为整个生态的底层数据容器与数学加速基石。
- Pandas(业务数据处理中枢):在NumPy数组之上封装了带有索引和列名的异构数据表结构(Series与DataFrame),负责数据清洗、缺失值处理、时间序列解析、表关联与分组聚合等核心业务统计。
- Matplotlib(结果可视化层):依托NumPy与Pandas生成的洁净数据结构,提供灵活强大的画布、坐标轴与几何元素渲染接口,将统计分析结论转化成直观的数据图表。
二、NumPy核心解析:高性能ndarray与向量化计算
许多初学者会产生疑问:Python自带原生的list列表,且能够存放各种类型的对象,为什么在数据分析中必须使用NumPy的ndarray(N-dimensional Array)?
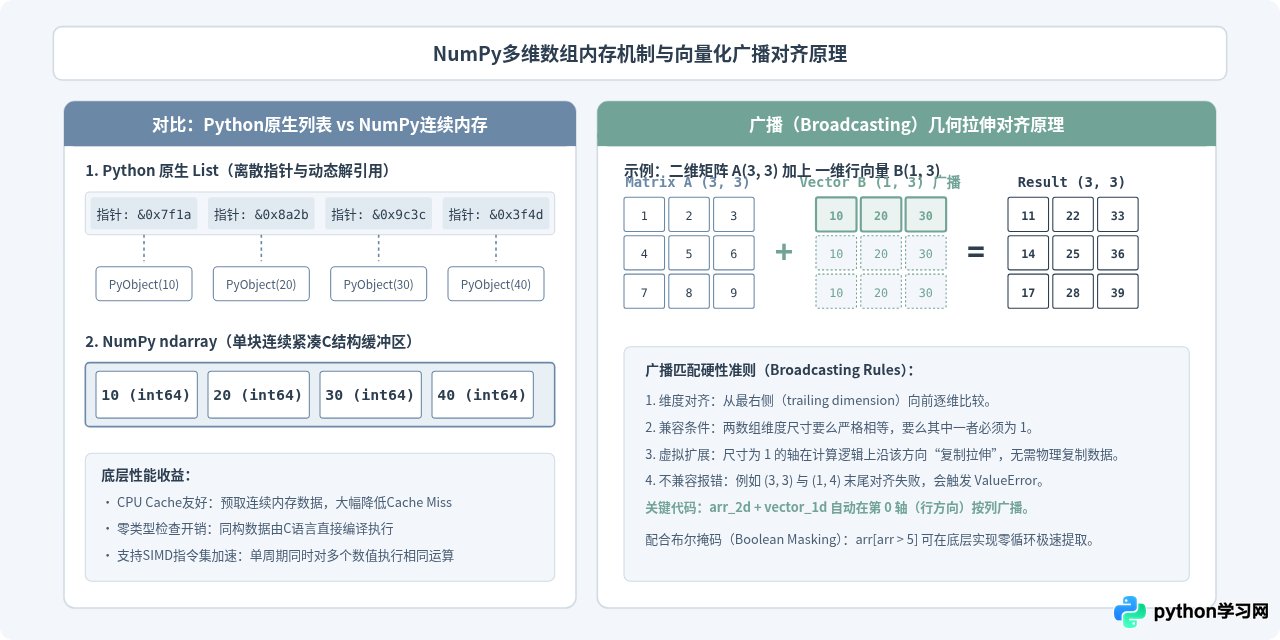
核心原因在于内存结构与执行模型的根本差异。Python的原生列表本质上是一个指针数组,列表中存储的是每个对象的内存引用地址,数据分散在内存的各个角落,每次读取都需要经过指针间接寻址,无法有效利用现代CPU的L1/L2高速缓存机制;同时由于元素类型不固定,每次循环运算都要进行动态类型检查。
NumPy的ndarray则不同:它在内存中分配一块严格连续的内存空间(C-contiguous buffer),且所有元素必须是统一的数据类型(如float64或int32)。这使得底层C语言引擎可以直接按固定步长(strides)跳跃寻址,并借助SIMD单指令多数据流进行硬件级并行加速。
1. 数组创建与核心属性
在NumPy中,每个数组都拥有明确的几何形状(shape)、维度数量(ndim)和数据类型(dtype):
import numpy as np

# 1. 常用创建方式
arr_1d = np.array([10, 20, 30, 40], dtype=np.float64)
arr_zeros = np.zeros(shape=(3, 4), dtype=np.int32)     # 3行4列全0矩阵
arr_range = np.arange(0, 10, 2)                         # array([0, 2, 4, 6, 8])
arr_linspace = np.linspace(0, 1, 5)                     # 0到1之间生成5个均匀点

# 2. 核心元信息查看
print("形状:", arr_zeros.shape)  # 输出: (3, 4)
print("维度:", arr_zeros.ndim)   # 输出: 2
print("类型:", arr_zeros.dtype)  # 输出: int32
2. 向量化运算与广播机制(Broadcasting)
在数据分析中,严禁在大型数据集上使用Python原生的for循环做逐项算术计算,应当全面采用向量化操作。当两个形状不完全一致的数组进行数学运算时,NumPy会自动启用广播机制:
- 从后向前逐个比对两个数组的各维度大小(从末尾维度开始向左对齐)。
- 两个维度能匹配的充要条件是:两者的维度尺寸相等,或者其中一个维度的尺寸为1。
- 维度尺寸为1的轴会在计算时自动进行虚坐标沿轴延伸,不需要实际拷贝内存,从而大幅节省内存并以C速度完成对齐运算。
三、Pandas核心解析:Series、DataFrame与数据清洗变换
虽然NumPy在数值矩阵计算上性能极高,但在真实的业务场景中,数据通常不是纯粹的同质数字,而是包含员工姓名(字符串)、入职日期(时间戳)、交易金额(浮点数)和是否离职(布尔值)的异构二维表格。此时,Pandas登场并承担核心处理工作。
1. 两个基础数据结构:Series 与 DataFrame
- Series(一维带标签数组):由一组数据以及一组与之对应的行标签(Index)组成。支持位置下标与标签双重检索。
- DataFrame(二维异构数据表):由多个拥有相同Index的Series按列横向拼接而成的表格型数据结构,既有行索引(Index),又有列标签(Columns)。每列可以拥有各自不同的数据类型(int、float、object、datetime64等)。
2. 数据清洗与检索的规范实践
在日常数据分析中,以下四个环节是Pandas使用频率最高的操作:
- 索引检索:严禁直接链式索引。必须显式使用
.loc[行标签, 列标签]或.iloc[行整数位置, 列整数位置]。直接使用类似df['col'][0] = val的链式写法会触发臭名昭著的SettingWithCopyWarning,导致赋值失败或副作用不可控。 - 缺失值清洗(Handling Missing Data):使用
df.isna().sum()诊断各列缺失情况;对数值列常用中位数或均值填充df['price'].fillna(df['price'].median(), inplace=True),或对关键缺失记录使用df.dropna(subset=['order_id'])剔除。 - 条件布尔筛选:利用按位运算符
&(与)、|(或)、~(非)构建复合条件。例如:df[(df['age'] > 25) & (df['city'] == 'Beijing')],每个子条件必须用小括号包裹。 - 分组聚合(GroupBy-Agg 模式):将数据按指定维度拆分(Split)、对各组应用聚合函数(Apply)、最后合并统计结果(Combine)。
import pandas as pd
import numpy as np

# 构造模拟电商订单数据
data = {
    'order_id': [1001, 1002, 1003, 1004, 1005, 1006],
    'category': ['电子', '家居', '电子', '日用', '家居', '电子'],
    'price': [3200.0, np.nan, 5800.0, 45.0, 890.0, 1200.0],
    'quantity': [1, 2, 3, 10, 4, 2]
}
df = pd.DataFrame(data)

# 1. 缺失值诊断与安全填充
median_val = df['price'].median()
df['price'] = df['price'].fillna(median_val)

# 2. 特征衍生:计算销售总额
df['total_amount'] = df['price'] * df['quantity']

# 3. 分组聚合统计各品类销售指标
category_stats = df.groupby('category').agg(
    total_sales=('total_amount', 'sum'),
    avg_price=('price', 'mean'),
    order_count=('order_id', 'count')
).reset_index()

print("品类聚合统计结果(示例):")
print(category_stats)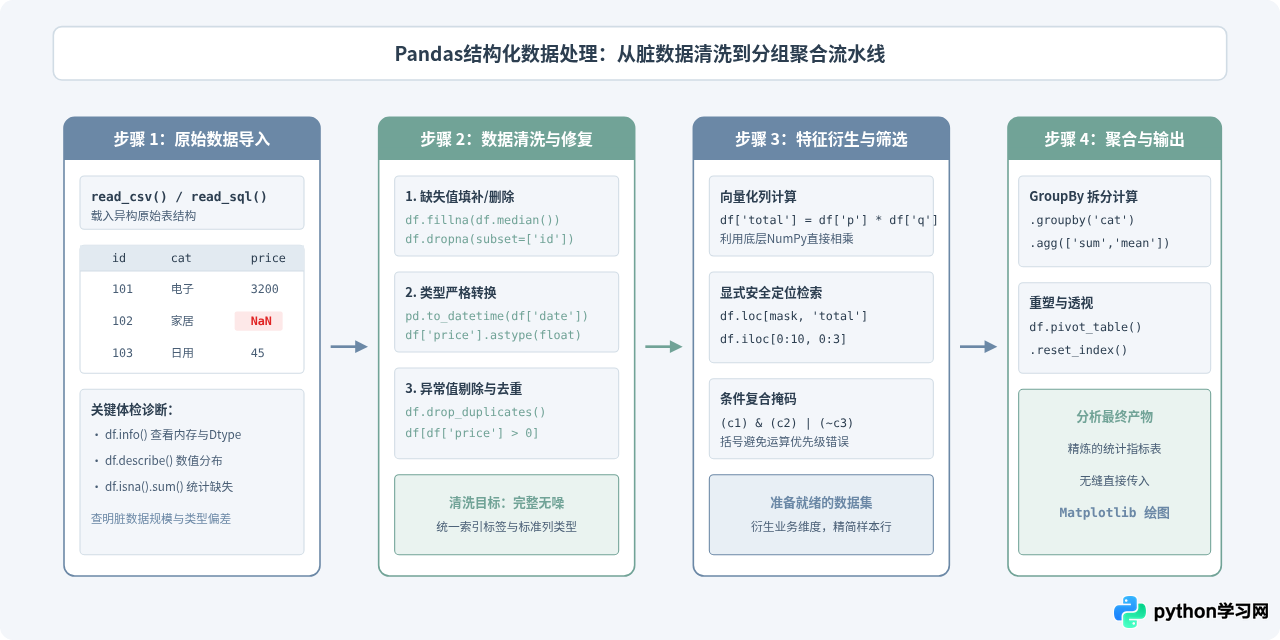
四、Matplotlib核心解析:面向对象绘图架构与视觉表达
处理完数据后,需要将统计指标转化为易于传播的可视化结论。Matplotlib是Python中最经典的绘图底层库,几乎所有高阶可视化工具(如Seaborn、Pandas内置plot)均基于Matplotlib构建。
1. 为什么坚决使用“面向对象接口”而非“pyplot快捷命令”?
Matplotlib存在两套设计风格:
- pyplot状态机风格(MATLAB风格):通过
plt.plot()、plt.title()等全局命令绘图。该模式在简单绘制单张图时虽然简短,但全局状态隐式共享,在处理多子图排版、微调坐标轴属性时极易造成状态错乱。 - 面向对象风格(Object-Oriented API,强烈推荐):显式创建
Figure(画布)和Axes(坐标子图)对象。通过调用特定ax实例的方法进行绘制(如ax.plot()、ax.set_title())。在工程代码与复杂报表中,面向对象风格结构清晰、作用域严谨,维护成本远低于状态机。
2. Figure 与 Axes 的层级关系
理解Matplotlib的核心在于理顺容器的层级树:
- Figure(顶层画布):整个可视化的物理边界,管理所有的子图、总标题(suptitle)以及导出时的DPI与背景色。
- Axes(坐标轴区域):真正的“一张图表”,包含我们所见到的具体绘图区域。一个Figure上可以挂载一个或多个Axes(通过网格布局排布)。
- Axis(坐标轴)与图元(Artists):每个Axes内部管理着X轴、Y轴对象,负责刻度(Ticks)、网格线(Grids)、轴标签(Labels)、折线(Line2D)、柱体(Rectangle)以及图例(Legend)。
import matplotlib.pyplot as plt

# 解决中文显示方块乱码与负号显示问题
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False

# 1. 显式创建Figure画布与Axes子图(1行2列布局)
fig, (ax1, ax2) = plt.subplots(nrows=1, ncols=2, figsize=(12, 5))

# 2. 在第一个子图上绘制柱状对比图
categories = ['电子', '家居', '日用']
sales = [10200, 3560, 450]
colors = ['#6B88A6', '#71A397', '#94A3B8']

bars = ax1.bar(categories, sales, color=colors, width=0.5)
ax1.set_title('各品类销售总额对比', fontsize=14, pad=12)
ax1.set_xlabel('商品分类', fontsize=12)
ax1.set_ylabel('销售额(元)', fontsize=12)
ax1.grid(axis='y', linestyle='--', alpha=0.6)

# 3. 在第二个子图上绘制折线走势图
months = [f'{i}月' for i in range(1, 7)]
trend = [120, 150, 190, 230, 280, 360]
ax2.plot(months, trend, marker='o', linewidth=2.2, color='#6B88A6', label='月访问量')
ax2.set_title('上半年业务增长趋势', fontsize=14, pad=12)
ax2.set_xlabel('月份', fontsize=12)
ax2.set_ylabel('访问次数(k)', fontsize=12)
ax2.legend(loc='upper left')
ax2.grid(True, linestyle='--', alpha=0.6)

# 4. 紧凑排布与展示/保存
plt.tight_layout()
# plt.savefig('sales_report.png', dpi=300)
plt.close(fig) # 释放内存资源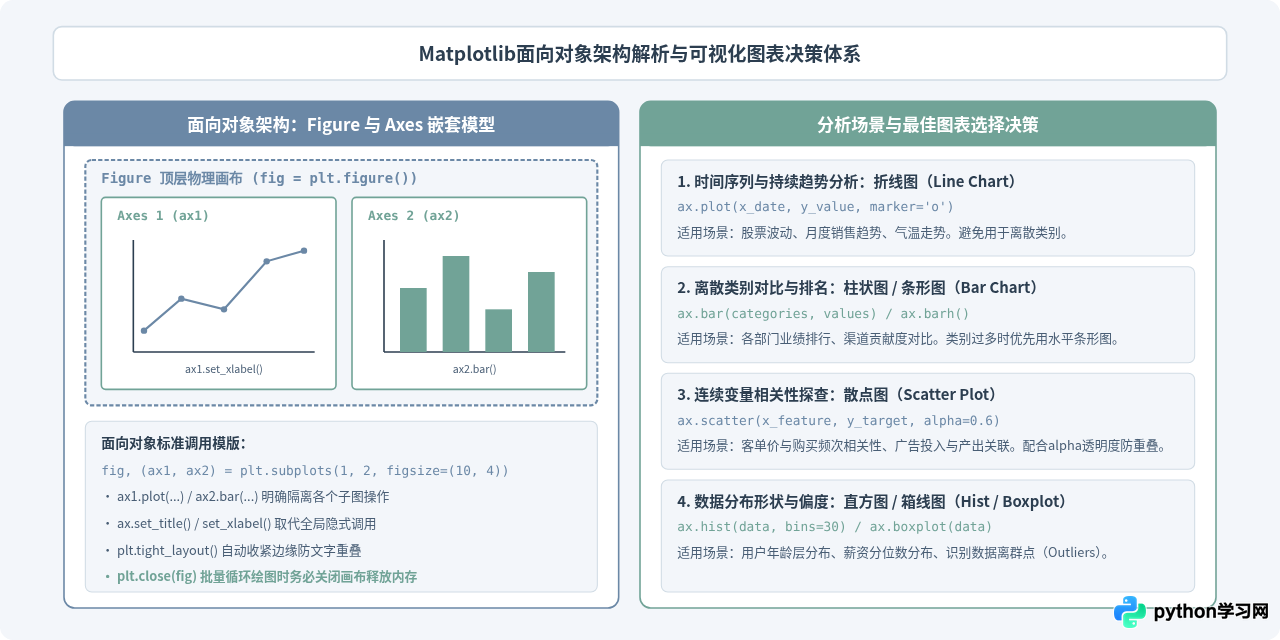
五、综合协同实践与核心避坑指南
在综合使用三者进行全流程数据分析时,存在一些由于机制混淆而引发的常见误区,需重点排查:
| 常见问题 / 报错 | 产生根源 | 标准解决方法 |
|---|---|---|
SettingWithCopyWarning |
在Pandas切片视图上进行间接赋值,导致无法确定改动是否影响原对象 | 使用显式 .loc[row_indexer, col_indexer] = value 赋值,或者如果需要独立副本显式调用 .copy()。 |
中文显示为白方块 □ |
Matplotlib默认字体未指定中文字体族,无法找到对应字形 | 在代码头部配置 plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'sans-serif']。 |
| 批量循环绘图内存泄漏 | 在循环体内不断调用 plt.figure() 但未显式关闭,画布一直驻留在内存 |
在每次保存图片后调用 plt.close(fig) 显式回收释放底层资源。 |
| 数组原地修改污染源数据 | NumPy切片操作默认生成的是原数组的视图(View)而非副本(Copy) | 若需要完全隔离的独立数据进行破坏性修改,切片后立即调用 arr[0:5].copy()。 |
逻辑条件筛选报 ValueError |
在Pandas或NumPy中混用了Python自带的 and / or 关键字 |
必须使用按位运算符 & / |,且每个判断条件用括号 (condition) 独立隔离。 |
学习Python数据分析的关键不是死记每个函数的每个参数,而是清晰建立三者的心智模型:遇到高维纯数值运算与矩阵变换,找NumPy;遇到包含业务字段、缺失值、时间维度的结构化表格处理,找Pandas;最终需要对指标进行解释、提炼与汇报展示,交给Matplotlib。理顺这套流水线,即可高效承接各类复杂的数据分析与工程建模任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









