

Python常用库分类汇总:Web开发、数据分析与自动化必备清单
针对Web开发、数据分析与自动化三大核心方向,系统梳理Python主流第三方库的定位、关键选型差异、核心代码用法与实战避坑建议。
在 Python 的实际项目开发中,选择合适的第三方库往往直接决定了研发效率与系统的可维护性。面对海量生态组件,开发者常常面临“在同类工具中该选哪一个”的困惑。本文围绕 Web 开发、数据分析与日常自动化三大核心应用领域,提炼出生产环境中最常用、最具代表性的工具清单,并通过功能定位、核心差异对比以及最小可用示例,帮助读者建立清晰的选型标准与技术落地路径。
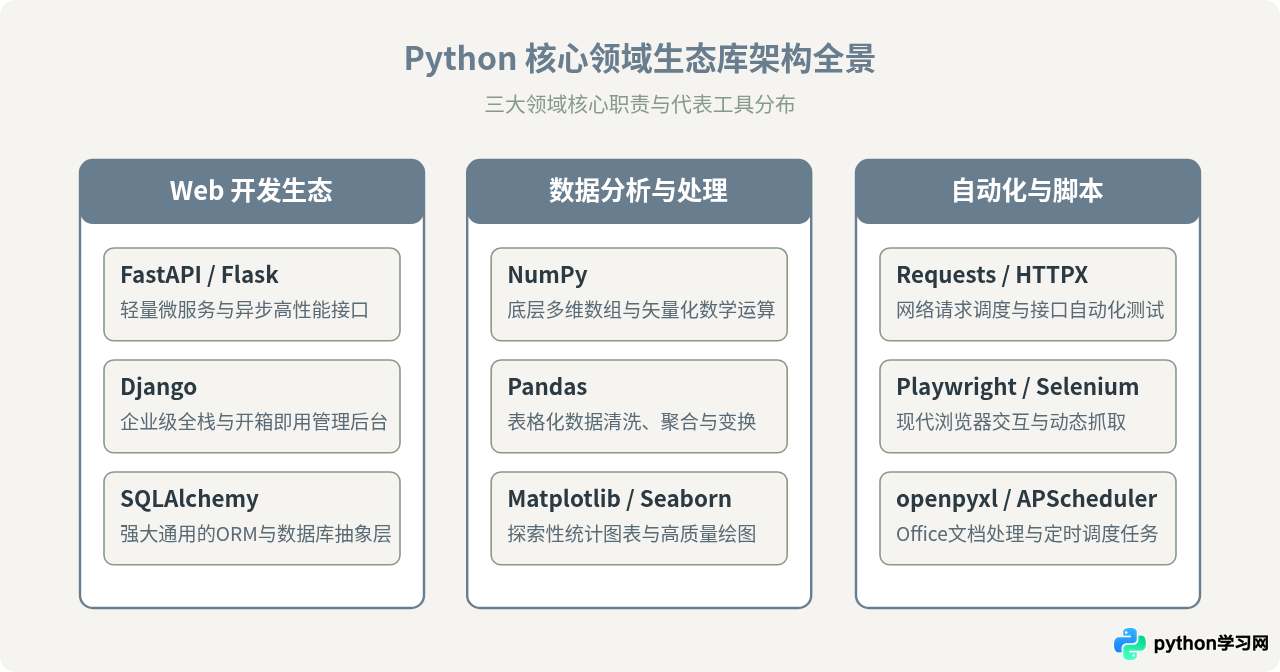
一、Web 开发核心库与技术选型
Web 服务开发通常分为全栈框架、微服务框架与底层数据访问层。在实际工程中,团队技术栈的选择主要由业务规模、交付周期和性能要求决定。
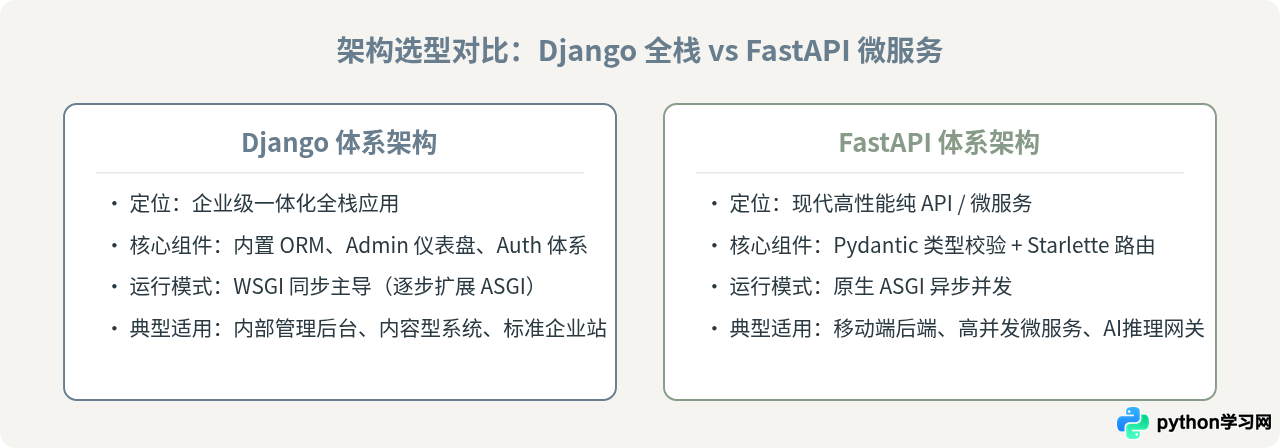
1. 关键差异对比:Django 全栈与 FastAPI 微服务
在面对新项目时,最常见的抉择是在全功能框架(如 Django)与轻量化异步框架(如 FastAPI)之间进行权衡。它们的关键差异不在于语法喜好,而在于技术约束与治理成本:
- 开箱即用能力:Django 遵循“内置电池”(Batteries-Included)理念,自带 ORM、认证系统、表单验证及管理后台。如果项目需要复杂的用户权限体系或快速交付管理系统,Django 能大幅减少重复研发;但如果只构建无状态 API,其庞大的内置结构会带来不必要的学习与维护包袱。
- 并发模型与规范校验:FastAPI 原生基于 Python 的
asyncio规范与 Starlette 构建,在 I/O 密集型接口中具备显著的高吞吐优势;同时,它深度集成 Pydantic,以类型提示(Type Hints)自动实现请求数据反序列化与 OpenAPI 文档生成。
2. 典型接口实现示例:FastAPI
以下为一个基础的 FastAPI 接口示例,展示了参数类型校验与 JSON 数据结构的自动映射:
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field

app = FastAPI(title="用户任务服务")

class TaskCreate(BaseModel):
    title: str = Field(..., min_length=2, max_length=50)
    priority: int = Field(default=1, ge=1, le=5)

@app.post("/tasks/")
async def create_task(task: TaskCreate):
    # 自动进行类型校验与转换
    if task.priority > 3:
        return {"status": "success", "message": "高优先级任务已调度", "data": task.dict()}
return {"status": "success", "message": "普通任务已记录", "data": task.dict()}选型建议:对于独立 API、移动端接口服务、数据分析输出网关或与 AI 大模型交互的高吞吐场景,优先使用 FastAPI;对于包含复杂内容管理权限、表单填写和后台管理员交互的系统,优先选择 Django。
二、数据分析与处理核心库
在数据科学与数据分析链路中,Python 拥有统一的标准工作流:利用 NumPy 提供底层矩阵支撑,利用 Pandas 实现表格操作,再通过 Matplotlib 与 Seaborn 完成结果的可视化洞察。
1. 数据分析基础三剑客
- NumPy:提供高效的多维数组对象(
ndarray)和广播函数库。NumPy 底层由 C 语言实现,避免了 Python 原生列表在循环运算中的解释开销,是后续所有数据科学库的基石。 - Pandas:建立在 NumPy 之上,核心对象为
DataFrame和Series。它针对结构化表格数据提供过滤、分组聚合(GroupBy)、表关联(Merge/Join)以及时间序列解析功能。 - Matplotlib & Seaborn:Matplotlib 提供了精细到底层轴线和刻度的绘图能力;Seaborn 则基于 Matplotlib 进行了高层抽象,专注于统计分布图、热力图和多变量关系的直观表达。
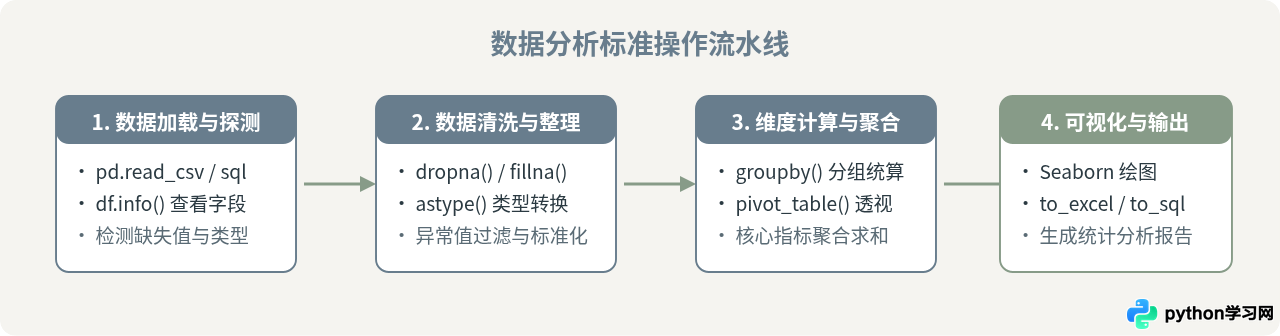
2. 数据分析处理标准流程
通常情况下,数据处理工作遵循从源数据加载到特征清洗,再到聚合分析与结果呈现的标准化四阶段流程:
3. Pandas 清洗聚合代码示例
import pandas as pd

# 示例:清洗交易数据并按部门统计总营收
raw_data = {
    "dept": ["技术部", "市场部", "技术部", "运营部", "市场部"],
    "revenue": [12000, 8500, None, 6400, 9200],
    "headcount": [15, 8, 15, 6, 8]
}

df = pd.DataFrame(raw_data)

# 1. 填补缺失值
df["revenue"] = df["revenue"].fillna(0)

# 2. 分组聚合统计
summary = df.groupby("dept").agg(
    total_rev=("revenue", "sum"),
    avg_rev=("revenue", "mean")
).reset_index()

# 示例输出:
#    dept  total_rev  avg_rev
# 0  市场部    17700.0   8850.0
# 1  技术部    12000.0   6000.0
# 2  运营部     6400.0   6400.0
三、自动化与运维必备库
自动化领域涵盖三大典型诉求:接口数据抓取(HTTP 请求)、前端界面模拟自动化(浏览器交互)以及日常文件批处理与定时任务调度。
1. 网络抓取与交互:Requests 对比 Playwright
在网络自动化中,经常出现用错工具导致的效率低下:
- 轻量级接口抓取:Requests / HTTPX
当目标系统提供标准 RESTful 接口或纯服务端渲染的 HTML 网页时,Requests(同步)或HTTPX(支持同步与异步)是最佳选择。其执行开销极低、并发量大,适合拉取静态网页或与第三方 API 对接。 - 动态单页与界面自动化:Playwright / Selenium
现代单页应用(SPA)高度依赖 JavaScript 在前端动态渲染 DOM 节点,直接使用 HTTP GET 往往只能获得空壳模板。此时必须通过真实无头浏览器(Headless Browser)进行驱动。现代项目强烈推荐Playwright:相比老牌的 Selenium,Playwright 原生具备内置自动等待机制(Auto-waiting)、跨浏览器支持以及简易的录制脚本能力。
2. 文档与调度:openpyxl 与 APScheduler
- openpyxl:处理日常 Excel(
.xlsx)最通用的库,支持逐行读写、公式注入、单元格样式定制等,适合批量导出日报或清洗业务表格。 - APScheduler:轻量级但功能完备的进程内定时任务调度器。支持基于时间间隔(Interval)、Cron 表达式及单次触发(Date),免去了额外搭建 Celery 或依靠外部 Linux Crontab 的部署成本。
四、全景选型决策总结与避坑指南
结合各领域的生产实践,针对不同业务诉求的选型策略总结如下:
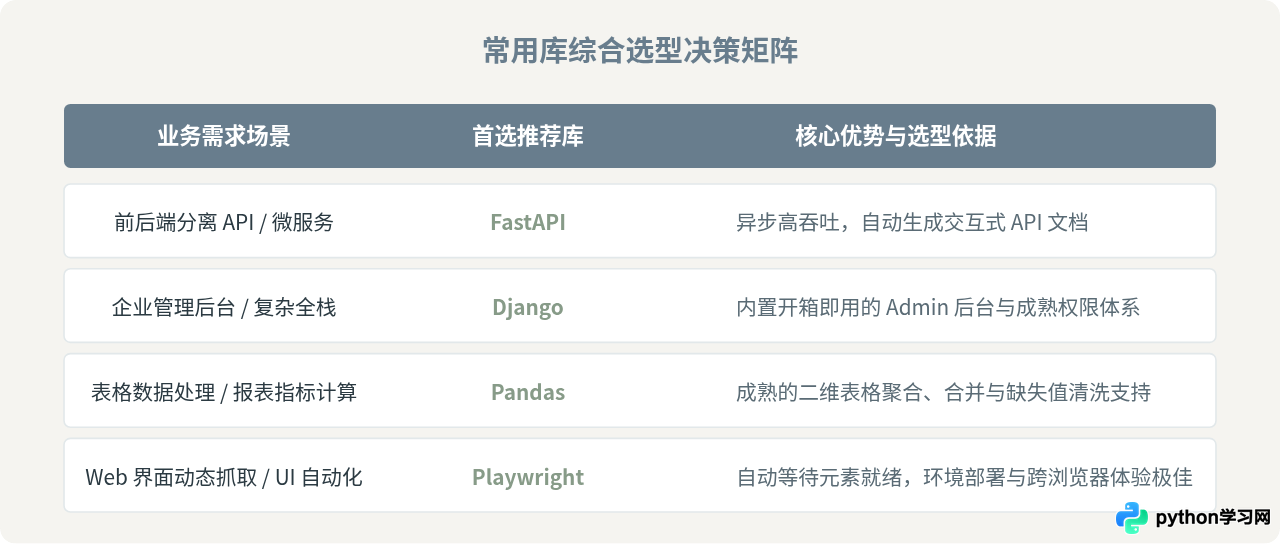
避坑指南:在项目起步阶段,切忌盲目追求“技术新颖”而引入过多相互依赖的组件。例如在无需浏览器渲染的场景中过早引入 Playwright 会造成内存飙升;而在没有类型校验要求的内部脚本中过度封装异步框架也会增加调试门槛。根据核心瓶颈(I/O、开发速度或计算密度)匹配对应生态库,是保障工程稳定的关键。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









