

Python能做什么?数据分析、自动化办公与Web开发应用全景
深入解析Python在自动化办公、数据分析与挖掘、Web开发三大核心领域的真实应用场景、完整工作流、框架选型依据与边界认知,帮助读者建立务实的Python工程技术全景。
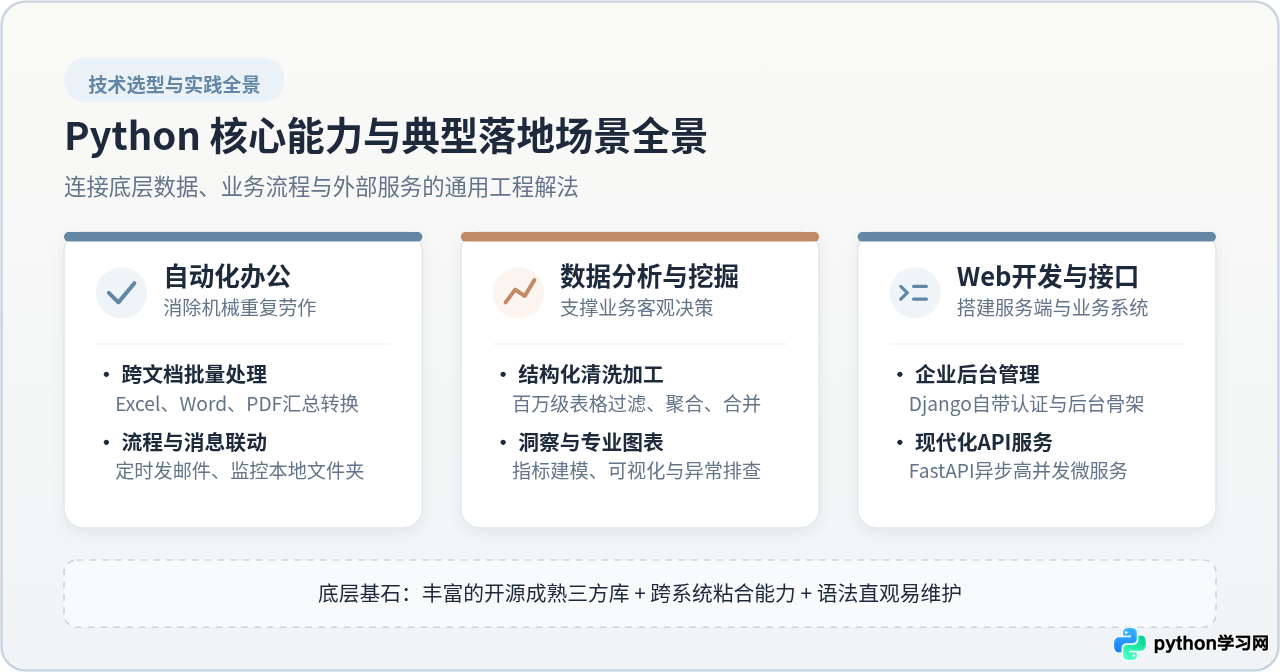
核心答案在于:Python 的核心生产力并不来源于语言本身有多奇特,而在于它作为“工程粘合剂”连接各类底层计算库与操作系统接口的极高效率。如果你正站在技术选型的十字路口,或者希望通过编程解决日常业务中的实际痛点,Python 在当下最成熟、回报率最高的三个应用场景正是:自动化办公(通过代码消除机械重复的手工跨软件操作)、数据分析与挖掘(从杂乱的业务数据中提取统计指标与可视化洞察)、以及Web 开发与接口服务(快速搭建稳定的后台管理系统与高并发微服务 API)。本文将逐一拆解这三大方向的真实落地工作流、关键工具库、可执行代码范例以及技术边界,为你呈现一份清晰务实的应用全景。
一、自动化办公:让批量机械操作转为无人值守流水线
在企业日常运转中,大量时间往往消耗在高度机械化、但跨越多个不同软件的事务上:例如每天从邮箱下载数十个各部门提交的销售周报、手工复制粘贴进总表、核对公式、生成 Word 总结摘要,再打包发给主管。这类工作具有明显的特征:规则高度明确、格式相对固定、数据量不大但步骤琐碎容易人工出错。这正是 Python 自动化办公最能立竿见影的战场。
Python 具备直接读写操作系统底层文件系统以及各类常见办公文件格式(Excel、Word、PDF、邮件协议等)的标准库与三方扩展包。通过编写无头(Headless)脚本,计算机可以在后台以毫秒级的速度完成文件的检索、内容解析、数据合并与网络分发,完全不需要在桌面弹窗打开任何办公软件的图形界面。
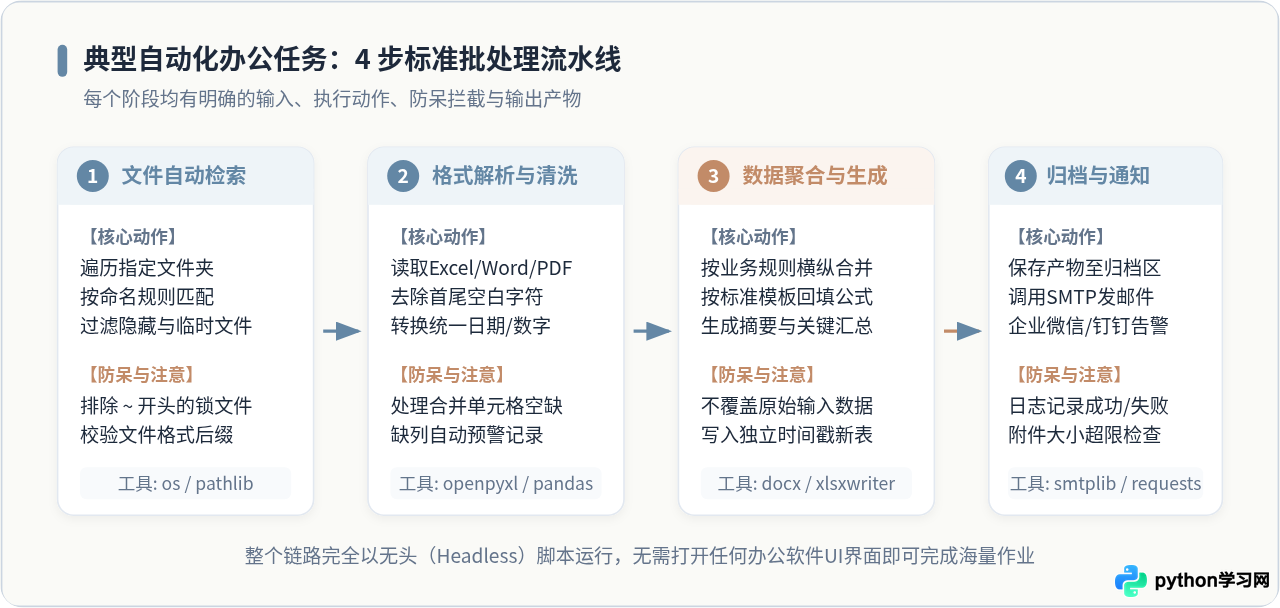
1. 核心支撑技术栈
- 表格批量处理(Excel):
openpyxl用于精细化操作.xlsx的单元格样式、公式和多工作表;对于纯数据矩阵清洗,可直接结合pandas批量汇总。 - 文档与报告排版(Word / PDF):
python-docx用于基于预设模板动态替换占位符生成合同样本;pdfplumber与pypdf负责从电子发票或报告 PDF 中抓取特定表格与文字。 - 系统与网络自动化(OS / 邮件 / 消息):内置的
pathlib统一跨平台的路径遍历与过滤;smtplib与email模块实现定时静默发送附带报表的邮件。
2. 典型实战:多门店销售 Excel 报表自动归拢与汇总
以下示例演示如何遍历指定输入目录,批量读取所有门店提交的销售 Excel,统一做基础数据清洗,汇总并输出带时间戳的总表:
import os
from pathlib import Path
import pandas as pd
from datetime import datetime

def merge_store_sales(input_dir: str, output_file: str) -> None:
    folder = Path(input_dir)
    # 1. 检索符合条件的 xlsx 文件,主动排除以 ~ 开头的临时文件
    excel_files = [f for f in folder.glob("*.xlsx") if not f.name.startswith("~")]

    if not excel_files:
        print("未检测到任何待合并的 Excel 文件。")
        return

    collected_frames = []
    for file_path in excel_files:
        try:
            # 2. 读取并提取门店名称与销售明细
            df = pd.read_excel(file_path, sheet_name=0)
            # 简单清洗:去除全空行,并标明数据来源文件
            df = df.dropna(how="all").copy()
            df["来源文件"] = file_path.name
            collected_frames.append(df)
            print(f"成功读取: {file_path.name}, 记录行数: {len(df)}")
        except Exception as err:
            print(f"跳过损坏或异常文件 {file_path.name}: {err}")

    if not collected_frames:
        print("有效数据为空,停止生成汇总表。")
        return

    # 3. 纵向合并与输出
    final_df = pd.concat(collected_frames, ignore_index=True)
    # 确保输出目录存在
    Path(output_file).parent.mkdir(parents=True, exist_ok=True)
    final_df.to_excel(output_file, index=False)
    print(f"汇总完毕!共整合 {len(final_df)} 行记录,已写入: {output_file}")

if __name__ == "__main__":
    # 执行示例
merge_store_sales("./store_reports", "./summary/total_sales.xlsx")- 不要直接覆盖原始文件:自动化脚本处理文件时,必须采用“读取源数据 ➔ 内存加工 ➔ 写入新路径”的单向流程,并保留原始输入的备份,防止脚本因异常中断导致数据丢失。
- 防御合并单元格与脏表头:人工录入的 Excel 经常存在前三行为大标题、合并单元格或合计行的情况。读取时需使用
skiprows参数跳过无关行,并在合并前严格校验关键列名是否存在。
二、数据分析与挖掘:从杂乱表格到客观商业决策
当业务数据量从几百行攀升到几十万甚至上千万行时,传统的桌面电子表格软件就会面临打开卡顿、公式卡死、无法做高级统计建模的瓶颈。Python 在数据科学领域的统治地位,源于其底层的 C 语言加速数值核心(NumPy)与上层极度易用的二维表格抽象(pandas),辅以现代化的数据可视化库,形成了一条严密的工业级数据加工链条。
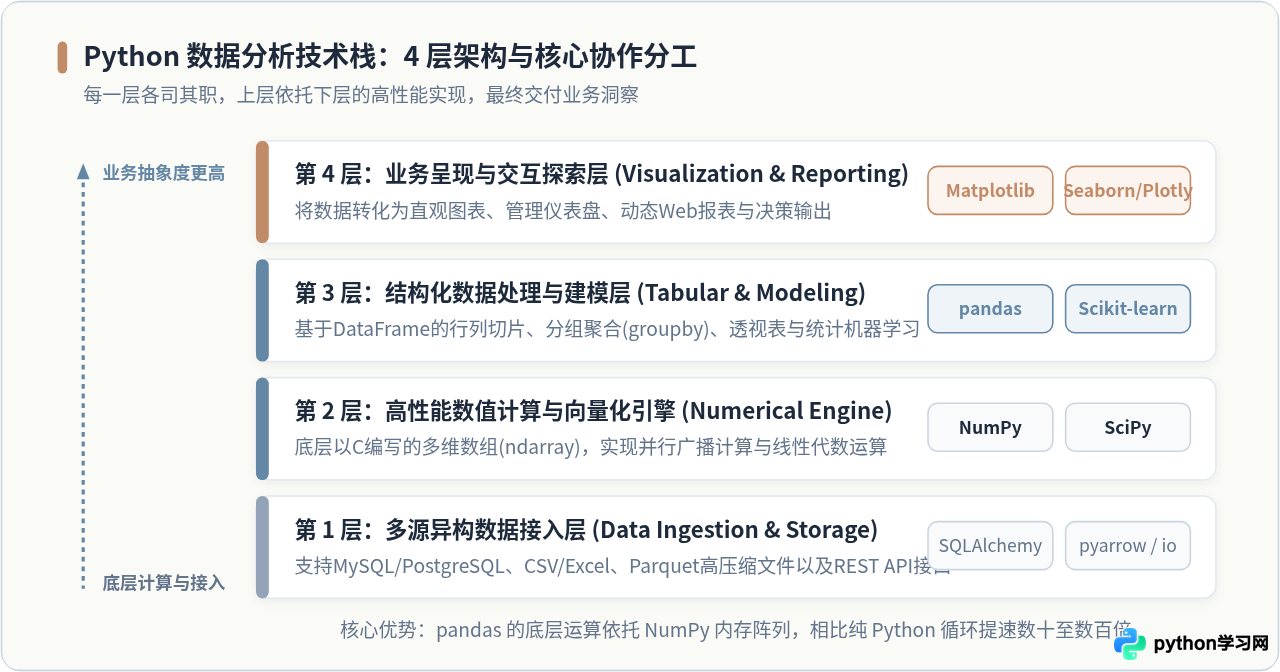
1. 技术分层与分工剖析
- 底层数值引擎(NumPy):提供连续内存存储的
ndarray(N维数组),所有运算采用向量化(Vectorization)广播机制,避免了 Python 原生解释器慢速的for循环,使千万级数值四则运算在微秒内完成。 - 结构化分析基石(pandas):提供带有行列索引的
DataFrame。支持类似 SQL 的关联查询(merge)、分组透视(groupby)、滚动窗口计算以及时序切片。 - 数据呈现与看板(Matplotlib / Seaborn / Plotly):将冰冷的数字转化为线图、热力分布图、箱线图或支持缩放交互的网页仪表盘,直观暴露异常点与长尾特征。
- 预测性建模(Scikit-learn):当统计分析需要更进一步时,Scikit-learn 提供了标准的特征工程、线性回归、决策树聚类等算法,几行代码即可搭建起客户流失预警或销售预测模型。
2. 典型实战:多渠道客单价与退款率深度聚合分析
下面的代码演示了数据分析的经典动作:从 CSV 加载百万级销售订单,处理缺失值与数据类型强转,按渠道与支付方式聚合关键业务 KPI(总销售额、平均客单价、退款率):
import pandas as pd
import numpy as np

def analyze_channel_performance(csv_path: str) -> pd.DataFrame:
    # 1. 显式指定数据类型,降低内存占用并避免类型推断错误
    dtype_spec = {
        "order_id": "string",
        "channel": "category",
        "pay_type": "category",
        "amount": "float64",
        "is_refund": "int8"
    }

    # 2. 读取数据与基础清洗
    df = pd.read_csv(csv_path, dtype=dtype_spec)
    # 填充缺失金额为0,剔除非法测试订单金额小于等于0的记录
    df["amount"] = df["amount"].fillna(0.0)
    valid_orders = df[df["amount"] > 0].copy()

    # 3. 多维度复合聚合:总GMV、有效订单量、平均客单价、退款率
    summary = valid_orders.groupby(["channel", "pay_type"], observed=True).agg(
        total_gmv=("amount", "sum"),
        order_count=("order_id", "count"),
        avg_order_value=("amount", "mean"),
        refund_rate=("is_refund", "mean")
    ).reset_index()

    # 格式化数值展示
    summary["avg_order_value"] = summary["avg_order_value"].round(2)
    summary["refund_rate"] = (summary["refund_rate"] * 100).round(2).astype(str) + "%"

    return summary

if __name__ == "__main__":
    # 示例执行(假设本地已有 orders.csv)
    result = analyze_channel_performance("orders.csv")
print(result.to_string(index=False))- 内存爆炸(OOM):当单文件大于服务器物理内存的一半时,直接
pd.read_csv()容易导致内存溢出崩溃。务必使用chunksize分块流式处理,或转换为列式存储的Parquet格式。 - 避免循环操作每一行:绝不要在 pandas 中用
for index, row in df.iterrows():逐行遍历计算,这会破坏底层 C 连续内存的优化。应始终优先使用向量化操作(如df['a'] + df['b'])或apply()。
三、Web开发与接口服务:将逻辑固化为长期运行的业务系统
脚本和分析报表虽然高效,但通常只能在开发者的本地电脑上运行。当需要让没有技术背景的业务同事查询数据、让移动端 App 调用逻辑、或者与其他企业 SaaS 系统打通时,就必须将 Python 程序构建为能够 7×24 小时响应 HTTP 请求的 Web 系统或 RESTful API 接口。
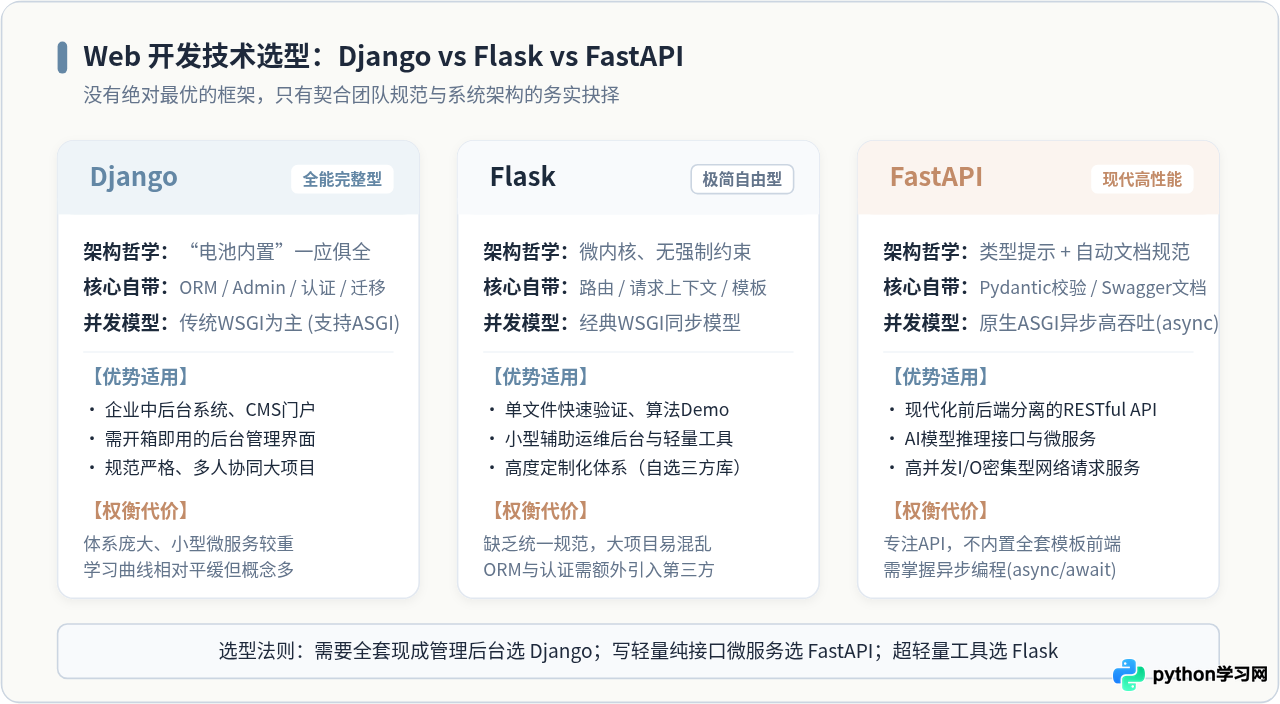
Python 拥有成熟的 Web 开发生态,针对不同的项目体量和系统架构,社区演进出了分工明确的三大主流框架:
1. 三大主流框架的核心定位与选型标准
| 框架名称 | 核心设计哲学 | 内置核心功能 | 最佳应用场景 |
|---|---|---|---|
| Django | “电池内置”(Batteries-Included),高度集成与工程规范 | 自带 ORM、完整的 Admin 后台、用户认证与权限、CSRF 防护、数据库自动化迁移 | 企业中后台管理系统、内容发布平台(CMS)、中大型全功能 Web 平台 |
| Flask | 极简微内核(Micro-framework),轻量无束缚 | 仅包含路由匹配、请求上下文和 Jinja2 模板,其余组件全部按需自由引入 | 小型工具型系统、算法演示 Demo、架构高度定制化的独立小服务 |
| FastAPI | 现代异步框架,深度融合 Python 3.6+ 类型提示与标准规范 | 基于 Pydantic 自动数据校验、原生异步(async/await)、自动生成 OpenAPI / Swagger 交互文档 | 现代化前后端分离的 API 服务、微服务架构、AI 模型推理与高吞吐接口 |
2. 典型实战:使用 FastAPI 构建结构化订单查询微服务
在前后端分离架构中,FastAPI 凭借出色的性能、直观的类型注解和自动文档特性,已成为新项目构建 API 的首选。以下为一个符合生产规范的极简微服务示例:
from fastapi import FastAPI, HTTPException, Query
from pydantic import BaseModel, Field
from typing import Optional
from datetime import datetime

app = FastAPI(
    title="电商业务指标查询服务",
    description="提供给前端大屏与运营后台调用的标准化 RESTful API",
    version="1.0.0"
)

# 1. 定义入参与出参的 Pydantic 数据模式(自动完成类型校验与文档化)
class OrderResponse(BaseModel):
    order_id: str = Field(..., description="订单唯一流水号")
    channel: str = Field(..., description="销售渠道")
    amount: float = Field(..., gt=0, description="订单金额,必须大于0")
    status: str = Field(default="completed", description="订单状态")
    created_at: datetime = Field(default_factory=datetime.now)

# 模拟内存数据库
MOCK_DB = {
    "ORD-202610-001": {"order_id": "ORD-202610-001", "channel": "线上商城", "amount": 299.0, "status": "completed"},
    "ORD-202610-002": {"order_id": "ORD-202610-002", "channel": "线下直营", "amount": 1580.0, "status": "pending"}
}

# 2. 路由与业务逻辑(支持异步并发)
@app.get("/api/v1/orders/{order_id}", response_model=OrderResponse, summary="根据单号查询订单")
async def get_order_by_id(order_id: str):
    order_data = MOCK_DB.get(order_id)
    if not order_data:
        raise HTTPException(status_code=404, detail="未找到对应的订单记录")
    return order_data

@app.get("/health", summary="服务健康检查")
async def health_check():
return {"status": "ok", "timestamp": datetime.now().isoformat()}# 在终端安装依赖并启动开发服务器
pip install fastapi uvicorn
uvicorn main:app --host 127.0.0.1 --port 8000 --reload- GIL(全局解释器锁)与多进程:CPython 的全局解释器锁决定了单进程内纯 CPU 运算无法跨线程并行。在生产部署 FastAPI 或 Django 时,必须配合
Gunicorn / Uvicorn启动多个 Worker 进程来压榨多核 CPU 性能。 - I/O 密集型 vs CPU 密集型:如果接口主要是查数据库、调用第三方 HTTP API,FastAPI 的异步
async def能带来数倍的并发吞吐;如果接口涉及复杂图像渲染或大模型离线计算,应将繁重计算交由 Celery / Redis 后台任务队列异步执行。
四、三大领域的协同效应与工程边界全景
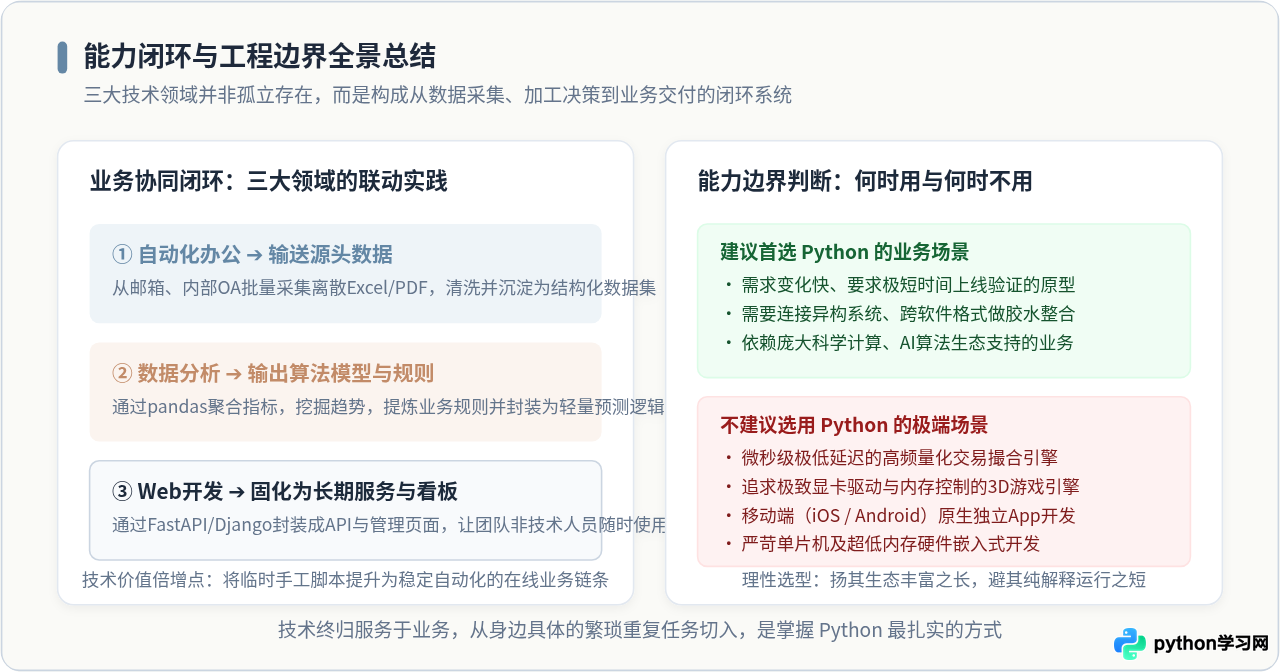
在实际的商业工程落地中,自动化办公、数据分析与 Web 开发极少孤立存在。它们往往是同一个业务问题在不同发展阶段的自然延展:
1. 业务协同闭环工作流
- 第一阶段(数据采集):利用自动化脚本从第三方供应商邮箱、离散的 FTP 目录、或无 API 的内部系统中自动归拢报表,构建起干净的基础数据池。
- 第二阶段(数据分析):分析人员基于 pandas / NumPy 进行聚合分析、指标建模,提炼出关键的波动规则(例如退款率异常突增预警阈值)。
- 第三阶段(服务化与固化):开发人员使用 FastAPI 或 Django 将这些经过验证的清洗规则和分析模型包装为标准的 Web 服务,嵌入到企业现有的看板系统中,使整个业务团队随时受惠。
2. Python 适合与不适合做什么?
理性的技术认知是发挥工具最大价值的前提。Python 是一把极其锋利的瑞士军刀,但它并不是万能钥匙:
- 高度推荐使用 Python 的领域:
- 数据科学、机器学习与 AI 模型工程(拥有全球最庞大、迭代最快的学术与工业生态)。
- 胶水工程与系统集成(整合不同语言、不同数据库、不同协议的异构服务)。
- 中小规模业务系统的敏捷开发与创业原型验证(极高的开发与交付速度)。
- 明确不建议选用 Python 的极端场景:
- 纳秒/微秒级极低延迟系统:高频证券撮合引擎、通信底层交换机驱动,更适合 C++ / Rust。
- 桌面大型 3D 游戏引擎:对显卡显存精细掌控、帧率极其敏感的 AAA 游戏底层,属于 C++ 的阵地。
- 移动端原生独立 App:iOS 原生(Swift)与 Android 原生(Kotlin)在系统级 API 适配和体积功耗上拥有压倒性优势,Python 跨平台移动端方案仅适合内部极简实验。
结语
面对“Python能做什么”这个问题,最切实的答案不是罗列一份无所不包的语法清单,而是看它如何在你的实际工作流中创造价值。无论是用几十行代码消灭每天耗时两小时的报表复制粘贴,还是用 pandas 在数分钟内洞察百万级交易数据的增长秘密,抑或是用 FastAPI 在一个下午搭建起稳定可靠的微服务接口——从身边最繁琐、重复度最高的一个小痛点切入,写下第一个能实际跑通的脚本,正是掌握 Python 应用全景最高效且扎实的起点。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









