

Python脚本运行报错排查:SyntaxError与IndentationError解决
全面解析Python脚本运行过程中常见的SyntaxError与IndentationError成因,提供标准化排查步骤、典型代码示例与自动化预防方案。
Python 脚本启动即报出 SyntaxError 或 IndentationError,意味着源代码未通过解释器的预编译解析阶段,此时程序任何逻辑均尚未运行。彻底解决这两类报错的核心路径是:理解 Python 的两阶段加载机制、掌握向上追溯未闭合符号的“前行定位法”,并在编辑器中强制使用 4 空格缩进代替制表符。掌握这套标准化排查流程,可以在几秒内锁定并修复绝大多数语法与缩进缺陷。
一、错误本质与 Python 启动解析机制
与多数编译型语言不同,Python 是一门解释型语言,但其执行过程并非纯粹逐行边读边跑,而是严格分为两个阶段:语法解析与字节码编译期,以及虚拟机解释执行期。
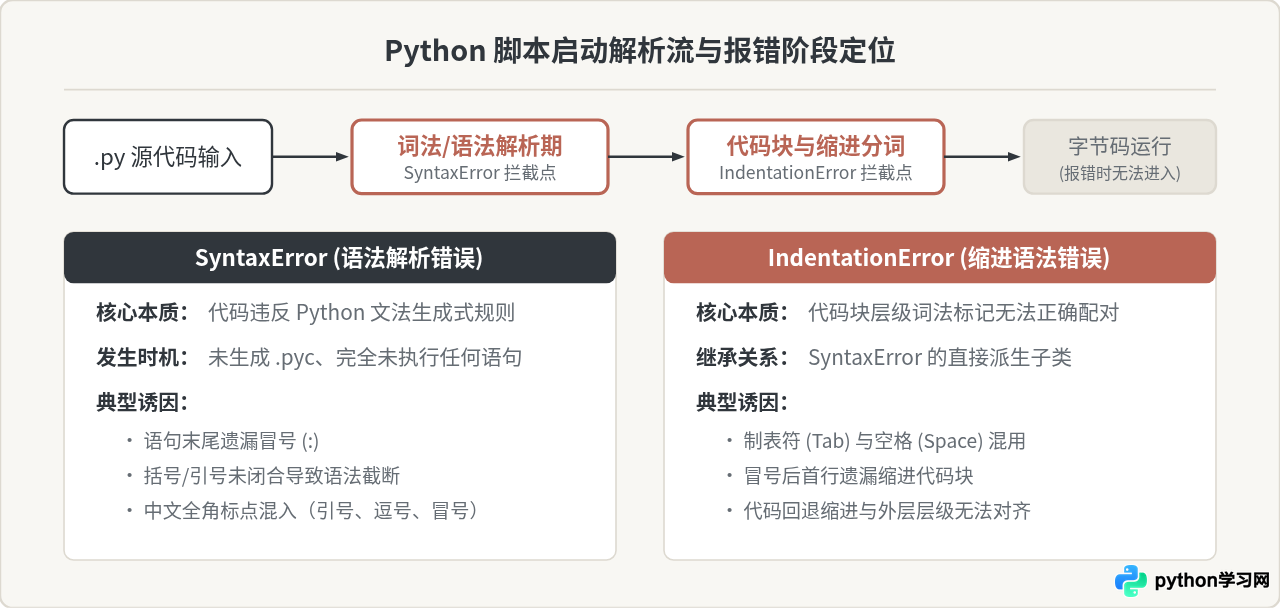
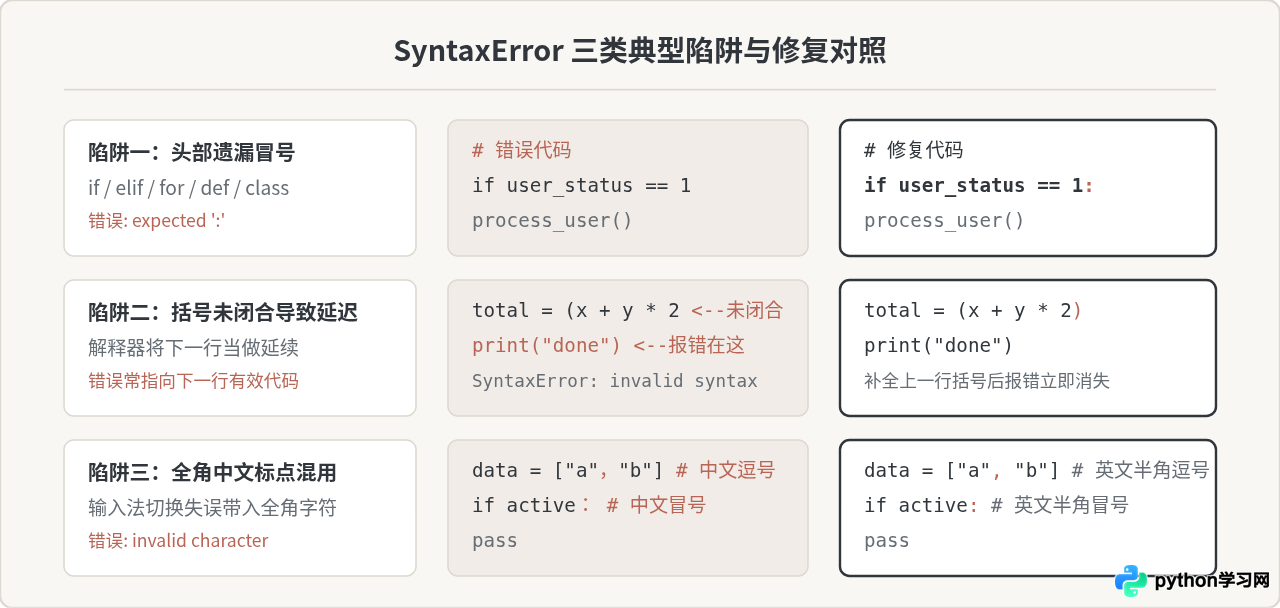
当在终端执行 python script.py 时,Python 解释器首先调用词法分析器(Lexer/Tokenizer)将文本拆解为标记流,接着调用语法解析器(Parser)构建抽象语法树(AST),最后编译为字节码(Bytecode)。如果在这个阶段遇到不符合 Python 文法规范的代码,解释器会立即抛出 SyntaxError 并中断启动;如果解析器在分词过程中发现缩进空格数无法与上层代码块对齐,或者混用了制表符与空格,就会触发其专门子类 IndentationError。
由于这个阶段程序完全没有进入运行状态,因此无法使用 try...except 语句捕获这两类异常。即使在脚本最开头编写了日志初始化、数据库连接或文件操作代码,这些代码也一次都不会被执行。
二、SyntaxError 的常见场景与针对性排查
SyntaxError: invalid syntax 是 Python 中最普遍的报错提示。虽然 Python 3.10 及更高版本引入了更加智能的报错定位(通过 PEG 解析器明确指出如 expected ':' 或未闭合的括号),但在复杂表达式或老版本解释器中,错误提示仍然可能让人产生误解。
1. 控制流语句末尾缺失英文冒号
在 if、elif、else、for、while、def、class、try、except 等复合语句的头部声明末尾,必须以英文半角冒号 : 结尾。遗漏冒号会导致解析器无法识别后续块结构的开启。
# 错误示例:缺失冒号
def calculate_discount(price, is_vip)
    if is_vip
        return price * 0.8
return priceFile "shop.py", line 2
def calculate_discount(price, is_vip)
^
SyntaxError: expected ':'
解决办法:检查箭头 ^ 指向的复合语句行尾,补全半角冒号 : 即可。
2. 括号、引号未闭合引发的“延迟报错”(关键排查点)
这是开发中最常误导读者的场景。当上一行的括号 ()、中括号 []、大括号 {} 或字符串引号未闭合时,Python 会认为当前语句尚未结束,并将下一行代码视为上一行的延续。此时解析器会在下一行遇到非法符号时才抛出报错,导致报错行号往往比实际错误行号偏后一行或几行。
# 实际错误在第 1 行(末尾缺少闭合括号),但解释器在第 2 行报错
user_profile = {"name": "Alice", "role": "admin"
print("User profile loaded successfully.")File "user.py", line 2
print("User profile loaded successfully.")
^^^^^
SyntaxError: invalid syntax
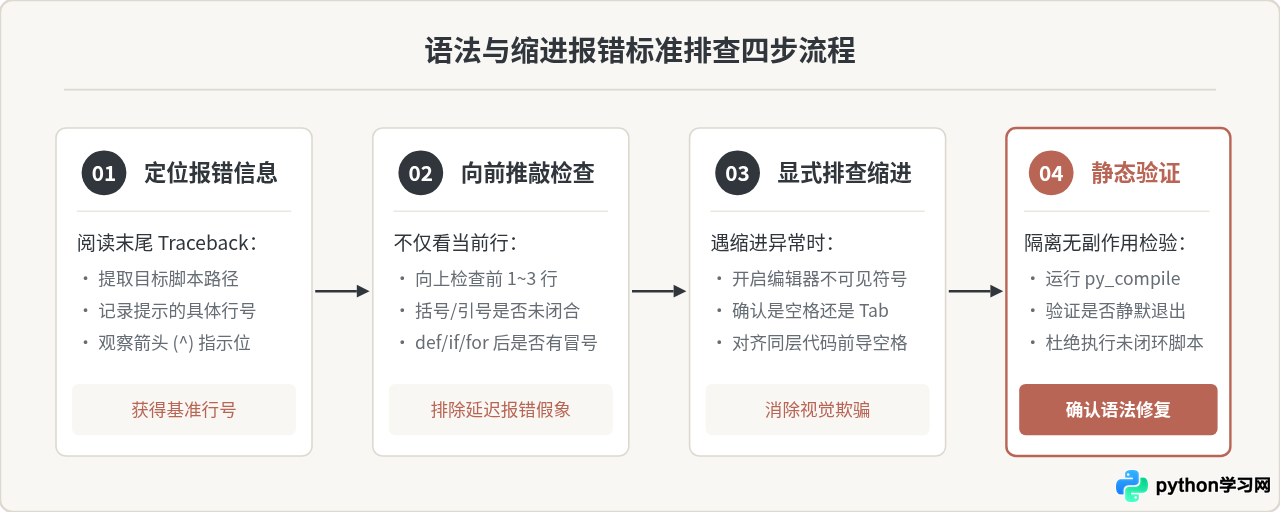
当看到某一行语法看起来毫无瑕疵却报出 SyntaxError 时,务必向上检查前 1 到 3 行代码,重点查看上一行的圆括号、方括号、花括号以及多行字符串单双引号是否完全配对。
3. 全角中文标点符号混入
在使用中文输入法编写注释或文档后,若未及时切换回英文半角状态,容易在代码区敲入全角逗号 ,、全角冒号 :、全角括号 () 或全角双引号 “”。Python 标识符与语法标记严格要求 ASCII 半角字符。
File "data.py", line 4
if status == 200:
^
SyntaxError: invalid character ':' (U+FF1A)
解决办法:将报错提示中的十六进制 Unicode 字符(如 U+FF1A 中文冒号、U+FF0C 中文逗号)替换为对应的英文字符。
三、IndentationError 的具体表现与排查
Python 使用缩进来界定代码块范围,而非 C 风格的 {}。词法分析器会在行首检测到缩进增加时生成 INDENT 标记,检测到缩进减少时生成 DEDENT 标记。一旦缩进关系在逻辑上不合法,就会触发 IndentationError。
1. 常见的三种子提示
- expected an indented block:在复合语句(如
def、if、try)的冒号后,预期应该有一个缩进块,但下一行却直接顶格书写或缩进级别未增加。如果某个代码块暂时不写逻辑,必须写入pass或...占位。 - unexpected indent:在不需要缩进的地方出现了前导空格。例如在普通的顶格函数定义上方无故敲入了 2 个空格。
- unindent does not match any outer indentation level:缩进回跳未能与任何一个外层代码块的起始列对齐。例如外层缩进是 4 个空格,内层嵌套为 8 个空格,但退出内层时写了 6 个空格,解释器无法确认其归属层级。
2. 隐蔽元凶:Tab 与空格混用(TabError)
在不同编辑器中,制表符(\t)的视觉宽度可以被设定为 2、4 或 8 个空格。一段在文本编辑器中肉眼看起来排列整齐的代码,在 Python 解释器看来却可能是 1 个 Tab 后面跟了 4 个空格。Python 3 明确禁止混用 Tab 和空格来缩进同一个代码块,否则会引发 TabError: inconsistent use of tabs and spaces in indentation。
诊断与解决步骤:
- 在 VS Code 中,按
Cmd + Shift + P(macOS)或Ctrl + Shift + P(Windows/Linux),输入并选择 View: Toggle Render Whitespace(显示空格和制表符)。空格会显示为微小的灰色圆点·,Tab 会显示为向右箭头→。 - 统一全文件格式:在编辑器命令面板中执行 Convert Indentation to Spaces(将缩进转为空格)。
- 永久约束:在编辑器的设置中勾选
Editor: Insert Spaces为true,并将Editor: Tab Size固定为4。
四、标准化排查诊断四步流
遇到报错时无需盲目调试,按照以下四步法可以确保排查过程严谨且不产生副作用:
五、使用 py_compile 进行无副作用静态验证
排查修复后,如果脚本内部包含耗时的初始化操作(例如加载大型模型、修改生产数据库或发送网络通知),直接运行脚本来检验语法往往存在风险。此时可以使用 Python 内置的标准库模块 py_compile 进行静态字节码编译验证。
在终端中执行以下命令(将 script.py 替换为待测脚本文件名):
# 静态编译语法检查,不执行任何业务逻辑
python -m py_compile script.py
验证判断依据:
- 如果没有任何输出直接返回提示符(退出码为 0),说明该文件的语法和缩进已经完全合规。
- 如果仍存在语法缺陷,终端会立即输出精准的
SyntaxError或IndentationError追踪日志,而不会触发脚本内部的任何函数调用。
若需要批量验证整个工程目录下的所有 Python 文件,可以使用 compileall 模块:
# 递归静态检查当前目录下的全部 Python 脚本
python -m compileall -q .
六、工程化预防规范与速查总结
为了在团队协作与日常开发中彻底避免两类错误流入运行环境,建议在开发环境中固化以下工程化预防措施:
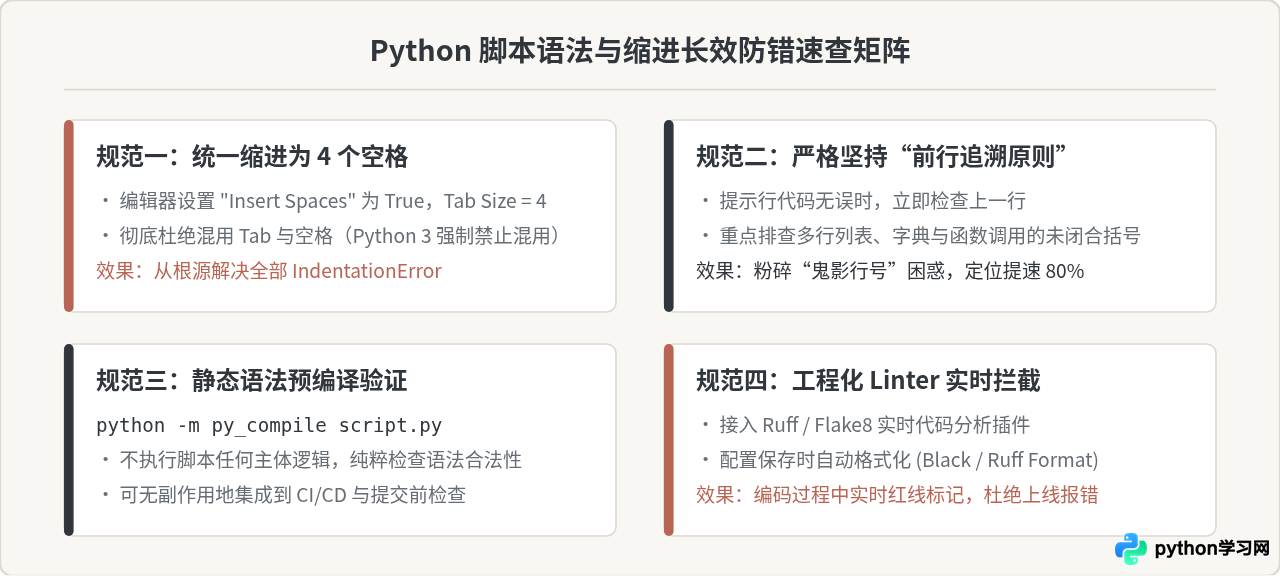
通过在编辑器内开启不可见字符渲染、配置自动格式化工具(如 ruff 或 black),并在持续集成流水线中加入 python -m compileall 检查,开发者便能在输入代码的毫秒级时间内捕获语法违规,使 SyntaxError 与 IndentationError 在上线前被彻底拦截与根除。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









