

Python能做什么?数据分析、Web开发与自动化办公方向解析
全面解析Python在数据分析、Web开发与自动化办公三大核心方向的应用场景、核心库生态、实战代码流程与技术选型建议。
Python 是一门通用型高级编程语言,具备简洁明晰的语法规范与极其庞大的第三方开源生态。在实际产业应用与日常工作中,Python 落地最成熟、覆盖人群最广的三个核心方向分别是数据分析、Web开发与自动化办公。这三个方向分别针对“挖掘业务规律”、“构建在线服务系统”与“批量替代重复性手工操作”三类核心诉求,具备各自明确的工具链标准、实现路径与适用边界。
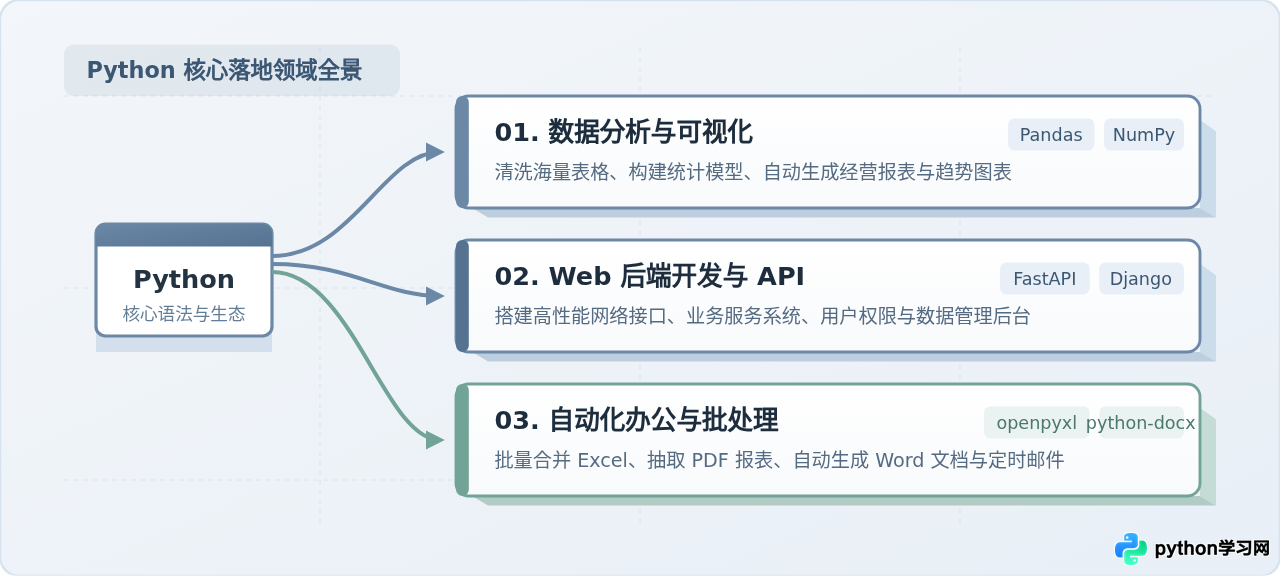
一、数据分析方向:从海量结构化数据到商业决策
数据分析方向的核心目标是从分散、杂乱的原始业务记录中清洗数据、提取统计特征并生成直观的可视化图表,进而为经营策略提供量化依据。传统基于桌面表格软件处理百万级数据时容易出现性能卡死、多源匹配耗时漫长等问题,而 Python 能够通过向量化运算和脚本化管道实现自动化流转。
1. 核心工具链分工
- NumPy:底层依赖 C 语言实现的高性能多维数组(ndarray)计算库,提供了连续内存存储和底层矢量化算子,是现代科学计算与矩阵运算的基石。
- Pandas:数据分析领域的事实标准。其核心数据结构
DataFrame提供类似于增强型 SQL 表的功能,覆盖缺失值清洗、多表联合(Merge/Join)、分组聚合(GroupBy)及时间序列处理。 - Matplotlib 与 Seaborn:高质量图表绘制工具,支持折线图、柱状图、热力图、分布散点图等多维统计图形输出。
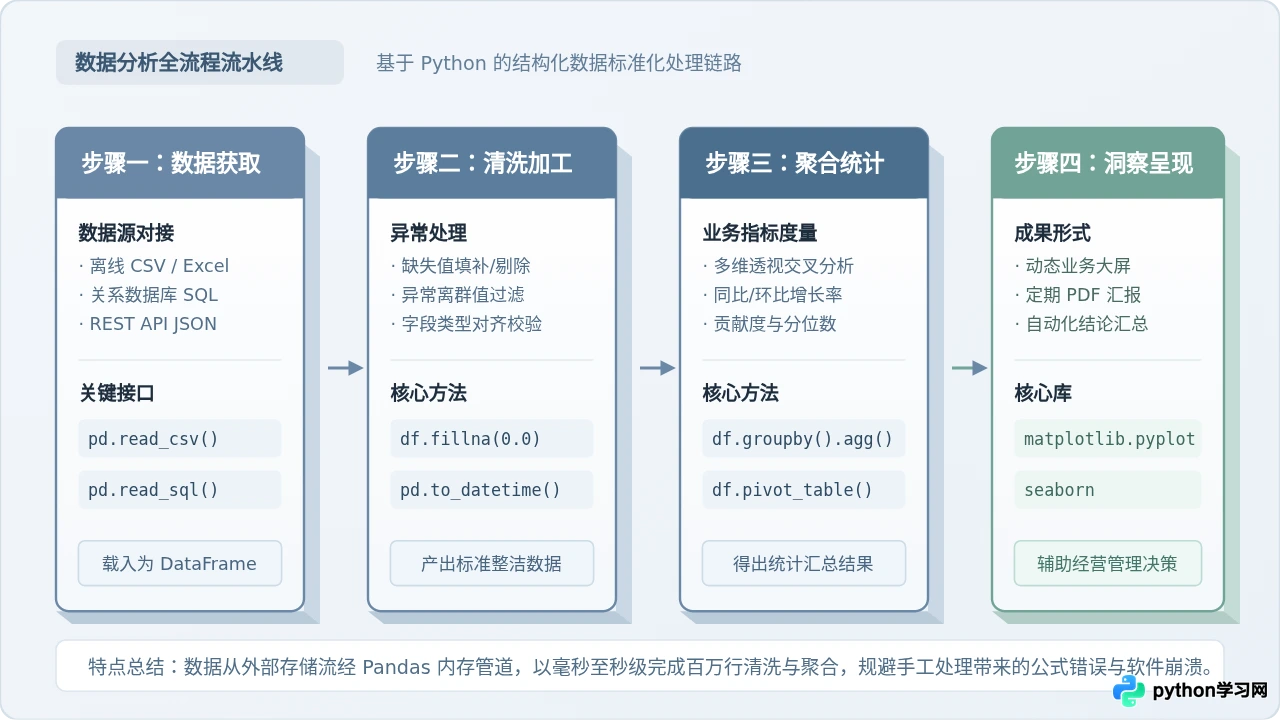
2. 实战示例:门店多维销售业绩聚合统计
以下脚本演示从原始销售明细中过滤空值、将字符串转换为标准时间日期,并按门店维度统计销售总额、订单数及客单价:
环境依赖安装pip install pandas openpyxlimport pandas as pd
# 1. 模拟加载门店原始销售数据
raw_records = [
{"store_id": "Store_A", "category": "数码", "amount": 2599.0, "order_date": "2026-03-01"},
{"store_id": "Store_B", "category": "家居", "amount": 340.5, "order_date": "2026-03-01"},
{"store_id": "Store_A", "category": "数码", "amount": None, "order_date": "2026-03-02"}, # 缺失值
{"store_id": "Store_C", "category": "服装", "amount": 890.0, "order_date": "2026-03-02"},
{"store_id": "Store_B", "category": "数码", "amount": 1200.0, "order_date": "2026-03-03"},
{"store_id": "Store_A", "category": "服装", "amount": 450.0, "order_date": "2026-03-03"},
]
df = pd.DataFrame(raw_records)
# 2. 数据清洗:填充金额缺失值并规范化日期字段
df["amount"] = df["amount"].fillna(0.0)
df["order_date"] = pd.to_datetime(df["order_date"])
# 3. 统计汇总:按门店分组计算总销售额与有效订单数
summary = df.groupby("store_id").agg(
total_sales=("amount", "sum"),
order_count=("store_id", "count")
).reset_index()
# 4. 派生指标计算与排序:计算平均客单价并按销售额降序排列
summary["avg_ticket"] = (summary["total_sales"] / summary["order_count"]).round(2)
summary = summary.sort_values(by="total_sales", ascending=False)
print(summary.to_string(index=False))pd.read_csv(chunksize=...)),或改用基于 Arrow 内存格式的高性能流式引擎 Polars。
二、Web 开发方向:构建高可靠后端服务与 RESTful API
Web 后端开发主要负责处理来自前端页面、移动端 App 或外部第三方系统的网络请求,完成用户权限鉴权、业务逻辑处理以及数据库安全读写。Python 具备兼顾开发效率与扩展能力的框架体系,在微服务接口与内容管理系统中应用广泛。
1. 主流 Web 框架选型标准
- FastAPI:现代异步 API 框架。原生基于 Python 类型提示(Type Hints)与 Starlette 异步底层构建,内置 Pydantic 实现请求体强校验,能够自动生成遵循 OpenAPI 标准的交互式文档,适合前后端分离架构与微服务体系。
- Django:全功能型 Web 框架,遵循“开箱即用(Batteries-Included)”原则。自带强大的关系型数据库 ORM、用户鉴权模型、CSRF 安全防护与内置后台管理面板(Admin),适合中大型管理系统与快速原型开发。
- Flask:轻量微型框架,核心仅保留路由和上下文机制,数据库与表单验证均通过第三方扩展自由组合,适合单一功能的轻量化脚本服务。
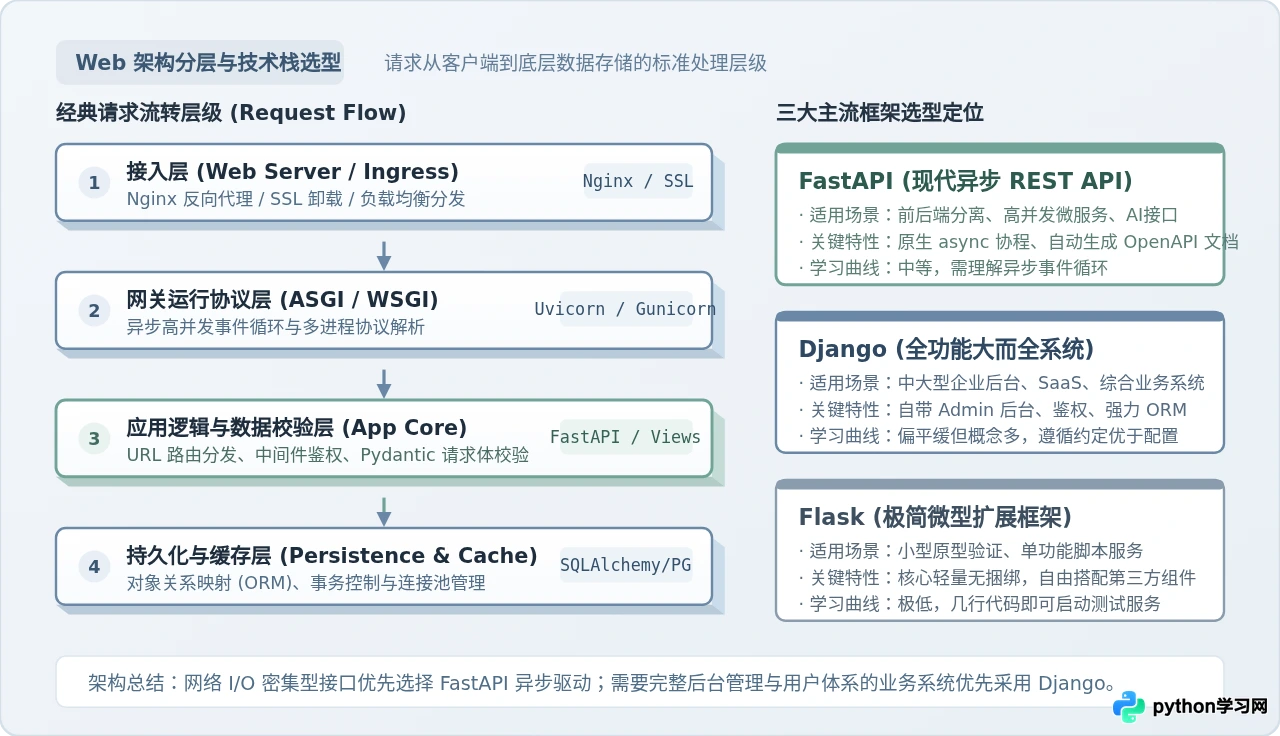
2. 实战示例:使用 FastAPI 构建带参数校验的库存管理接口
以下脚本展示如何使用 FastAPI 与 Pydantic 构建一个带类型安全校验的库存扣减接口:
环境依赖安装pip install fastapi uvicorn pydanticfrom fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field
app = FastAPI(title="商品库存管理服务")
# 模拟数据库中的商品库存表
inventory_db = {
101: {"name": "人体工学电脑椅", "stock": 25, "unit_price": 680.0},
102: {"name": "超宽显示器悬臂支架", "stock": 8, "unit_price": 239.0}
}
# 定义出库请求体校验模式
class DeductStockRequest(BaseModel):
quantity: int = Field(gt=0, description="扣减数量必须为大于0的整数")
@app.get("/items/{item_id}")
def query_item(item_id: int):
if item_id not in inventory_db:
raise HTTPException(status_code=404, detail="未找到指定商品信息")
return {"code": 0, "data": inventory_db[item_id]}
@app.post("/items/{item_id}/deduct")
def deduct_stock(item_id: int, payload: DeductStockRequest):
if item_id not in inventory_db:
raise HTTPException(status_code=404, detail="未找到指定商品信息")
item = inventory_db[item_id]
if item["stock"] < payload.quantity:
raise HTTPException(status_code=400, detail="当前库存不足,无法完成扣减")
item["stock"] -= payload.quantity
return {"code": 0, "message": "库存扣减成功", "remaining_stock": item["stock"]}uvicorn main:app --host 127.0.0.1 --port 8000curl -X POST "http://127.0.0.1:8000/items/101/deduct" -H "Content-Type: application/json" -d '{"quantity": 3}'async/await 协程机制可以在单个 Worker 进程中高效挂起 I/O 等待,配合多进程部署工具(如 Gunicorn + UvicornWorker)能够充分利用多核服务器性能。
三、自动化办公方向:批量消灭机械式重复劳动
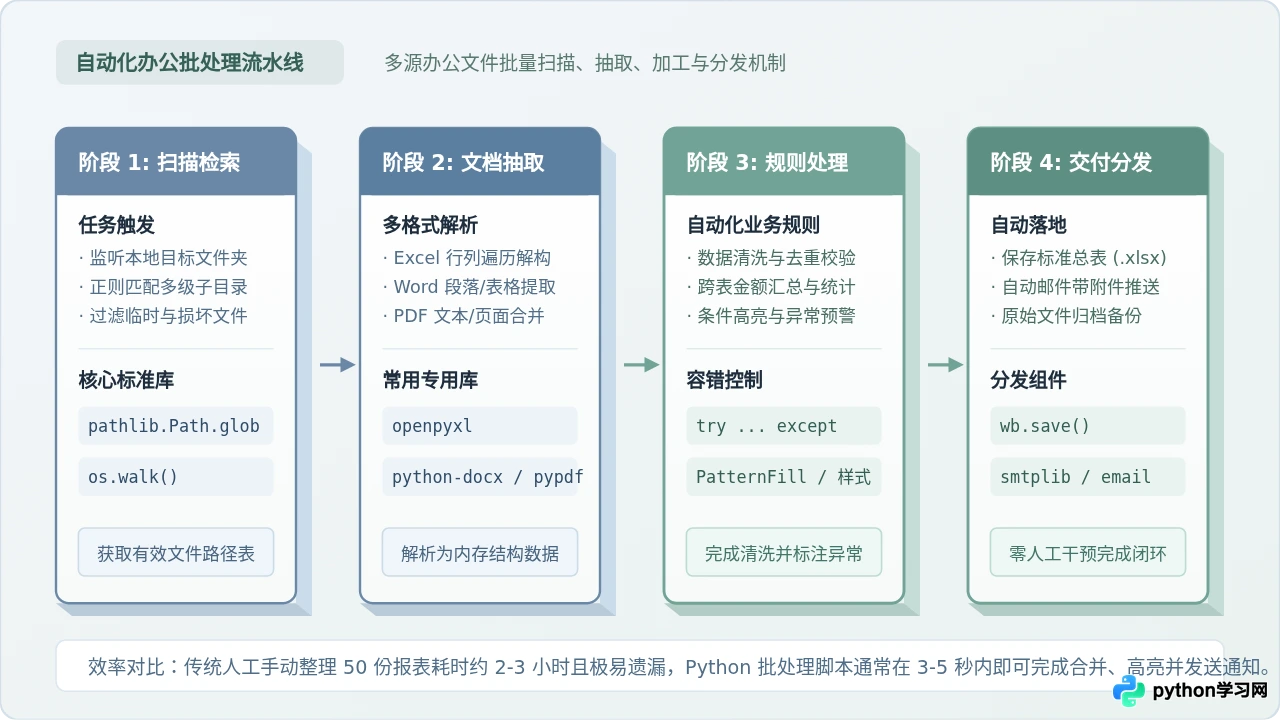
自动化办公方向主要解决日常工作中的格式互转、批量汇总与跨软件流程衔接。在企业日常运营中,经常需要对成百上千份部门报表进行合并汇总、对 PDF 文档进行拆分归档或自动向特定名单发送附件通知。利用 Python 脚本能够建立确定性的执行规则,实现秒级批处理。
1. 常用自动化办公库
- openpyxl / xlwings:专用于读写 Excel(.xlsx)工作簿,支持公式读取、样式设定、批量写入与单元格背景着色;
- python-docx 与 pypdf:支持批量读取 Word 模版并替换关键词,或对批量合同 PDF 进行跨页拼合与文本抽取;
- pathlib 与 os / shutil:跨平台的文件系统路径解析库,负责按照指定通配符遍历多级文件夹、规范化重命名与归档存储;
- smtplib 与 email:Python 内置的网络邮件传输协议库,支持将自动化生成的报表作为附件定时分发至对应负责人。
2. 实战示例:跨部门报销表格批量合并与异常金额标记
以下脚本用于批量读取指定目录下所有部门报销表,提取有效数据行写入汇总总表,并针对单笔报销金额大于 5000 元的异常项目自动添加背景预警色:
环境依赖安装pip install openpyxlfrom pathlib import Path
import openpyxl
from openpyxl.styles import PatternFill, Font
def merge_reimbursement_files(source_dir_path: str, output_file_path: str):
source_dir = Path(source_dir_path)
# 1. 创建目标汇总工作簿
merged_wb = openpyxl.Workbook()
ws_target = merged_wb.active
ws_target.title = "费用汇总总表"
# 写入表头
headers = ["来源文件", "员工姓名", "报销金额", "报销类目", "审计状态"]
ws_target.append(headers)
# 定义高亮预警样式(浅红色背景)
alert_fill = PatternFill(start_color="FFE2E2", end_color="FFE2E2", fill_type="solid")
header_font = Font(bold=True)
for col_num in range(1, len(headers) + 1):
ws_target.cell(row=1, column=col_num).font = header_font
# 2. 遍历源目录下所有的 xlsx 文件
excel_files = list(source_dir.glob("*.xlsx"))
if not excel_files:
print("未检测到待处理的 Excel 文件。")
return
for file_path in excel_files:
# 加载工作簿(data_only=True 确保读取公式计算后的数值)
wb_source = openpyxl.load_workbook(file_path, data_only=True)
ws_source = wb_source.active
# 跳过表头,逐行读取内容
for row in ws_source.iter_rows(min_row=2, values_only=True):
if not row or row[0] is None:
continue
name, amount, item_category = str(row[0]), float(row[1] or 0), str(row[2])
is_over_limit = amount > 5000.0
status_text = "金额超标(>5000)" if is_over_limit else "正常"
# 追加到目标总表
ws_target.append([file_path.stem, name, amount, item_category, status_text])
# 如果超额,为该行单元格填充背景高亮
if is_over_limit:
current_row = ws_target.max_row
for col_idx in range(1, 6):
ws_target.cell(row=current_row, column=col_idx).fill = alert_fill
# 3. 保存合并成果
merged_wb.save(output_file_path)
print(f"处理完成:已合并 {len(excel_files)} 个表格并生成 {output_file_path}")
if __name__ == "__main__":
# 示例调用路径
merge_reimbursement_files("./source_reports", "./年度费用汇总总表.xlsx")try ... except ValueError),避免因某一份子表的格式错误导致整个批处理任务意外中断。
四、三大方向核心维度对比与选型指南
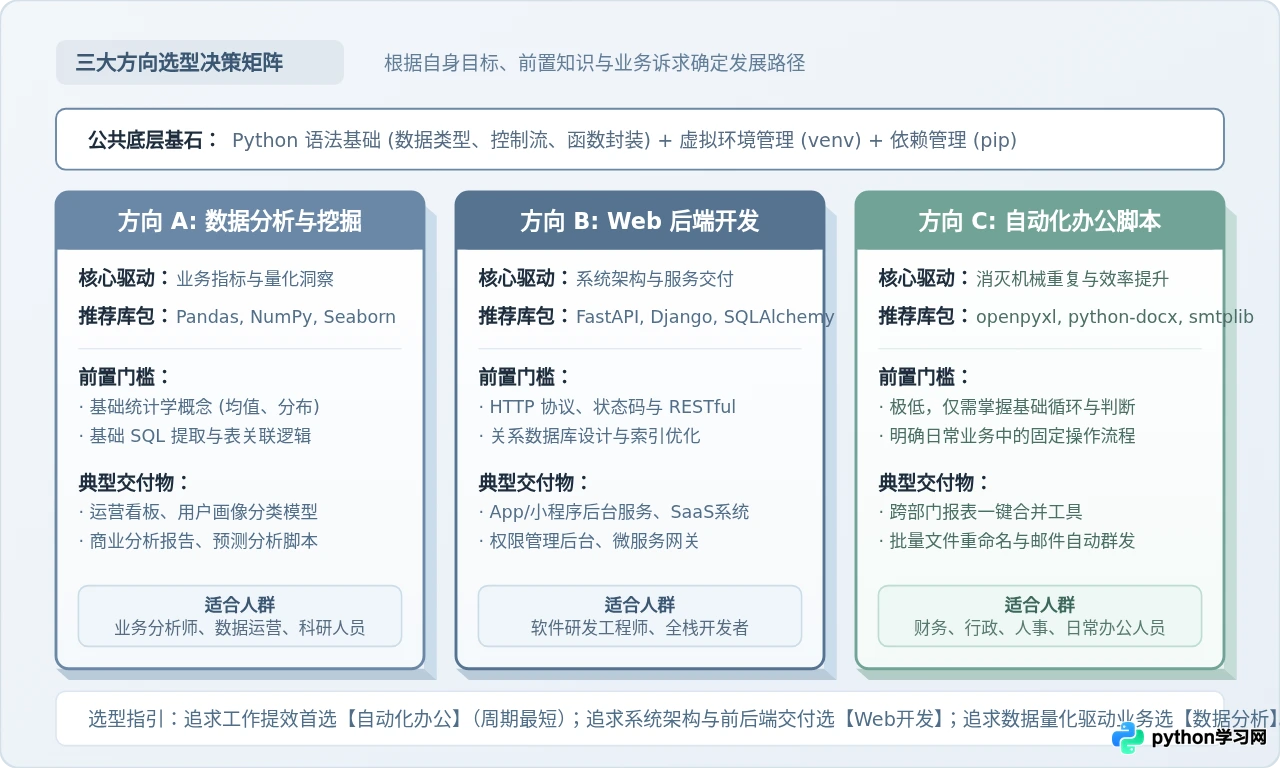
初学者或技术人员在面对不同应用场景时,无需盲目全盘学习,而应根据自身的业务诉求、知识背景及产出目标做出针对性选型。
| 对比维度 | 数据分析方向 | Web 开发方向 | 自动化办公方向 |
|---|---|---|---|
| 核心解决问题 | 清洗多维数据、统计特征推导与业务量化 | 构建网络接口、业务服务流转与数据持久化 | 批量消灭表格/文档/邮件处理中的机械重复劳动 |
| 关键库与技术栈 | Pandas, NumPy, Matplotlib, Seaborn | FastAPI, Django, SQLAlchemy, Uvicorn | openpyxl, python-docx, pypdf, smtplib |
| 前置基础要求 | 基础统计学、表格透视逻辑、SQL基础 | HTTP网络协议、数据库事务与索引、异步协程 | 极低,仅需掌握变量、循环与文件读写基础 |
| 典型输出成果 | 业务分析大屏、周期性经营报表、预测模型 | RESTful API、后台管理系统、微服务架构 | 报表一键合并脚本、自动化邮件群发工具 |
| 学习见效周期 | 1 ~ 2 个月(需结合实际业务指标体系) | 2 ~ 4 个月(需掌握计算机网络与完整架构) | 1 ~ 2 周(快速解决具体桌面重复工作) |
选型判断与落地路径:
- 若当前目标是工作提效:日常工作中频繁面对杂乱的 Excel 报表、Word 模版与文件重命名任务,应当首选自动化办公。该方向不涉及复杂的系统架构,学习两周左右即可直接在日常工作中产生生产力收益。
- 若当前目标是商业洞察或投身量化分析:重点深耕数据分析。先掌握 Pandas 表格变换与清洗,再深入学习数据可视化与 SQL 数据库联动,逐步培养业务敏感度与指标归因能力。
- 若当前目标是软件工程交付与全栈开发:应以 FastAPI 或 Django 为起点深入 Web 开发,系统理解客户端与服务端的请求响应生命周期、数据库设计以及高并发微服务部署。
五、常见实践疑问解答(FAQ)
python -m venv .venv 创建专属虚拟环境,激活后再通过 pip install 安装依赖,这样不同项目之间的类库版本相互独立,能够有效杜绝依赖污染。免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









