

Python字符串包含数字和符号时转大写会怎么

在 Python 中,当对一个包含数字、标点符号或特殊字符的字符串调用 .upper() 方法时,处理规则非常明确且稳定:Python 只会将字符串中的所有小写英文字母转换为对应的大写英文字母,而数字、符号、空格以及中文字符等非字母内容会原封不动地保留,既不会发生任何形式的形变,也绝不会触发报错或异常。
这个特性让开发者在处理各类由字母、数字与符号混合组成的数据(如 API 密钥、订单编号、邮箱地址、配置参数等)时,无需在转大写之前手动将数字或标点过滤剔除。接下来,我们从具体代码表现、逐字符处理流程、底层 Unicode 规范以及开发中的实际案例逐步展开深入探讨。
一、直观代码验证:混合字符串的转换表现
我们可以直接在 Python 交互式命令行或脚本中运行以下示例,观察包含各类字符时的实际输出结果:
# 示例 1:包含小写字母、数字、下划线与减号
raw_code = "app_order-2024_ver#1.0"
upper_code = raw_code.upper()
print("转换前:", raw_code)
print("转换后:", upper_code)
# 输出结果:
# 转换前: app_order-2024_ver#1.0
# 转换后: APP_ORDER-2024_VER#1.0

# 示例 2:包含邮箱常见字符与特殊符号
email = "support-desk_01@api.cloud-service.com:8080"
print(email.upper())
# 输出结果:
# SUPPORT-DESK_01@API.CLOUD-SERVICE.COM:8080

# 示例 3:纯数字与纯符号测试
symbols_only = "12345_--+==!@#$%"
print(symbols_only.upper())
# 输出结果:
# 12345_--+==!@#$%
从输出中可以清晰地观察到两点核心事实:
- 所有英文字母(如
app、order、ver、support)准确地变为了对应的大写(APP、ORDER、VER、SUPPORT); - 数字(
2024、1.0、01、8080)与各类符号(_、-、#、.、@、:)完全维持原样,连位置和数量都没有任何变动。
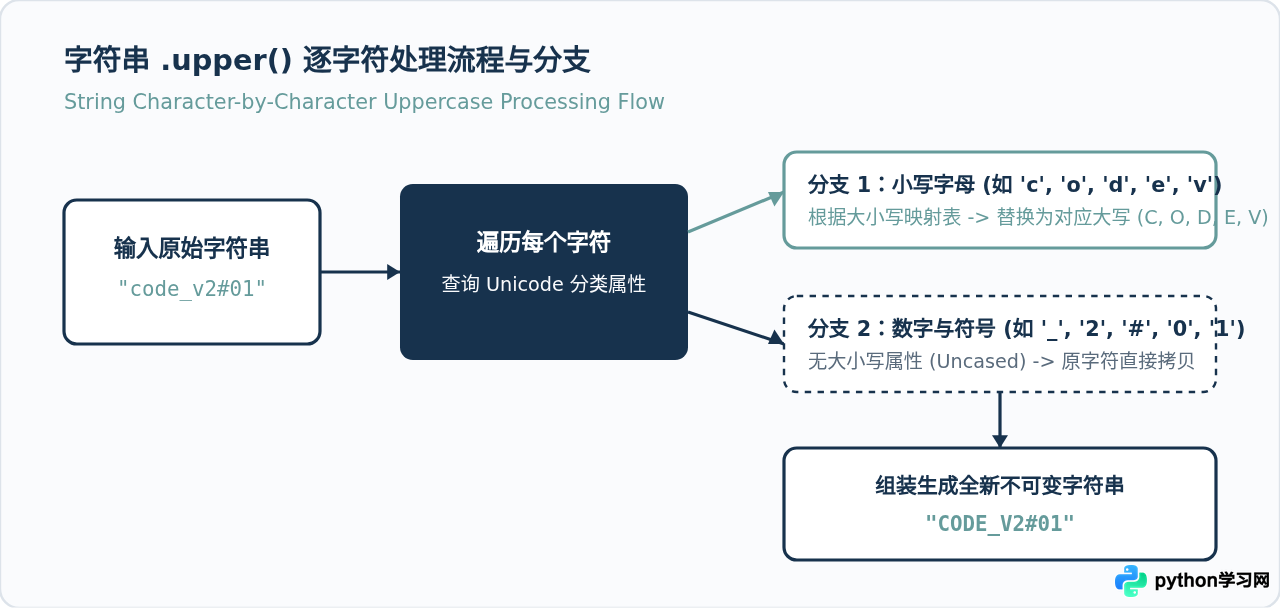
二、底层工作机制:Python 是如何处理非字母字符的?
为了深刻理解为什么数字和符号会被“跳过”且保持原样,我们需要了解 Python 内部对字符串的组织模型与 Unicode 标准的配合机制。
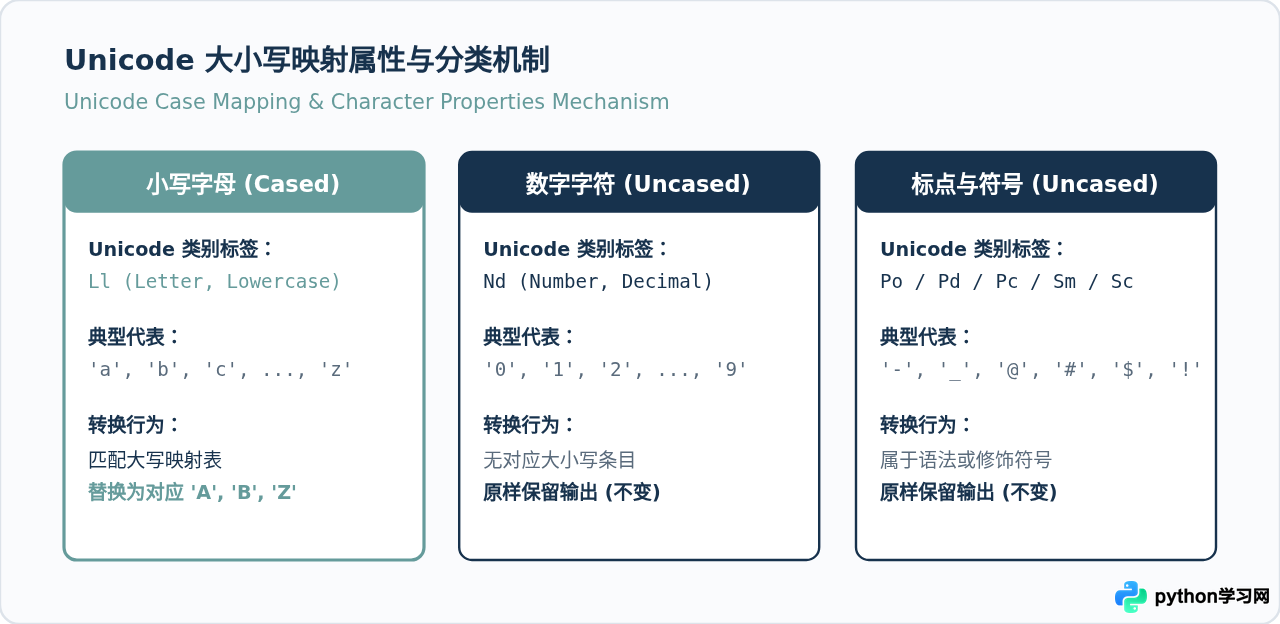
1. Unicode 字符属性(Character Properties)
在 Python 3 中,所有字符串(str)都是基于 Unicode 标准实现的。Unicode 联盟为世界上的每一个已知字符都赋予了明确的分类标签(General Category):
- 具备大小写属性的字符(Cased Characters):例如拉丁小写字母
'a'的分类为Ll(Letter, lowercase),它在 Unicode 数据集中明确绑定了对应的大写映射字符(Uppercase Mapping,即'A',分类为Lu)。 - 十进制数字(Decimal Numbers):例如字符
'0'至'9',分类为Nd(Number, decimal digit)。它们不存在大小写区分。 - 标点与符号(Punctuation & Symbols):例如连接符
'-'(Pd)、各类下划线或连接标点'_'(Pc)、井号'#'(Po)、以及各类数学与货币符号。它们同样没有对应的大写形式。
当 Python 的底层 C 源码执行 str.upper() 时,它会调用 Unicode 核心转换函数。该函数在查表时如果发现当前字符属于 Nd 或 P* 这种“无大小写(Uncased)”类别,其映射条目直接指向字符本身,因而字符被原样拷贝到输出缓冲区中。
2. 字符串的不可变性(Immutability)
值得重点注意的是:Python 中的字符串是不可变对象。调用 s.upper() 并不是在原有内存地址上就地修改字符串,而是**根据转换规则生成并返回了一个全新的字符串对象**。原字符串中的数字和符号既没有被改变,原字符串对象本身也完好无损。
token = "token-auth_9988"
new_token = token.upper()

# 验证原字符串未被修改
print(token)      # 输出仍为: token-auth_9988
print(new_token)  # 输出为: TOKEN-AUTH_9988

# 比较两者的内存地址
print(id(token) != id(new_token))  # 输出: True
三、常见字符类型的转换对照矩阵
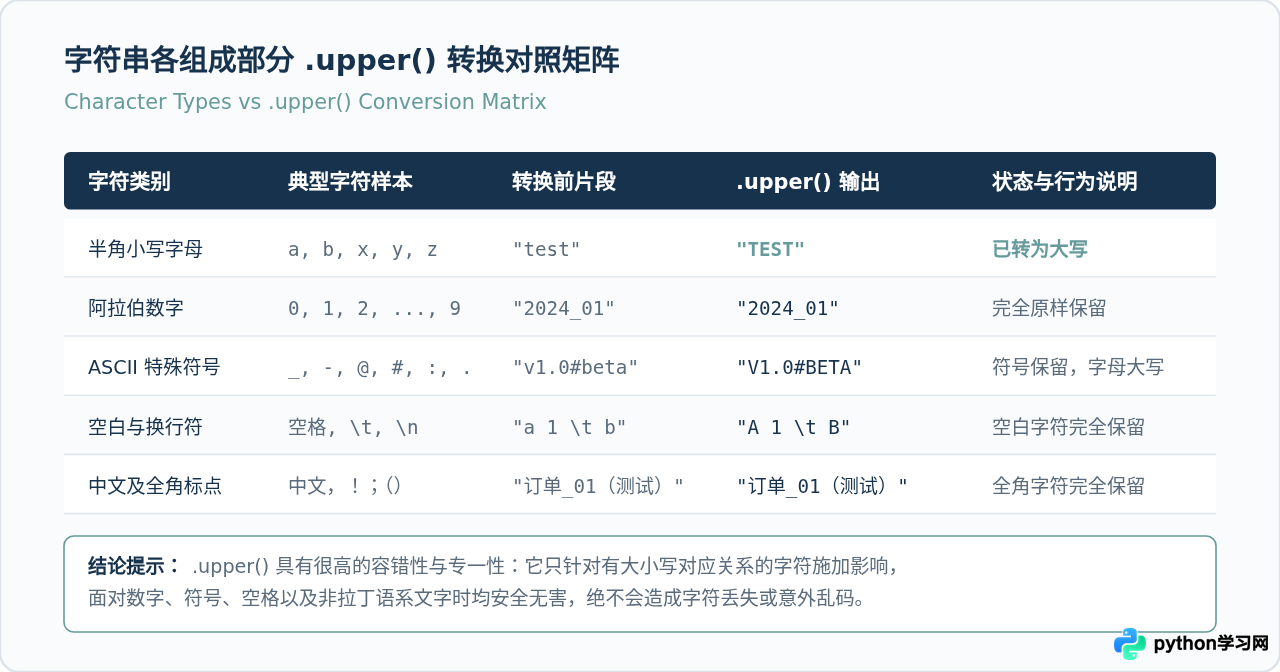
在日常开发中,输入数据往往不仅包含常见的半角英文字符和数字,还可能混杂各种 ASCII 标点、全角符号、空白换行符或多语言文字。下表清晰列出了各类字符在遇到 .upper() 时的具体表现:
四、实际应用场景与典型案例
了解这一行为后,我们在编写业务逻辑时就能更加从容地应对各种混合字符串的处理需求:
1. 不区分大小写(Case-Insensitive)的输入比对
当用户在系统中输入带有连字符或编号的激活码、验证码或订单编号时,通常要求不区分字母大小写。由于数字和连字符不受影响,我们可以直接对输入项与存储值同时调用 .upper() 进行匹配:
stored_license = "KEY-2024-9X8B-A1"
user_input = "key-2024-9x8b-a1"

# 直接转大写后比对,无需手动拆分数字和横杠
if user_input.upper() == stored_license.upper():
    print("激活码验证通过!")
else:
print("激活码错误。")如果比较的目标包含多语言特定字符(例如德语中的小写字母 'ß',其大写形式在 Unicode 中通常转为 'SS'),在纯比对场景下推荐使用 .casefold(),它是 Python 专为不区分大小写匹配设计的全能方案;但如果是格式化展示、输出标准化的大写编号,.upper() 依然是标准且直观的选择。
2. 环境变量名与系统配置键标准化
在微服务或脚本配置中,配置项名称通常包含下划线与数字(如 database_host_1、api_v2_timeout)。为了兼容 POSIX 环境变量规范,常常需要将其统一转换为全大写:
config_keys = ["db_port_3306", "redis_host_01", "app_secret_v2"]
env_keys = [k.upper() for k in config_keys]

print(env_keys)
# 输出: ['DB_PORT_3306', 'REDIS_HOST_01', 'APP_SECRET_V2']
在此过程中,下划线 _ 和数字清晰保留,字母部分则规范转化为全大写,整个过程整洁高效。
五、常见认知误区与避坑指南
在日常使用中,初学者常常容易产生以下三个误区,需要特别注意:
误区 1:误以为 .upper() 可以自动过滤掉标点符号
.upper() 的职责只是改变字符的大小写,它并不是数据清洗工具。如果业务需求要求最终输出只包含纯大写字母而去除所有数字和标点,不能单靠 .upper(),还需要结合正则表达式或 filter 进行过滤:
import re

raw_text = "order-id_#987abc"

# 错误期望:仅调用 .upper() 并不能去掉符号
print(raw_text.upper())  # 仍然是 "ORDER-ID_#987ABC"

# 正确做法:配合正则剔除非字母字符
clean_letters = re.sub(r'[^a-zA-Z]', '', raw_text).upper()
print(clean_letters)    # 输出: "ORDERIDABC"
误区 2:误以为调用 .upper() 会修改原变量
如前所述,字符串具有不可变性。仅仅写 my_str.upper() 而不将结果赋值回变量,原变量的内容是不会发生改变的:
code = "test-123"
code.upper()  # 返回了 "TEST-123",但没有被接收
print(code)   # 依然输出原样: "test-123"

# 正确写法:重新赋值接收返回值
code = code.upper()
print(code)   # 成功更新为: "TEST-123"
误区 3:对非字符串类型调用 .upper()
.upper() 是字符串对象专有的方法。如果一个变量本身是纯整数类型(如 1024),直接调用会抛出 AttributeError:
num = 1024
# num.upper()  # 报错:AttributeError: 'int' object has no attribute 'upper'

# 正确做法:先转换为字符串再调用
print(str(num).upper())  # 输出: "1024" (虽然没有字母,但调用合法安全)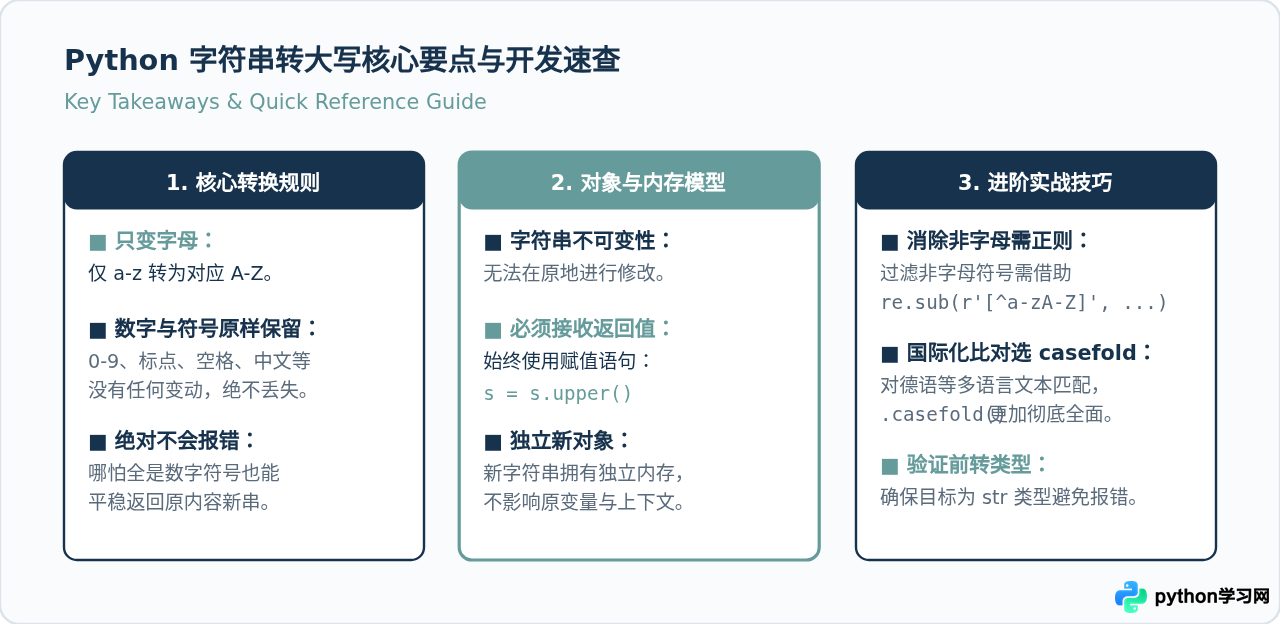
总结
回到最初的问题:“Python 字符串包含数字和符号时转大写会怎么?”
答案是清晰而确定的:只有小写字母会被转换为大写形式,数字和符号会被完整无误地保留在原位,不会发生任何改变,也不会引发任何错误。这得益于 Python 底层严谨遵循的 Unicode 规范与不可变字符串模型。在日常开发中,我们可以放心地对混杂有数字、标点符号的字符串直接使用 .upper() 方法进行格式标准化,只需记住接收新生成的返回值即可。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









