

Python upper()对中文、数字及特殊字符的处理规则
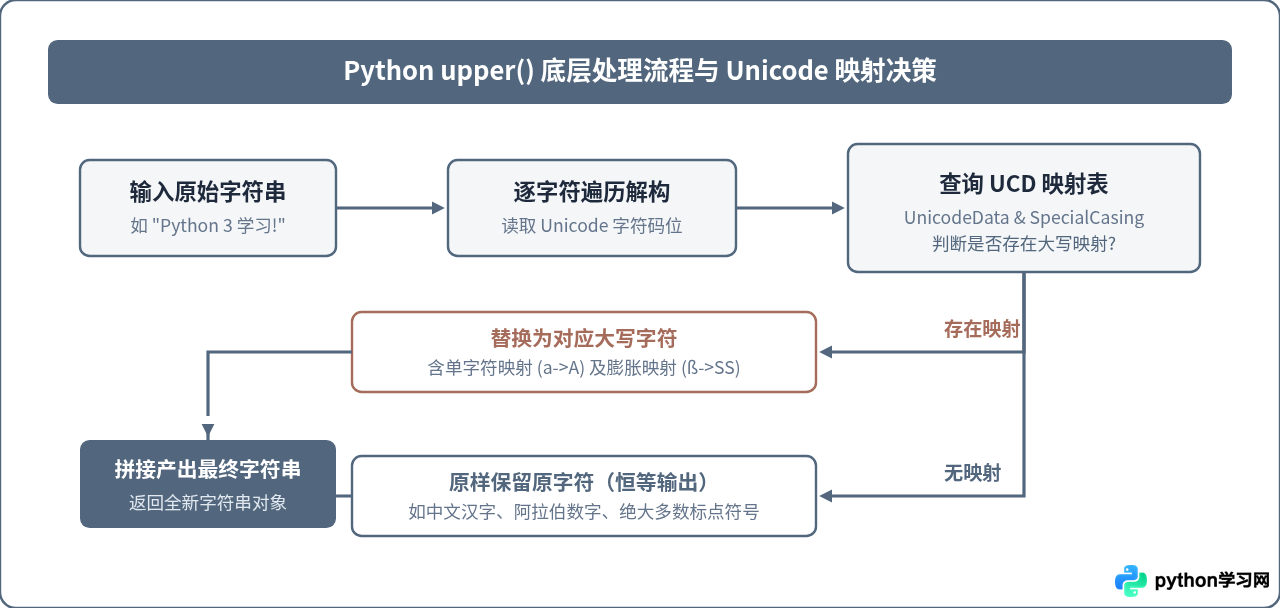
在 Python 中,处理字符串大小写转换最常用的内置方法是 str.upper()。不少开发者初学时常以为它只是简单地把英文字母 a-z 替换成 A-Z。实际上,Python 3 的字符串全面基于 Unicode 标准构建,upper() 遵循的是完整的 Unicode 字符数据库(UCD)大小写映射规范。当输入文本包含中文汉字、全半角数字或各类特殊符号时,Python 既不会抛出异常,也不会盲目更改非字母内容,而是根据每个字符在 Unicode 标准中是否注册了大写映射表来决定行为。本文将逐一拆解 upper() 对中文、数字与特殊字符的处理机制、特例表现及工程实践中的避坑要点。
中文汉字的处理规则:无大小写形态的原样直通
在中文自然语言体系中,汉字属于表意文字,没有“大写”与“小写”的形式区隔。在 Unicode 字符数据库分类中,绝大多数常用汉字被划归为 Lo(Letter, other,即其他类字母类别)。
由于 Unicode 标准中没有为汉字定义大写映射(Uppercase Mapping),Python 的 upper() 方法在遍历到汉字字符时,找不到任何对应的大写码位,因而直接将其原封不动地保留下来。这也意味着纯中文字符串在执行 upper() 操作后,其内容与原字符串完全相同。
# 示例:纯中文与中英混排测试
text_zh = "你好,世界!"
print(text_zh.upper())
# 输出示例:你好,世界!

text_mixed = "Python 学习笔记:版本 3.12"
print(text_mixed.upper())
# 输出示例:PYTHON 学习笔记:版本 3.12
从上面的输出可以看到,中文字符与全角中文标点(“,”、“:”)保持原样,而英文字符 Python 则被正确转换为全大写的 PYTHON。这种设计保证了在处理多语言混合文本时,无需预先过滤中文字符即可安全调用 upper()。
数字字符的处理规则:常规数字与带字母属性的数字
开发者通常接触到的数字分为标准 ASCII 半角数字(0-9)、全角数字(0-9)以及特定领域的特殊数字符号。不同分类在 upper() 下的行为有所差异:
- 标准阿拉伯数字(0-9):在 Unicode 中属于
Nd(Number, decimal digit)分类,没有大小写形态,执行upper()保持原值不变。 - 全角数字(0-9):同样属于
Nd范畴,无论全角还是半角数字,均不发生改变。 - 带字母属性的特殊数字(如小写罗马数字):小写罗马数字符号(如
ⅰ、ⅱ、ⅲ,Unicode 码位 U+2170 至 U+217F)在标准中被归类为Nl(Number, letter,字母数字)。Unicode 专门为其定义了大写映射表,因此调用upper()时会被转换为对应的大写罗马数字(Ⅰ、Ⅱ、Ⅲ)。
# 示例:常规数字与罗马数字转换对比
num_str = "12345 67890"
print(num_str.upper())
# 输出示例:12345 67890 (数字完全不受影响)

roman_str = "chapter ⅲ: data analysis"
print(roman_str.upper())
# 输出示例:CHAPTER Ⅲ: DATA ANALYSIS (小写罗马数字 ⅲ 被转换为大写 Ⅲ)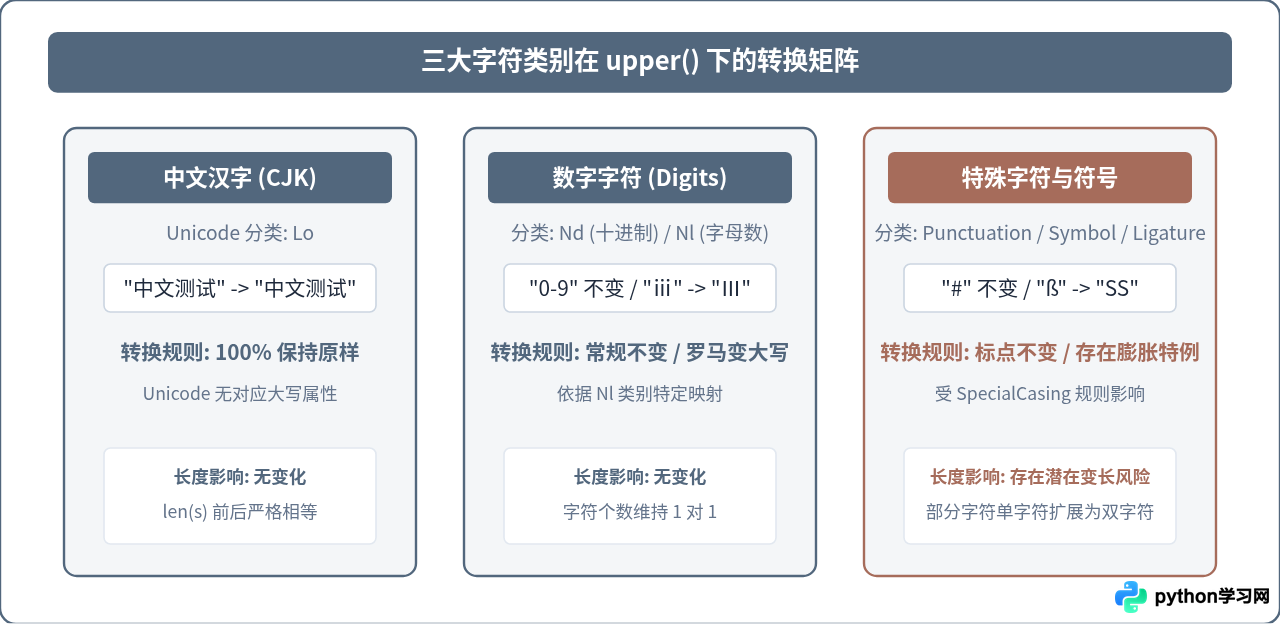
特殊字符与符号的处理规则:标点直通与“隐形变形”
处理特殊字符时,需要将纯符号与包含语言学属性的西文字符区分开来:
1. 常见标点与数学运算符号
键盘上的常规标点(如 !@#$%^&*()_+-=[]{}|;:'",<.>/?)以及各类货币符号(如 $、¥、€),在 Unicode 中被归入 P(Punctuation)和 S(Symbol)类目。这些符号没有任何大小写映射,upper() 会直接保留原字符。
2. 长度发生膨胀的西文特殊字符(重点特例)
这是软件工程中最容易引发 Bug 的边界场景。在 C/C++ 或老旧字符编码时代,程序员习惯假定“大小写转换后字符串长度永远不变”。但在 Python 遵循的 Unicode 规范中,部分字符的大写形式对应两个或多个字符:
- 德语小写锐 S(ß,U+00DF):在传统德语正字法中没有单独的大写字形,其对应的大写规范是双大写
SS。因此"ß".upper()会产生"SS",字符串长度由 1 变成 2。 - 排版合字(Ligatures):如印刷合字
fi(U+FB01),调用upper()会被拆分转换为独立的两个大写字母FI。 - 跨字符集映射(微米符号 µ,U+00B5):拉丁补充字符中的微米符号
µ(Micro Sign)调用upper()后,会被映射为希腊大写字母Μ(U+039C,Greek Capital Letter Mu)。
# 示例:特殊符号、合字与长度膨胀验证
text_punct = "price: $100 & discount: 20%!"
print(text_punct.upper())
# 输出示例:PRICE: $100 & DISCOUNT: 20%! (符号保留,英文字符大写)

text_special = "straße"
upper_special = text_special.upper()
print(f"原字符: {text_special}, 长度: {len(text_special)}")
print(f"大写后: {upper_special}, 长度: {len(upper_special)}")
# 输出示例:
# 原字符: straße, 长度: 5
# 大写后: STRASSE, 长度: 6 (长度发生变化!)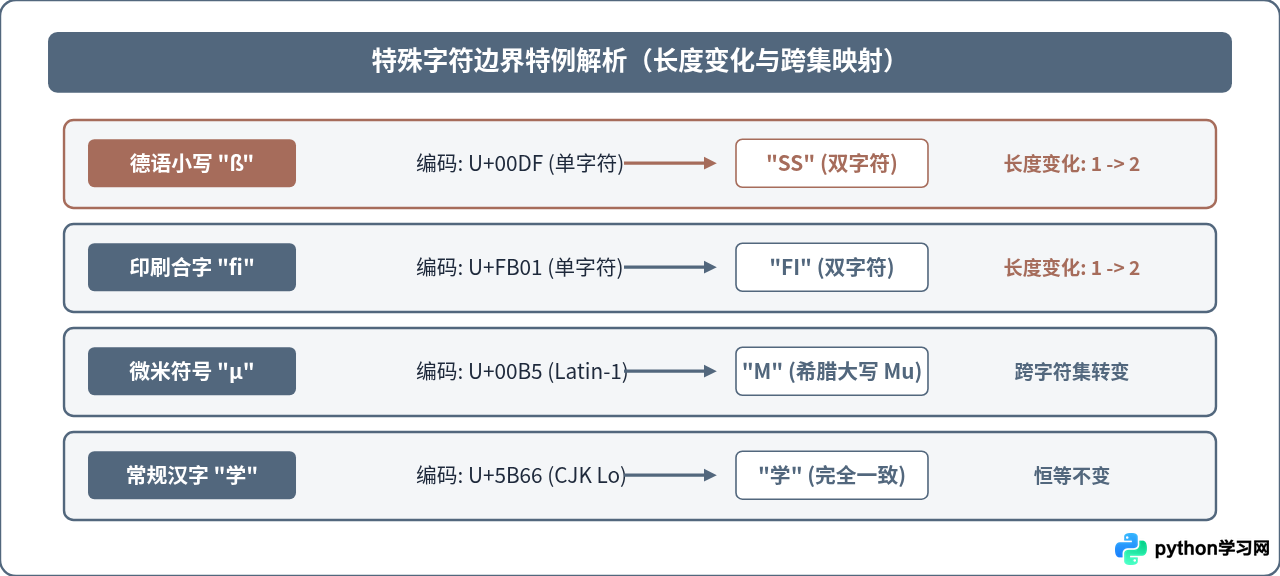
工程应用建议与 upper() vs casefold() 选型
在实际生产开发中,字符串转换通常服务于两类诉求:格式展示/协议规范 与 忽略大小写的文本比对。针对这两类诉求,处理策略截然不同:
1. 格式化输出与协议规范
如果业务目标是生成符合规范的显示文本(如将股票代码、HTTP 请求头或兑换码转为全大写),使用 upper() 是标准做法。此时文本中的中文、数字和连接符会自动保持原貌,无需额外处理。
2. 忽略大小写比对:优先使用 casefold()
如果你的目标是验证两个用户输入的字符串是否相等(如用户名去重、关键词搜索),直接使用 s1.upper() == s2.upper() 可能会出现隐患。例如德语词汇中,小写 ß 与大写 SS 在含义匹配上应等同,但部分语言场景在转大写时无法抹平所有单双向差异。
Python 提供了专门用于忽略大小写匹配的 str.casefold() 方法。它是 Unicode 折叠映射(Caseless Matching)的标准实现,其侵略性更强,能够消除更多不同语言间的字形差异。
# 忽略大小写匹配的推荐方式
input_a = "der Fluß"
input_b = "DER FLUSS"

# 错误做法:直接使用 upper() 可能存在边缘遗漏
print(input_a.upper() == input_b.upper()) # True (此处刚好匹配,但非标准比对方式)

# 推荐做法:使用 casefold() 进行规范化比对
print(input_a.casefold() == input_b.casefold()) # True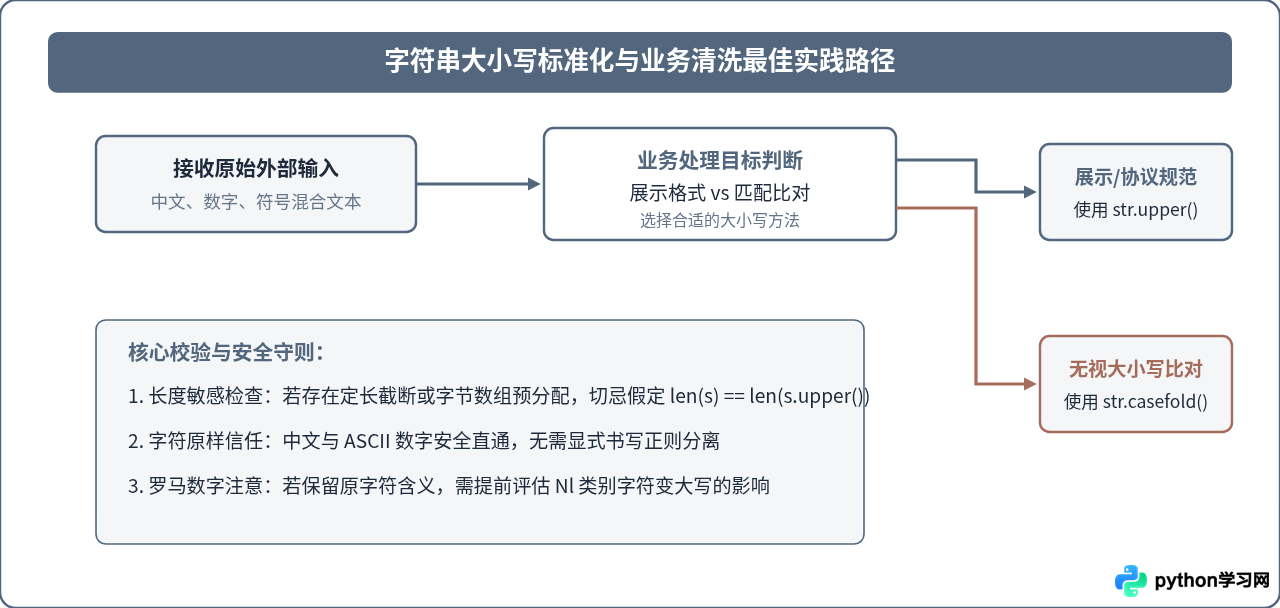
总结与速查清单
| 字符类别 | 典型代表 | upper() 处理结果 | 长度是否可能变化 |
|---|---|---|---|
| 中文汉字 | 你、好、学、习 | 原样保留 | 否(严格相等) |
| 标准阿拉伯数字 | 0, 1, 2, 9 | 原样保留 | 否(严格相等) |
| 全角数字 | 0, 1, 2 | 原样保留 | 否(严格相等) |
| 小写罗马数字 | ⅰ, ⅱ, ⅲ | 转为对应大写 (Ⅰ, Ⅱ, Ⅲ) | 否(严格相等) |
| 常规标点符号 | , . ! ? @ # $ | 原样保留 | 否(严格相等) |
| 特殊西文字符 | ß, fi | 展开为大写 (SS, FI) | 是(单字符变为多字符) |
技术要点回顾:Python 的 upper() 是标准的 Unicode 大写映射器。在处理中英文混排、含数字和标点的常规业务文本时,可以放心地全量调用;但若业务中包含国际化特殊字符并依赖固定字符串长度,必须重新测量转换后的字符长度,并在字符串匹配比对场景中优先选择 casefold()。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









