

Python in和not in用法:成员运算符检测列表与字符串
深入解析Python中in和not in成员运算符的核心机制,对比列表元素全等匹配与字符串连续子串检索的区别、执行效率及避坑指南。
初学 Python 时,很多开发者写过类似这样的测试代码:想要检查某个单词前缀是否存在于集合中,写下 "app" in ["apple", "banana"] 却得到了 False;但如果换成 "app" in "apple",返回结果却是 True。同样是使用 in 运算符,为什么列表和字符串给出了截然相反的判断?核心原因在于 Python 中的 in 与 not in 是成员运算符(Membership Operators),而“成员”的具体判定准则完全取决于底层容器的数据结构:在列表中它校验的是离散元素的独立全等性,而在字符串中它检验的是连续字符的子序列关系。本文将系统拆解这两个运算符在列表与字符串中的求值原理、典型场景、常见陷阱以及工程中的性能边界。
一、成员运算符的核心语义与求值机制
在 Python 语法体系中,in 与 not in 专门用于测试一个序列或集合中是否存在指定对象。该表达式的求值结果永远是布尔值(Boolean):满足条件返回 True,不满足则返回 False。
x in s:当序列s中存在等于x的项时求值为True,否则为False。x not in s:当序列s中不存在等于x的项时求值为True,否则为False。它在逻辑上等价于not (x in s)。
很多初学者容易将条件判断表达式中的 in 与 for ... in ... 循环混淆。虽然二者使用了相同的关键字,但用途完全不同:循环语句中的 in 是迭代协议(Iteration Protocol)的一部分,用于逐个提取容器中的元素;而表达式中的 item in container 是成员判定,产生一个布尔值用于条件分支。
二、在列表中使用 in 与 not in:元素全等匹配
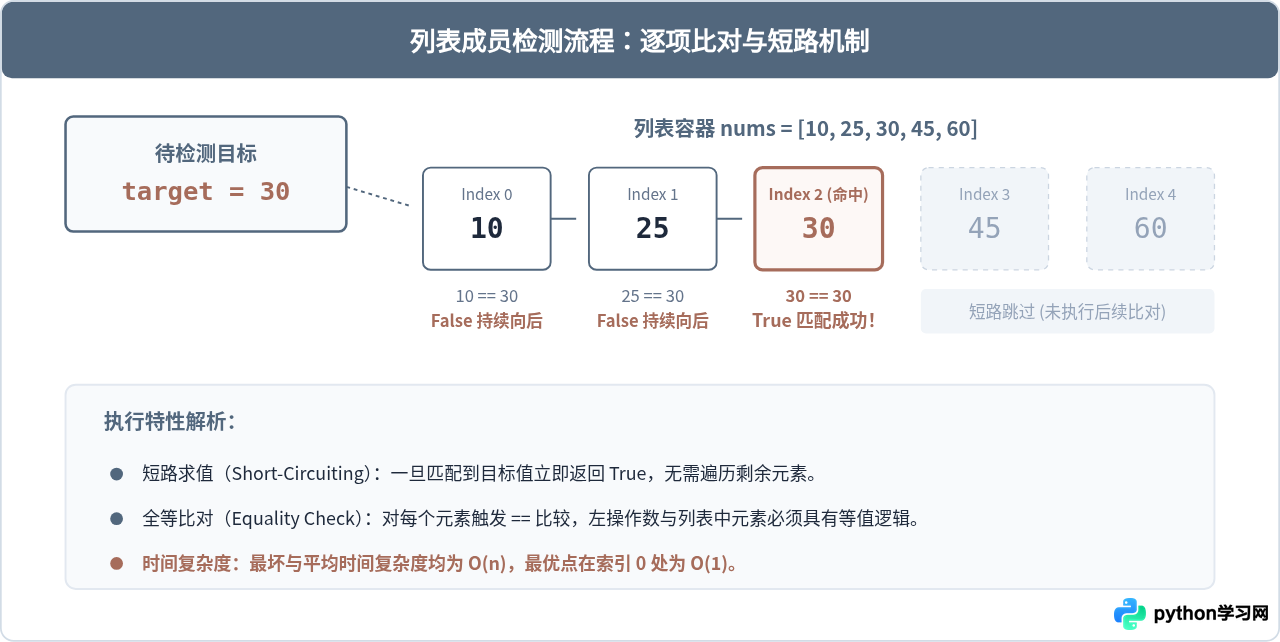
列表(List)是 Python 中最常用的有序容器。当对列表执行 target in my_list 操作时,Python 会从索引 0 开始向后逐项遍历列表,将目标值 target 与当前元素进行等值比对(底层执行 target == element)。一旦找到等值元素,操作立即停止并返回 True,这种短路特性(Short-Circuit)避免了无谓的后续计算;若遍历完整张列表仍未匹配成功,则返回 False。
# 列表成员检测基础示例
languages = ["Python", "Go", "Rust", "TypeScript"]

# 1. 精确匹配已存在的元素
print("Python" in languages)        # 示例输出:True

# 2. 匹配不存在的元素
print("Java" in languages)          # 示例输出:False

# 3. 使用 not in 判断缺席
if "Java" not in languages:
print("列表中尚未收录 Java 语言") # 示例输出:列表中尚未收录 Java 语言"Py" in ["Python"] 也是 False,因为 "Py" == "Python" 结果为假。如果需要检查列表中是否存在以 "Py" 开头的字符串,必须使用列表推导式或生成器表达式,例如 any(item.startswith("Py") for item in languages)。
三、在字符串中使用 in 与 not in:连续子串检测
与列表不同,字符串属于字符的不可变序列。当对字符串执行 sub_str in full_str 时,Python 并非将 full_str 拆解成单个字符逐一匹配,而是执行**连续子串搜索**(Substring Search)。
# 字符串成员检测示例
article = "Python is powerful and beginner-friendly"

# 1. 多字符子串检测
print("power" in article)          # 示例输出:True

# 2. 单字符检测
print("P" in article)              # 示例输出:True

# 3. 大小写敏感检测
print("python" in article)         # 示例输出:False (原文为大写 Python)

# 4. 空字符串检测
print("" in article)               # 示例输出:True
关于字符串成员检测,有三个不可忽视的底层细节:
- 大小写敏感(Case Sensitivity):Python 字符串比对基于 Unicode 码位。若需要忽略大小写,应先将其统一转换,例如
keyword.lower() in text.lower()。 - 空字符串永远返回 True:按照集合论与字符串定义,空字符串
""是任意字符串的合法子串。因此对于任意字符串s,"" in s恒为True。在做输入有效性过滤时需格外注意。 - 严格的类型约束(TypeError):字符串成员检测的左操作数必须是
str类型。如果传入整型、浮点型或列表,将直接抛出运行时异常。
# 常见错误:类型不匹配
code = 404
response_text = "Status: 404 Not Found"

# 错误写法:TypeError: 'in <string>' requires string as left operand, not int
# print(code in response_text)

# 正确写法:显式转为字符串
print(str(code) in response_text)  # 示例输出:True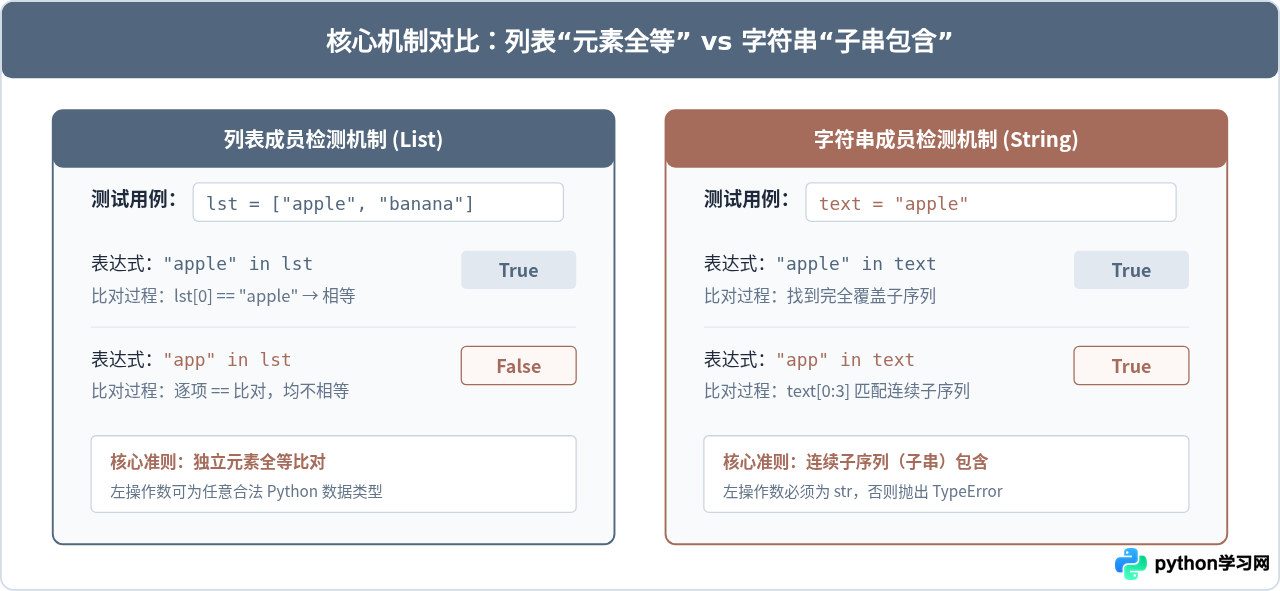
四、not in 的语义反转与工程应用
not in 是 Python 提供的原生操作符,专门用于检测“某个成员不属于指定容器”。在日常工程开发中,not in 经常用于**防御性校验**、**数据去重收集**与**访问权限过滤**等场景。
1. 模式一:收集不重复元素(去重)
# 场景:保持原始顺序的列表元素去重
raw_data = ["apple", "orange", "apple", "banana", "orange", "grape"]
unique_list = []

for item in raw_data:
    if item not in unique_list:
        unique_list.append(item)

print(unique_list)
# 示例输出:['apple', 'orange', 'banana', 'grape']
2. 模式二:非法输入拦截与敏感词检查
# 场景:检测输入文本是否包含违规字符
forbidden_keywords = ["admin", "root", "system"]
username = "super_admin"

# 结合 any 与 in 检查敏感子串
is_forbidden = any(kw in username for kw in forbidden_keywords)
if is_forbidden:
    print("用户名包含受保护的系统保留字,请重新输入")
else:
    print("用户名合法")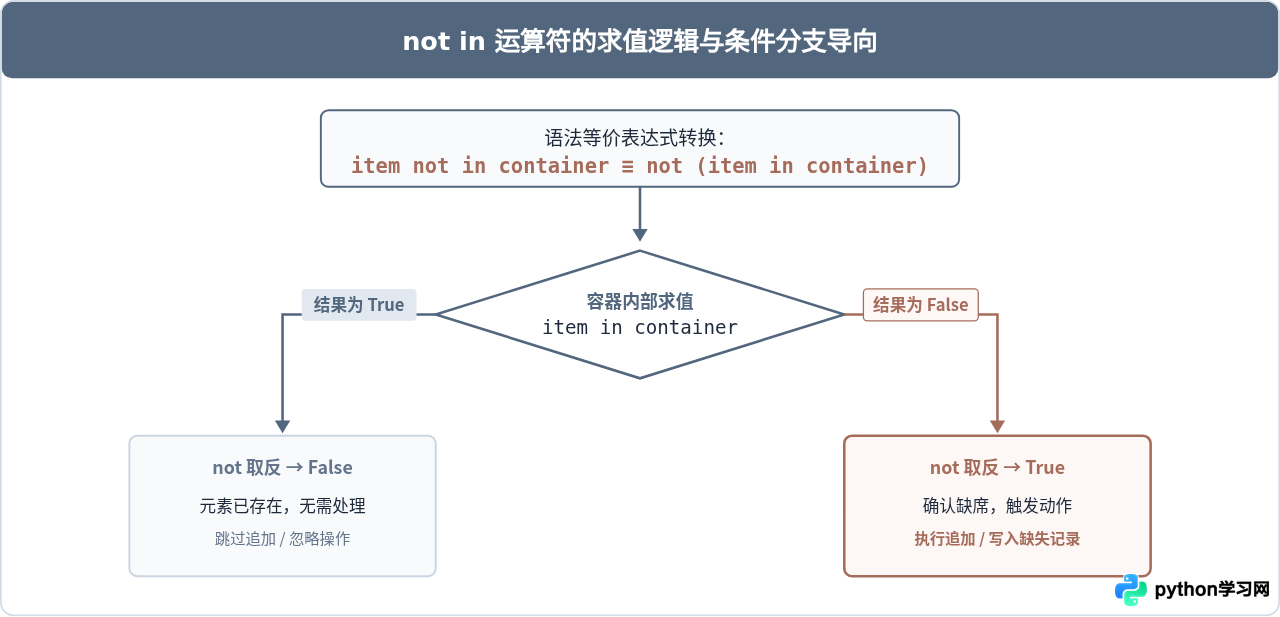
五、性能复杂度与边界避坑指南
虽然 in 和 not in 语法极其优雅直观,但在大规模数据或高频循环中使用时,如果不了解背后的时间复杂度,很容易引发严重的性能瓶颈。
1. 列表的 O(n) 线性瓶颈与 set 优化
列表基于连续内存数组存储指针,要确定一个对象是否存在于列表中,最坏情况下必须完整检查每一个元素,因此其时间复杂度是 O(n)。当列表长度达到数万甚至数百万级时,如果在 for 循环中频繁调用 x in my_list,整体复杂度将飙升至 O(n²),导致程序运行耗时成倍增加。
针对频繁的成员判定场景,标准的优化策略是将列表转换为集合 set 或字典 dict。集合底层基于哈希表(Hash Table)实现,其成员检测的平均时间复杂度为 O(1):
# 性能优化对比演示
# 假设有 100,000 个元素的候选列表
large_list = list(range(100_000))
search_target = 99_999

# 方式一:在列表中检索 -> O(n) 时间,需迭代约 10 万次
result1 = search_target in large_list

# 方式二:转为集合后检索 -> O(1) 平均时间,基于哈希槽瞬间定位
large_set = set(large_list)
result2 = search_target in large_set
2. 复合逻辑语句中的运算符优先级
在复杂的布尔表达式中,in 和 not in 属于比较运算符(Comparison Operators),它们的优先级**高于**逻辑运算符 not、and、or。为了保证代码意图绝对清晰,建议在组合多个条件时始终使用圆括号进行分组:
# 推荐明确添加括号保证可读性与无歧义
if (user_role in ["admin", "root"]) and (status not in ["banned", "pending"]):
    print("允许进入系统管理面板")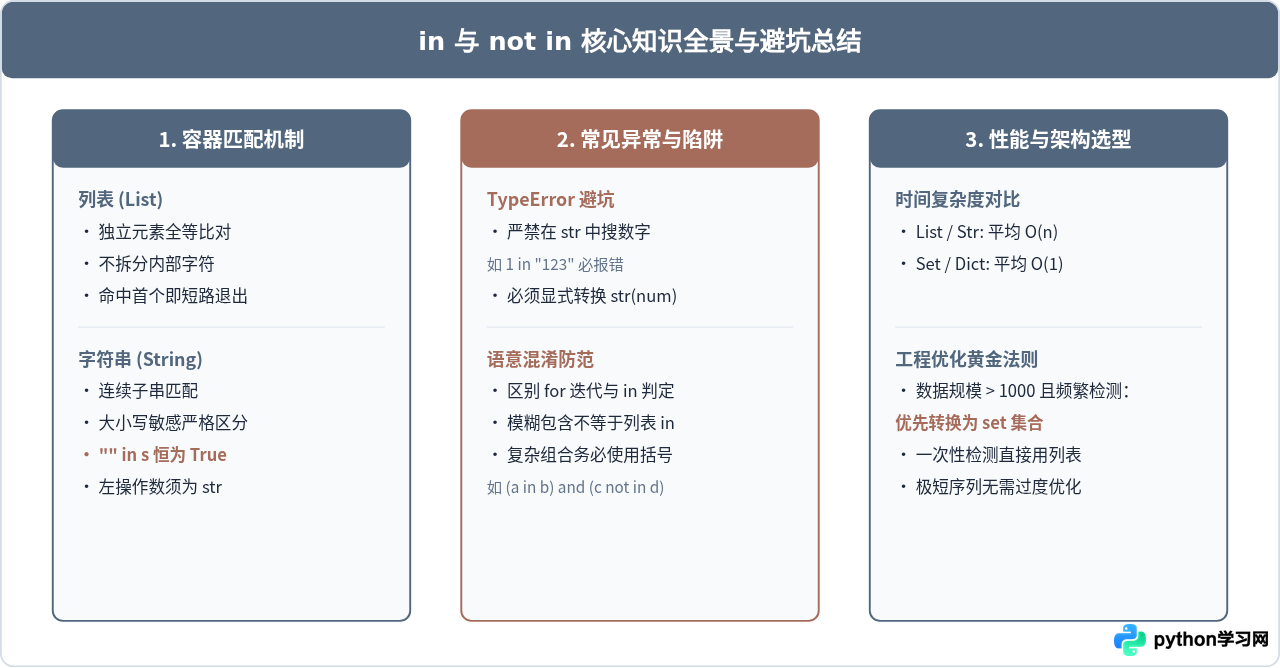
六、全文总结
in 和 not in 是 Python 语言中兼具简洁性与表达力的成员操作符。通过上述分析,我们可以建立起清晰的决策心智模型:
- 看容器类型:遇到列表,它是一对一的“离散元素比对”;遇到字符串,它是一整段的“连续子串扫描”。
- 看操作数类型:列表包容各种数据类型,但字符串的左操作数只能是
str。 - 看数据量级:小规模数据放心使用,百万级大规模或循环内部的高频查询,果断转用哈希结构的
set。
掌握这些底层机制与行为边界,可以让我们在日常编码时写出既 Pythonic、又高效稳健的条件控制代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









