

除了列表、元组和字符串,Python还有哪些序列类型
深入解析Python中除列表、元组和字符串之外的序列类型,包括range、bytes、bytearray、memoryview及array.array的底层机制、内存特点与选型场景。
日常编写 Python 代码时,提到序列类型,大家最先想到的一定是列表(list)、元组(tuple)和字符串(str)。但在 Python 标准库与底层运行时中,序列家族远比这三者丰富得多:用于不可变等差数值序列的 range、专为二进制流设计的 bytes 与 bytearray、实现零拷贝缓冲操作的 memoryview,以及面向紧凑同质数值存储的 array.array。这些类型各自针对特化场景进行了极致的内存与性能优化,搞清楚它们的边界与特性,是写出地道、高性能 Python 代码的必经之路。
一、序列的核心定义:扁平序列与容器序列
在深入具体类型之前,需要明确 Python 中“序列”(Sequence)的数学与对象模型。凡是支持通过整数索引访问(__getitem__)、具备确定长度(__len__)且支持切片、迭代与包含性测试(in)的数据结构,都属于广义的序列范畴。
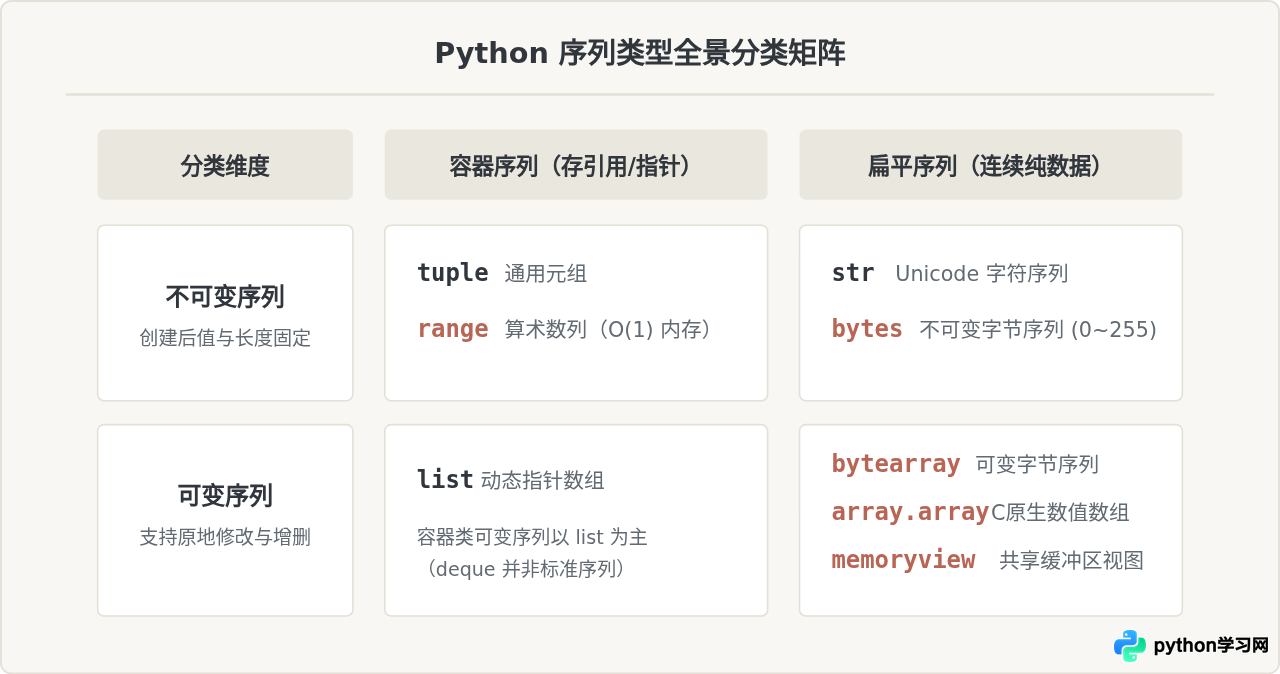
从物理内存存储结构来划分,Python 的序列类型主要分为两大阵营:
- 容器序列(Container Sequences):如
list与tuple。它们存储的并非对象本身的数据,而是对各个 Python 对象的引用指针。容器序列可以存放异构对象,甚至能够嵌套自身,但指针寻址带来了额外的内存消耗与间接访问开销。 - 扁平序列(Flat Sequences):如
str、bytes、bytearray和array.array。它们在连续的物理内存空间中直接存储紧凑的原始值(例如字符编码、C 基础数据类型的字节),无法存放异构对象,但内存密度极高、CPU 缓存友好且访问速度飞快。
二、不可变算术序列:被严重低估的 range
很多人习惯把 range 视作“用于 for 循环的计数器”,甚至误以为它是一个生成器(generator)。实际上,range 在 Python 3 中是一个名副其实的不可变序列类型。
作为标准序列,range 具备以下序列全部特征:
- 常数级时间复杂度的成员判断:当执行
x in range(0, 1000000000, 2)时,Python 绝不会从头到尾进行遍历,而是通过简单的数学算术运算(x - start) % step == 0在 $O(1)$ 时间内完成判断。 - 完整的索引与切片支持:不仅可以
r[5]快速取值,甚至可以对 range 进行切片:range(0, 100, 2)[5:15:2],返回的依然是一个新的range实例。 - 恒定不变的内存消耗:无论定义的是
range(10)还是range(10**18),它在内存中都只保存start、stop、step三个整数属性,占用固定的 48 字节左右内存。
# range 序列的算术特性示例
r = range(10, 100, 5)

# 1. 序列索引与切片
print(r[2])          # 示例输出: 20
print(r[-1])         # 示例输出: 95
sub_r = r[2:8:2]
print(sub_r)         # 示例输出: range(20, 50, 10)

# 2. O(1) 效率的数学包含判断
print(45 in r)       # 示例输出: True
print(46 in r)       # 示例输出: False
三、二进制基础序列:bytes 与 bytearray
在涉及网络套接字(Socket)、磁盘二进制文件读写、加密散列计算或硬件外设通信时,文本字符串(Unicode)无法直接处理原始电信号字节,此时的核心就是二进制序列。
1. 不可变二进制序列:bytes
bytes 是只读的 8 位无符号整数序列(每个元素数值都在 0 到 255 之间)。字面量通常以 b"..." 形式表示。虽然通过切片或迭代访问单个元素时,会得到具体的十进制整数,但它支持类似于字符串的 .startswith()、.split() 等丰富方法。
2. 可变二进制序列:bytearray
bytearray 则是 bytes 的可变孪生版本。与列表类似,bytearray 支持原地修改特定下标的字节、追加数据、弹出元素或切片批量替换。
如果使用不可变的
bytes 拼接网络包分片,每一次 data += chunk 都会在内存中重新申请一块更大的空间,并将旧数据完整拷贝过去,导致严重的性能损耗与内存碎片。而 bytearray 可以在预分配的连续内存中执行就地追加(extend 或切片赋值),性能高出一个数量级。
# bytes 与 bytearray 操作示例
# 创建不可变 bytes
fixed_header = b"\xaa\x55\x01\x00"

# 创建可变 bytearray 并进行原地装配
buffer = bytearray(fixed_header)
buffer.append(0xFF)          # 追加单字节
buffer.extend([0x01, 0x02])  # 追加多个字节
buffer[2] = 0x09             # 原地替换命令字: 从 0x01 改为 0x09

print(buffer)                # 示例输出: bytearray(b'\xaaU\t\x00\xff\x01\x02')
四、高性能利器:array.array 与 memoryview
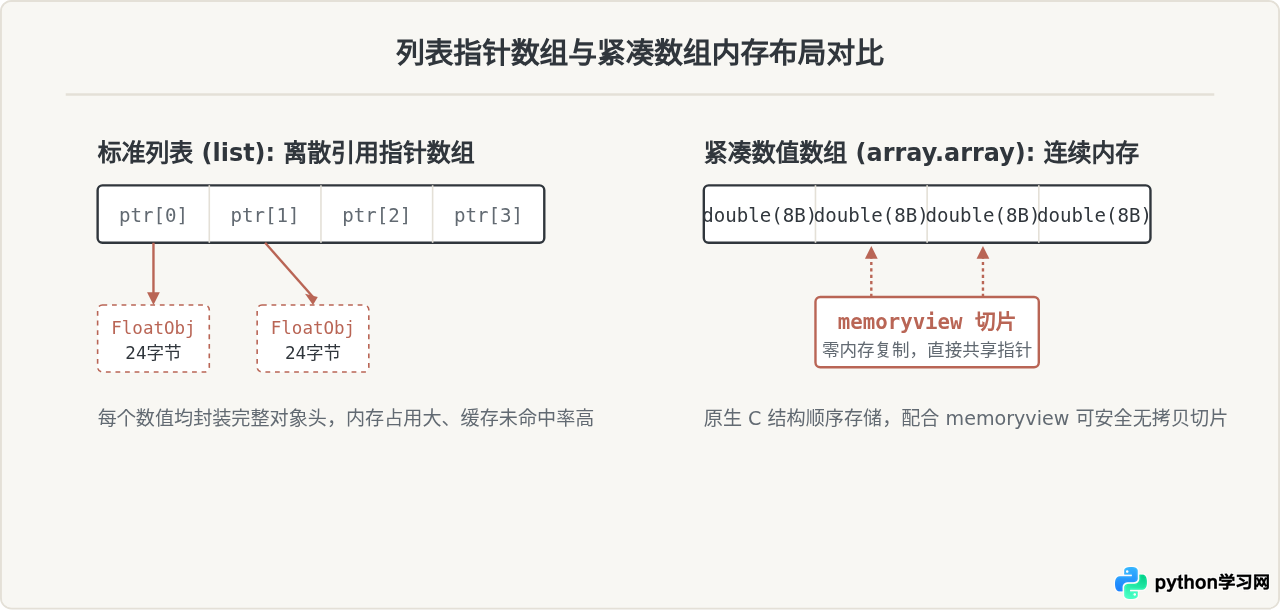
当处理海量结构相同的同质数值时,标准的 list 会带来极其严重的内存膨胀问题。因为列表里的每个元素都是一个完整的 Python 浮点数或整数对象,附带类型指针和引用计数头部。为此,Python 标准库提供了更为底层的内存级序列。
1. 紧凑同质数值数组:array.array
array.array 直接将 C 语言原生数据类型存放在连续内存中。创建时必须指定类型码(typecode),例如 'd' 代表双精度浮点数(8 字节),'i' 代表带符号整数(4 字节)。
以存放 1000 万个浮点数为例:用 list 存储大约需要 80MB 内存;而用 array('d') 只需要 80MB 的十分之一不到,且在与 C/C++ 动态链接库或文件 I/O 交互时,可以直接通过二进制流快速载入与保存(fromfile/tofile)。
2. 零拷贝缓冲视图:memoryview
memoryview 是 Python 缓冲区协议(Buffer Protocol)的核心实现。它允许你在不复制内存的情况下,对其他支持缓冲协议的对象(如 bytes、bytearray、array.array)进行切片与共享访问。
如果对一个 100MB 的 bytes 对象做标准切片 b[1000:2000],Python 会开辟新内存并复制这 1000 个字节;但如果是 memoryview(b)[1000:2000],返回的仅是一个轻量级视图指针,内存消耗为零。修改可变缓冲区(如 bytearray)的 memoryview 切片,会直接体现在原对象上。
# array.array 与 memoryview 协同示例
import array

# 创建包含 5 个 32位有符号整数('i')的数组
numbers = array.array('i', [10, 20, 30, 40, 50])

# 创建该数组的内存视图
view = memoryview(numbers)
print(view[1:4].tolist())  # 示例输出: [20, 30, 40]

# 零拷贝类型转换: 将 4 字节整数视图转为单字节展示
byte_view = view.cast('B')
print(len(byte_view))      # 示例输出: 20 (5个int 各占4字节)
五、反例辨析:为什么 deque 不是标准序列?
在讨论序列时,很多开发者容易把 collections.deque(双端队列)也当成序列类型。必须明确:在 Python 抽象定义中,deque 并不属于序列(Sequence)。
我们可以通过标准库的抽象基类进行严格验证:
from collections import deque
from collections.abc import Sequence, MutableSequence

d = deque([1, 2, 3])
print(isinstance(d, Sequence))         # 输出: False
print(isinstance(d, MutableSequence))  # 输出: False
其核心原因在于底层设计定位与时间复杂度保证:
Sequence的设计哲学要求随机索引访问(s[i])保持极高的效率(通常为 $O(1)$),且必须支持切片操作(s[start:stop])。deque是为了在序列两端提供极高吞吐的 $O(1)$ 入队和出队(append/popleft)而设计的双向链表(块状节点)。如果在deque中间随机访问d[n],时间复杂度会劣化为 $O(n)$,而且deque甚至直接禁用了切片语法(执行d[1:2]会直接抛出TypeError)。
六、序列类型选型决策与实践路径
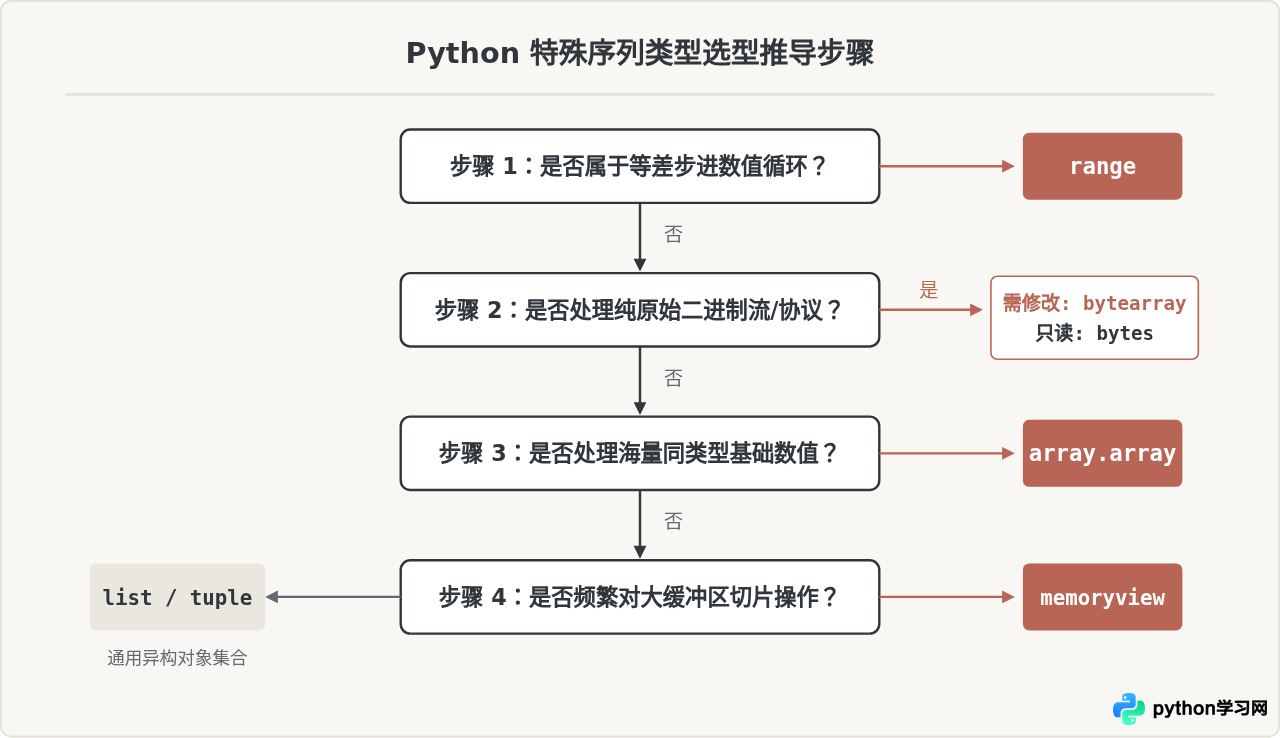
面对具体业务场景时,如何在这几种特殊序列中做出最佳抉择?以下决策流程能够帮助你在性能与灵活性之间找到最优解。
七、总结与特性对照
除了最为常见的 list、tuple 和 str 之外,Python 在标准库层面针对紧凑性、修改成本与内存传输效率给出了完整的序列生态。了解它们的特性,能够帮助你在应对特殊性能瓶颈时游刃有余。
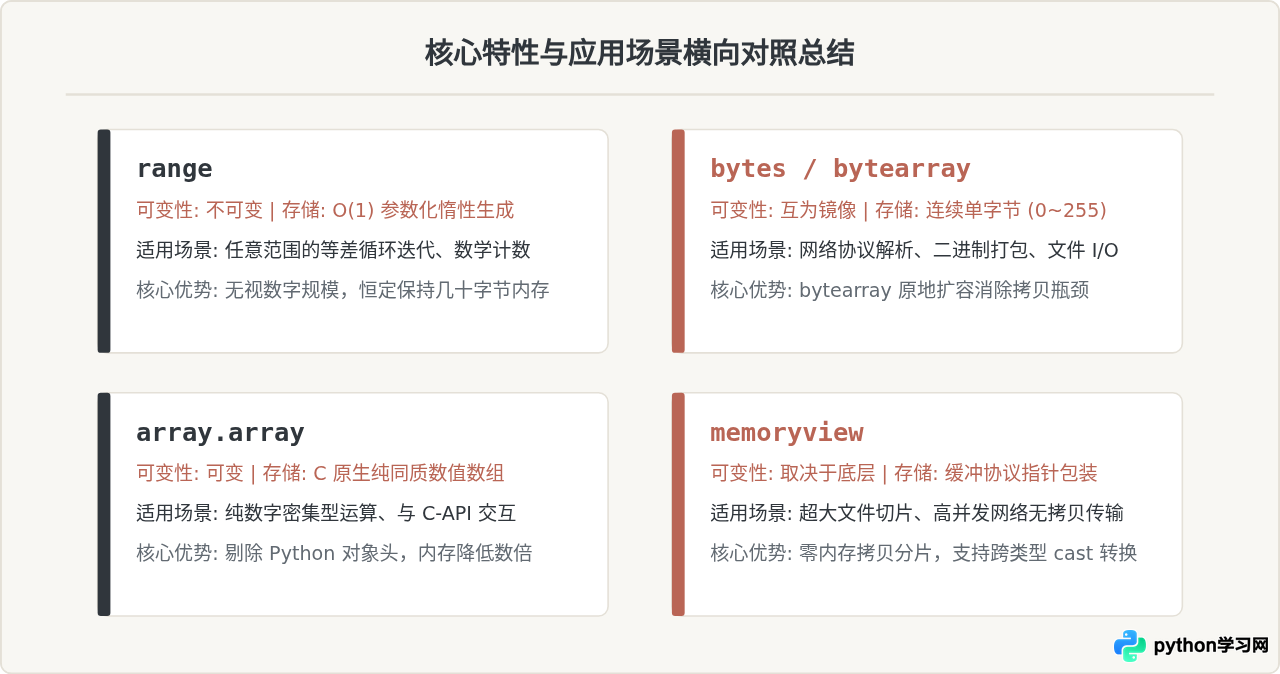
| 序列类型 | 可变性 | 内容类型 | 底层存储机制 | 主要应用场景 |
|---|---|---|---|---|
range |
不可变 | 等差整数 | 保存起始、终止与步长参数($O(1)$ 内存) | 数字计数循环、高效大范围数字判断 |
bytes |
不可变 | 单字节(0~255) | 连续单字节定长物理内存 | 静态二进制数据、散列摘要、固定网络包头 |
bytearray |
可变 | 单字节(0~255) | 连续单字节动态可扩容物理内存 | 动态装配协议包、二进制就地加解密与替换 |
array.array |
可变 | 同质 C 原生数值 | 严格连续的 C 基本类型物理数组 | 纯数值存储、文件二进制 dump、紧凑矩阵 |
memoryview |
由底层决定 | 缓冲协议数据 | 底层连续内存的指针与步幅元数据封装 | 超大数据切片与零拷贝 I/O 传输 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









