

怎么用Python切片步长实现隔项取值和数据采样
深入讲解如何利用Python切片的第三参数步长(step)实现序列隔项提取、奇偶位置分离、倒序抽取以及离散高频数据采样,包含底层内存机制与选型对比。
在 Python 中对列表、元组或字符串进行隔项提取或均匀降采样,最直接高效的方式是使用切片的扩展形式 sequence[start:stop:step]。其中的第三个参数 step(步长)决定了索引游标每次前进的跨度。当 step 设为大于 1 的正整数时,Python 会自动跳过中间元素实现跨项抽取;当 step 设为负数时,则实现从右至左的逆向采样。本文将从切片步长的底层机制切入,详细梳理隔项提取的具体写法、常见业务场景下的数据采样实践以及规避边界陷阱的方法。
一、切片三参数与步长的工作原理
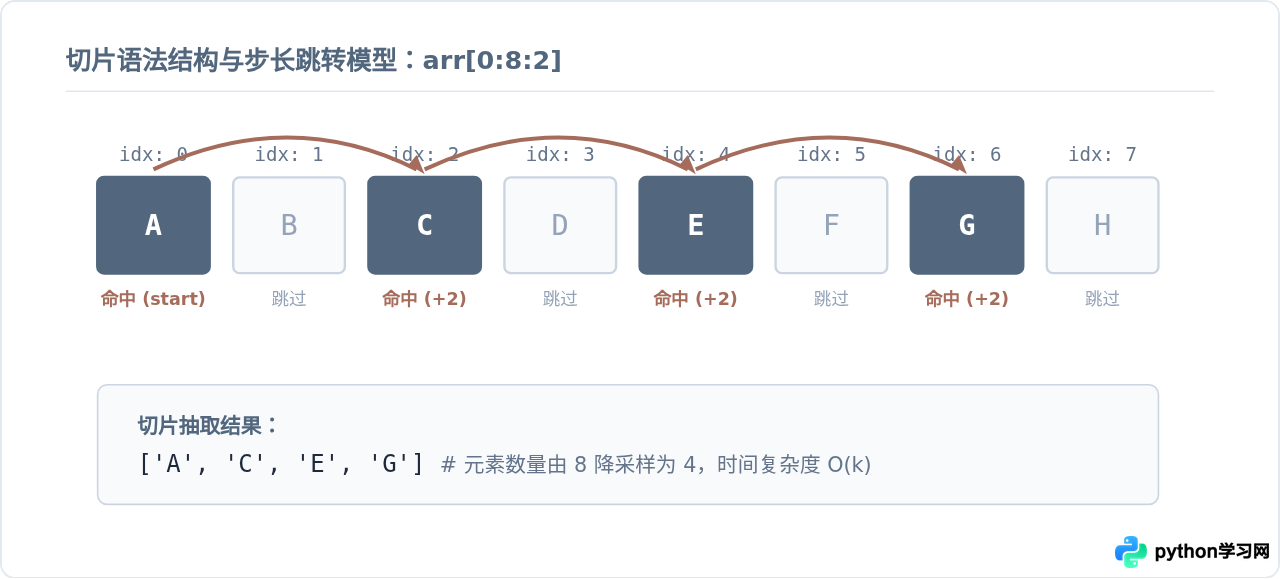
很多初学者熟悉基础切片 sequence[start:stop],默认省略的第三个参数正是步长 step,其缺省值为 1。切片的完整表达式是:
sliced_result = sequence[start:stop:step]步长的核心作用在于定义索引在区间内的移动步幅和前进方向:
- 游标迭代公式:若从起始位置
start开始,下一个被提取的元素索引并不是简单的i + 1,而是i + step。 - 区间判断:当
step > 0时,索引从左向右累加,且满足index < stop;当step < 0时,索引从右向左递减,且满足index > stop。 - 省略与缺省规则:若省略
start与stop(即写作sequence[::step]),当step > 0时,默认起点为序列首端(索引 0),终点延伸至序列末端;当step < 0时,默认起点为序列末端(索引 -1),终点延伸至最左端之前。
二、典型隔项取值场景与代码实现
在实际编码中,隔项取值往往用于分离奇偶项、按周期提取指标或者倒序遍历。以下展示四种最典型的应用方式。
1. 提取偶数索引与奇数索引项
这是最基础的隔项取值需求。例如处理交错排列的数据包(如键值交替出现的文本、RGB 与 Alpha 混合通道):
items = ["0-key", "0-val", "1-key", "1-val", "2-key", "2-val"]

# 提取偶数索引项(索引 0, 2, 4)
keys = items[0::2]   # 简写为 items[::2]
# 输出: ['0-key', '1-key', '2-key']

# 提取奇数索引项(索引 1, 3, 5)
values = items[1::2]
# 输出: ['0-val', '1-val', '2-val']
2. 固定步长周期采样
当步长设定为任意正整数 N 时,即可实现“每隔 N-1 个元素取一个”。例如以固定步长提取周期性测量值:
sequence = list(range(20))  # [0, 1, 2, ..., 19]

# 每 5 个元素取第 1 个(步长为 5)
sampled_5 = sequence[::5]
# 结果: [0, 5, 10, 15]

# 从索引 2 开始,每 4 个元素提取一个
offset_sampled = sequence[2::4]
# 结果: [2, 6, 10, 14, 18]
3. 负步长倒序隔项取值
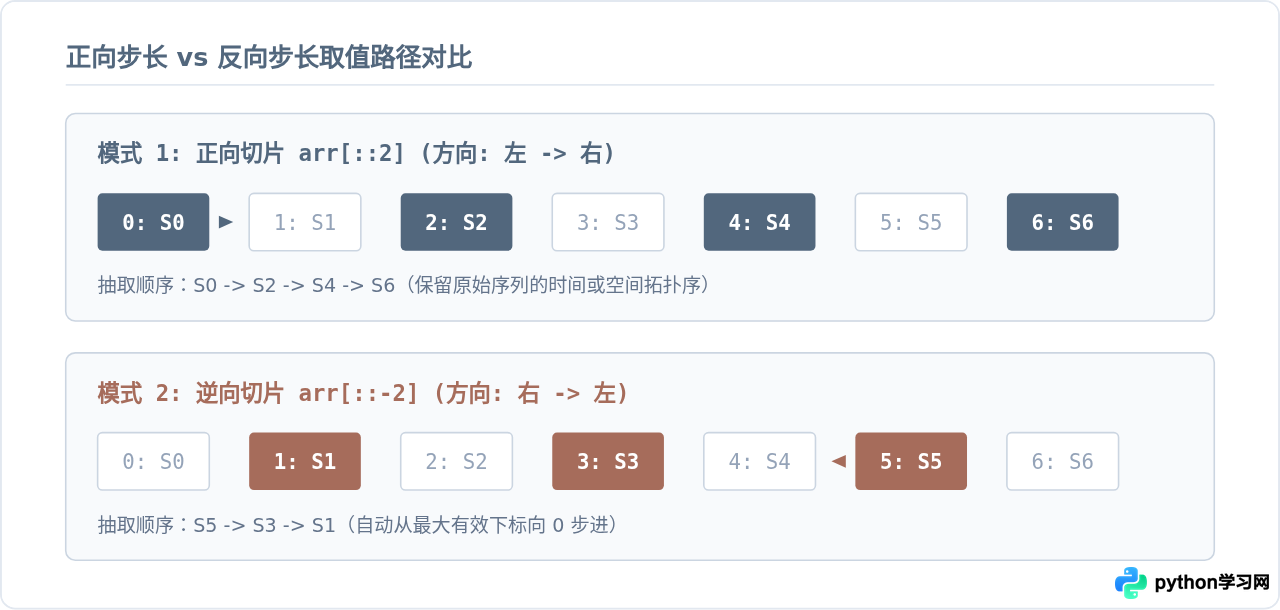
当 step 为负数时,切片游标将从高位索引向低位索引移动。最著名的反转序列操作 sequence[::-1] 就是步长为 -1 的特例。若使用 step = -2,则实现倒序且隔项抽取:
letters = ["A", "B", "C", "D", "E", "F"]

# 完全反转
reversed_all = letters[::-1]
# 结果: ['F', 'E', 'D', 'C', 'B', 'A']

# 倒序隔项采样(索引依次为 5, 3, 1)
reversed_even_jump = letters[::-2]
# 结果: ['F', 'D', 'B']

# 指定区间倒序:从索引 4 倒序取到索引 1(不含 1),步长为 -2
bounded_reverse = letters[4:1:-2]
# 结果: ['E', 'C']使用负步长时,必须满足 start > stop 才能取到非空结果。例如写成 letters[1:4:-1] 会直接返回空列表 [],因为索引 1 向左无法到达索引 4。
三、面向实际数据采样的工程实践
切片步长不仅仅是语法糖,更是一种极其实用的等间隔抽样(Decimation / Downsampling)工具。在处理高频日志、传感器点位、音频信号或图像数据时,合理运用切片能够成倍压缩数据量。
1. 时间序列高频数据降频采样
假设某 IoT 传感器以 100 Hz(每秒 100 条)采集温度数据,而前端可视化大屏仅需 10 Hz 的刷新率。直接对原始数组执行步长为 10 的切片即可完成下采样:
# 模拟 10 秒钟采集的 1000 个温度数据点
raw_temperatures = [20.0 + (i * 0.01) % 5 for i in range(1000)]

# 将 100Hz 降采样至 10Hz:每 10 个数据点保留 1 个
downsampled_data = raw_temperatures[::10]

print("原始样本数:", len(raw_temperatures))  # 1000
print("采样后样本数:", len(downsampled_data))  # 100
2. 内存机制深度解析:Python 原生 List 与 NumPy 数组
在工程实现中必须特别注意两种数据结构的内存表现:
- Python 原生列表(List):执行
list[::step]时,Python 底层会分配一块全新的内存,创建一个新的PyListObject并将元素指针复制过去。虽然元素对象本身没有深拷贝,但切片产生的列表容器是一个新对象。如果原始列表占用数个 GB,新列表同样会占用相应的内存。 - NumPy 多维数组(ndarray):NumPy 的切片操作不会复制底层数据,而是创建原数组的一个“视图(View)”。NumPy 内部通过调整数组元数据中的
strides(跨度字节数)直接映射原始数据块,时间复杂度为O(1),内存几乎零增加。
import numpy as np

# 创建 100 万个浮点数
np_arr = np.linspace(0, 100, 1_000_000)

# NumPy 步长采样创建的是 View,不发生数据复制
view_sampled = np_arr[::100]

# 验证是否共享内存基地址
print("是否为视图共享内存:", view_sampled.base is np_arr)  # True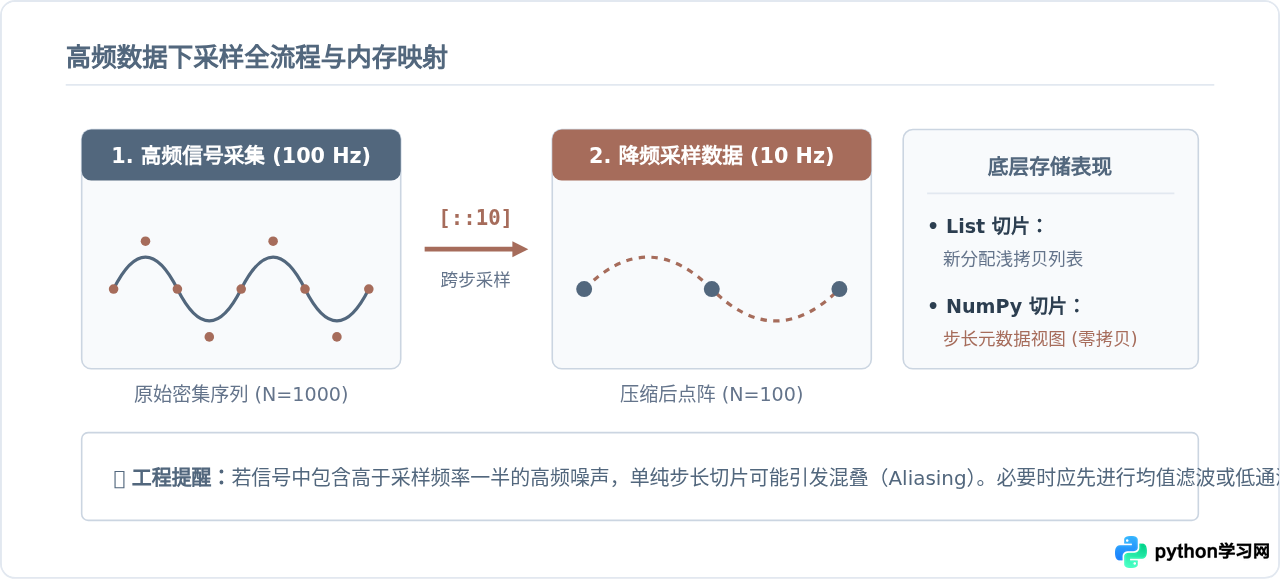
四、边界问题与替代方案选型
虽然切片操作非常直观,但在特定边界条件和工程场景下,开发者容易遇到异常抛出或性能瓶颈。
1. 步长为 0 导致报错
在 Python 切片中,步长绝对不能为 0。若由于动态计算导致步长为 0,程序会直接抛出 ValueError:
arr = [1, 2, 3]
try:
    result = arr[::0]
except ValueError as e:
    print("捕获错误:", e)  # slice step cannot be zero
在动态计算步长(如 step = total_len // target_samples)时,务必加上防御逻辑,确保 step = max(1, step)。
2. 超大序列或数据流的流式采样:itertools.islice
如果数据来源于数千万行的文件、生成器(Generator)或者无法一次性载入内存的流式管道,切片语法就无法直接使用了,因为生成器对象不支持直接索引切片。此时应当使用标准库 itertools.islice:
from itertools import islice

# 模拟不可直接切片的无限生成器或文件行迭代器
def data_stream():
    n = 0
    while True:
        yield n
        n += 1

# 使用 islice(iterable, start, stop, step) 惰性采样前 1000 项中的每隔 100 项
stream_sampled = list(islice(data_stream(), 0, 1000, 100))
print("流式采样结果:", stream_sampled)  # [0, 100, 200, 300, 400, 500, 600, 700, 800, 900]
itertools.islice 是完全惰性求值的,只会在迭代时消耗必要的生成步骤,不会在内存中提前展开完整序列。
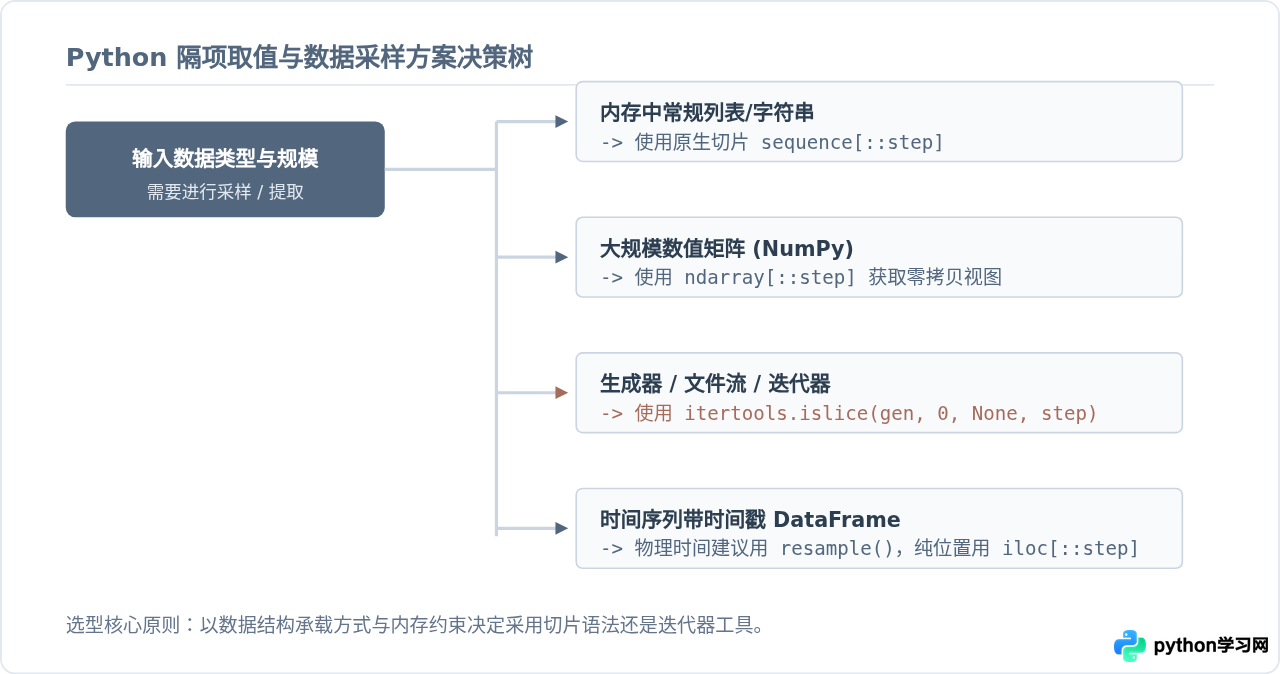
五、实用总结与速查清单
掌握切片步长能够大幅提升 Python 处理序列数据的精炼度。以下是将关键用法提炼后的速查清单:
- 偶数项提取:
sequence[::2](等价于sequence[0::2],从第 0 个开始跨 2 步)。 - 奇数项提取:
sequence[1::2](从第 1 个开始跨 2 步)。 - 序列整体反转:
sequence[::-1]。 - 反向隔项提取:
sequence[::-2]。 - N倍降采样:
sequence[::N]。 - 安全约束:动态计算步长时必须避开
0;负步长时区间起点必须大于终点;生成器采样使用itertools.islice。
无论是在处理日常字符串文本、清洗结构化列表,还是在科学计算与传感器数据流中执行降采样,切片步长都是既轻量又高效的解决方案。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









