

Python网络请求怎么做?requests库常用函数详解

在 Python 中发起网络请求,最常用且成熟的方式是使用第三方库 requests。该库将底层复杂的网络协议操作高度封装,提供了直观的面向对象 API。完成一次标准的网络请求,只需安装模块、调用对应的 HTTP 动词函数(如 get() 或 post())并处理返回的响应对象。本文将详细拆解 requests 库的安装配置、核心请求函数、参数传递方式、响应数据解析以及生产环境中必不可少的超时与会话管理实践。
一、准备工作与第一个 GET 请求
Python 原生自带了 urllib 模块,但其 API 较为繁琐且需要手动处理编码、连接池和重定向。requests 库则是事实上的行业标准。在使用前,需要通过 pip 工具完成安装:
pip install requests安装完成后,通过调用 requests.get() 即可发起一个基础的 HTTP GET 请求:
import requests

url = "https://httpbin.org/get"
response = requests.get(url)

# 打印执行结果(示例输出)
print("HTTP状态码:", response.status_code)
print("响应内容类型:", response.headers.get("Content-Type"))
输出示例:
HTTP状态码: 200
响应内容类型: application/json在上述代码中,requests.get(url) 会向目标服务器发送 GET 请求,并同步等待服务器响应,最终返回一个 Response 对象。随后对状态码和响应内容的检查,都是基于该对象展开的。
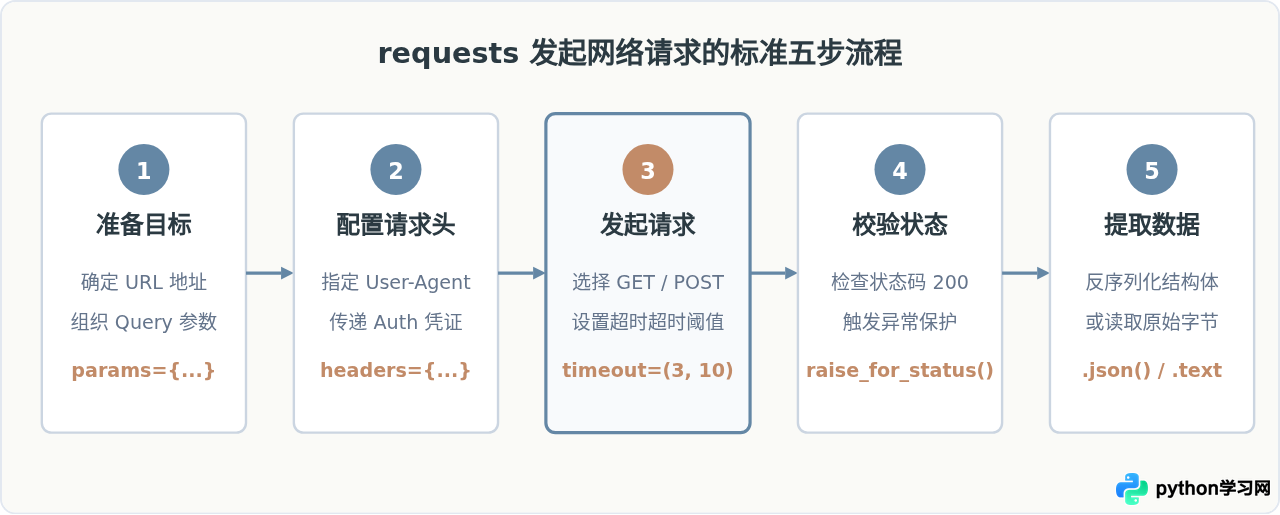
二、核心请求函数与参数传递详解
HTTP 协议定义了多种请求方法,requests 库为每种方法都提供了同名的顶级快捷函数,底层均由 requests.request() 进行统一分发。
1. requests.get():获取数据与查询参数
GET 请求通常用于从服务端获取数据。当需要向 URL 附加查询参数(如分页、搜索关键词)时,不需要手动拼接字符串,而是通过 params 参数传入字典,requests 会自动进行 URL 编码与拼接:
query_params = {
    "keyword": "python",
    "page": 1,
    "sort": "desc"
}

response = requests.get("https://httpbin.org/get", params=query_params)
# 实际请求的 URL 为:https://httpbin.org/get?keyword=python&page=1&sort=desc
print("完整请求URL:", response.url)
2. requests.post():提交数据、表单与 JSON
POST 请求用于向服务端提交数据。在实际开发中,需要根据服务端接口要求的 Content-Type 正确选择传参字段:
- 使用
data参数(表单提交):当服务端接收application/x-www-form-urlencoded时使用,传入常规字典。 - 使用
json参数(JSON 提交):现代 RESTful API 普遍接收application/json。传入字典后,requests 会自动调用json.dumps()并在请求头中添加Content-Type: application/json。
# 场景 A:提交标准表单
form_payload = {"username": "alice", "action": "login"}
res_form = requests.post("https://httpbin.org/post", data=form_payload)

# 场景 B:提交 JSON 数据(推荐做法)
json_payload = {"user_id": 1001, "tags": ["python", "api"]}
res_json = requests.post("https://httpbin.org/post", json=json_payload)
避坑提示: 切勿将字典手动转为 JSON 字符串后传给 data(例如 data=json.dumps(payload)),除非显式在 headers 中指定 Content-Type: application/json。直接使用 json=payload 是最规范且不易出错的做法。
3. 其他请求方法:put() 与 delete()
在符合 RESTful 规范的系统中,资源的修改与删除分别对应 PUT 与 DELETE 方法:
# 更新资源
res_put = requests.put("https://httpbin.org/put", json={"status": "active"})

# 删除指定资源
res_delete = requests.delete("https://httpbin.org/delete", params={"id": 1001})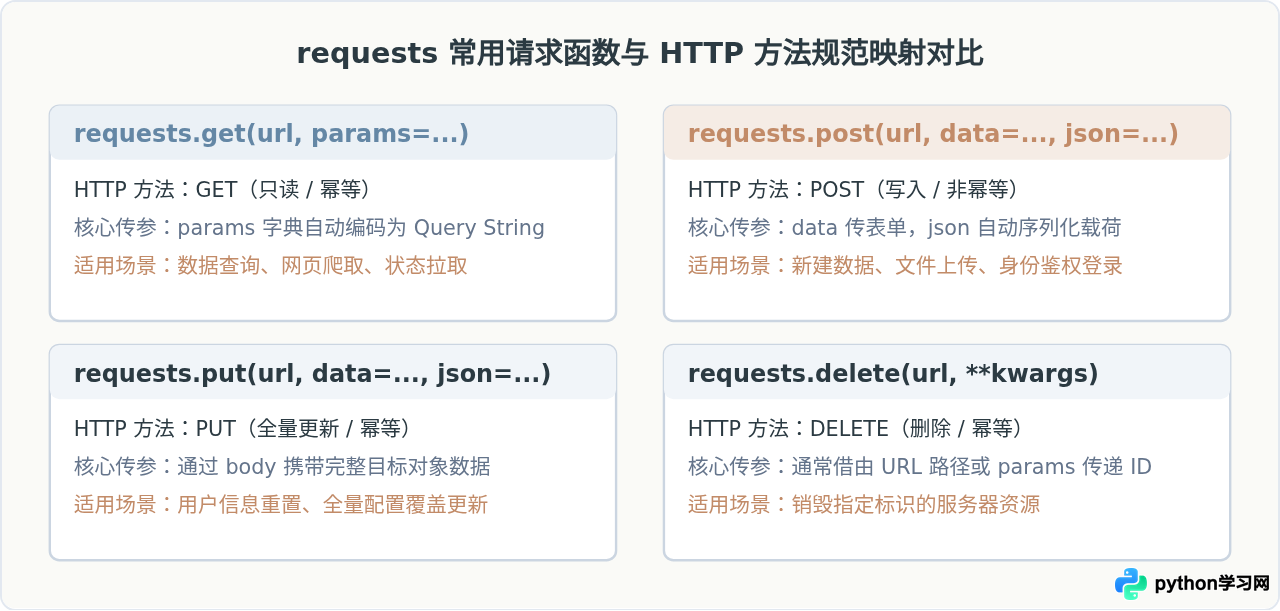
三、Response 响应对象的结构与数据解析
发起请求后,核心逻辑就在于从 Response 对象中准确提取数据。该对象封装了网络层的全部返回结果。
1. 状态判断:status_code 与 raise_for_status()
状态码用于判断请求是否成功(200 系列表示成功,400 系列表示客户端错误,500 系列表示服务端异常)。编写健壮脚本时,推荐使用 raise_for_status():
response = requests.get("https://httpbin.org/status/404")

# 当状态码不是 200~299 时,主动抛出 HTTPError 异常
try:
    response.raise_for_status()
except requests.exceptions.HTTPError as err:
    print("请求失败,捕获到异常:", err)
2. 文本解析:text 与 encoding
response.text 返回解码后的文本字符串。requests 会基于 HTTP 头部猜测字符集,存储在 response.encoding 中。若遇到中文乱码,通常是因为服务端未声明编码或猜测错误,可手动指定:
response = requests.get("https://example.com")
# 若中文出现乱码,采用自动检测的编码重新赋值
response.encoding = response.apparent_encoding
print(response.text[:200])
3. 结构化 JSON 解析:json()
如果响应体是 JSON 格式,直接调用 response.json() 即可得到 Python 原生字典或列表:
response = requests.get("https://httpbin.org/json")
data = response.json()
print("提取标题字段:", data["slideshow"]["title"])
4. 二进制数据流:content
在下载图片、PDF、音视频或二进制文件时,不能使用 response.text,而应使用 response.content,它保存的是未经解码的原始 bytes 数据:
img_res = requests.get("https://httpbin.org/image/png")
if img_res.status_code == 200:
    with open("downloaded_image.png", "wb") as f:
        f.write(img_res.content)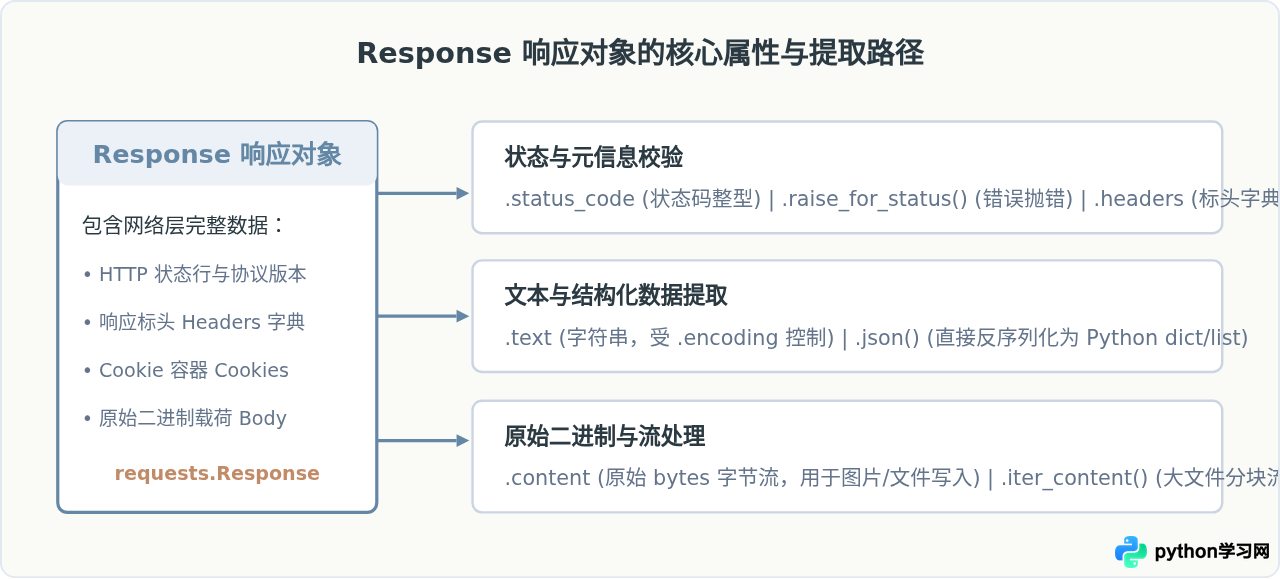
四、生产级网络请求的核心保障与进阶实践
在真实生产环境中,网络波动、服务端无响应或反爬限制不可避免。仅使用基础请求往往难以保障代码的高可用性,必须引入以下四项工程化实践:
1. 强制设置超时参数(timeout)
如果不设置 timeout 参数,requests 默认会永久等待连接与响应。当远程服务器发生故障或卡死时,主线程将无限期挂起。timeout 可以传入一个浮点数(总超时),或者一个元组 (连接超时, 读取超时):
# 推荐设置:连接超时 3 秒,读取响应超时 10 秒
try:
    response = requests.get("https://httpbin.org/delay/2", timeout=(3.05, 10))
except requests.exceptions.Timeout:
    print("请求超时,需进行重试或降级处理")
2. 伪装请求头(headers)
requests 默认的 User-Agent 为 python-requests/x.x.x,绝大多数生产级 Web 服务器会对该标识实施限流或直接返回 403 拦截。模拟标准浏览器请求头是基础操作:
custom_headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept": "application/json, text/plain, */*"
}
response = requests.get("https://httpbin.org/headers", headers=custom_headers)
3. 使用 Session 保持会话与连接池复用
直接调用 requests.get() 会在每次请求时重新建立 TCP 握手与 TLS 协商,且多个请求间无法共享 Cookie。使用 requests.Session() 对象可以自动管理 Cookie 并复用底层的 TCP 连接,大幅提升批量请求性能:
with requests.Session() as session:
    session.headers.update({"User-Agent": "MyCustomClient/1.0"})

    # 步骤一:登录并自动在 session 中保存 Set-Cookie
    session.post("https://httpbin.org/cookies/set", params={"session_token": "abc123xyz"})

    # 步骤二:后续所有请求均会自动携带该 session_token
    res = session.get("https://httpbin.org/cookies")
    print("当前会话Cookie:", res.json())
4. 完善的分层异常处理
所有 requests 抛出的异常都继承自 requests.exceptions.RequestException。针对网络层、协议层和超时细化捕获,可以构建防御性极强的调用结构:
import requests
from requests.exceptions import ConnectionError, Timeout, HTTPError, RequestException

def fetch_data(url):
    try:
        response = requests.get(url, timeout=(3, 5))
        response.raise_for_status()
        return response.json()
    except Timeout:
        print("[错误] 网络连接或数据读取超时")
    except ConnectionError:
        print("[错误] 网络解析错误或远程主机拒绝连接")
    except HTTPError as e:
        print(f"[错误] HTTP 状态码异常: {e.response.status_code}")
    except RequestException as e:
        print(f"[错误] 请求库未知异常: {e}")
    return None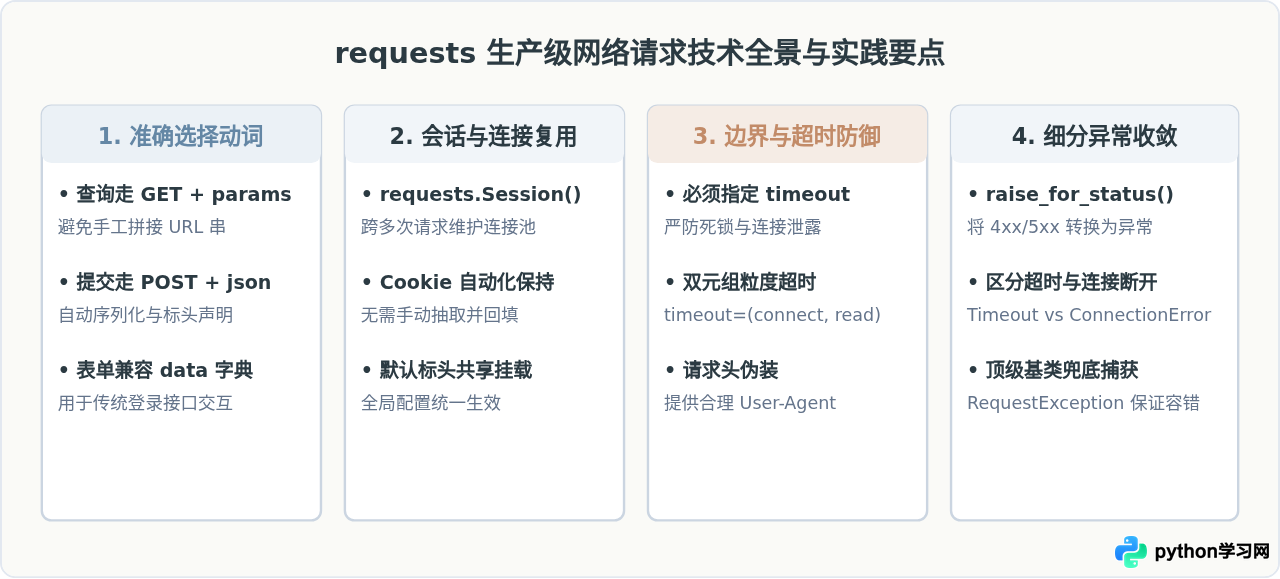
五、常见问题排查清单
| 故障现象 | 根本原因 | 标准解决方法 |
|---|---|---|
中文显示乱码(例如出现 å—符) |
HTTP 头部缺少 charset 声明,requests 自动根据规范回退到 ISO-8859-1 解码。 | 在访问 response.text 前执行 response.encoding = response.apparent_encoding。 |
| POST 请求服务端返回 400 或报错“缺少参数” | 混淆了 data 与 json。对方接口期望 JSON,而客户端发送了表单编码。 |
将 requests.post(url, data=payload) 改为 requests.post(url, json=payload)。 |
| 程序偶发卡死无任何响应或日志 | 未显式设置超时时间,底层套接字无限期等待远端 ACK 或响应体。 | 为所有请求显式添加参数:timeout=(3.05, 15)。 |
HTTPS 请求抛出 SSLError |
目标站点的 SSL 证书过期、自签名或本地系统缺省根证书链。 | 若在内部测试环境,可设置 verify=False 忽略校验(生产环境应配置证书路径)。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









