

Python截取字符串是生成新对象还是修改原字符串
深入解析Python中字符串截取(切片)的底层机制:切片操作是生成全新字符串对象还是修改原字符串?结合代码验证、内存结构图解及性能实践,全面解答字符串不可变性原理。
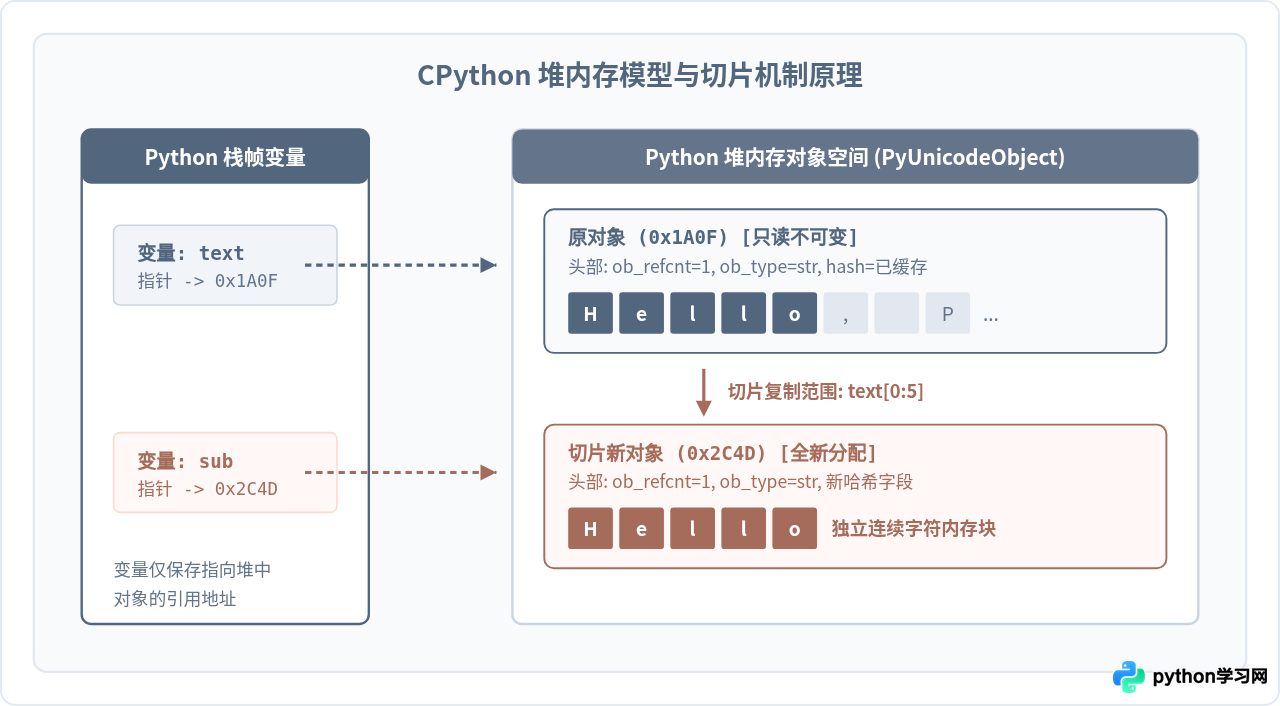
s[start:end])一定会生成全新的字符串对象,绝不会修改原字符串。这一行为由 Python 字符串的“不可变性(Immutability)”从底层机制上严格保证,任何尝试就地修改原字符串的操作都是不被允许的。
许多初学者在使用 Python 处理文本时,往往会产生一个直观的误解:认为变量执行切片之后,原变量的内容会被截短;或者在对同一个变量名重新赋值时,以为原有的字符串在内存中被直接改写了。事实恰恰相反,Python 的字符串属于基础标量类型中的不可变对象,一经创建,其在内存中的字符序列和长度便彻底固定。
一、现象切入:用 id() 验证切片前后的内存地址
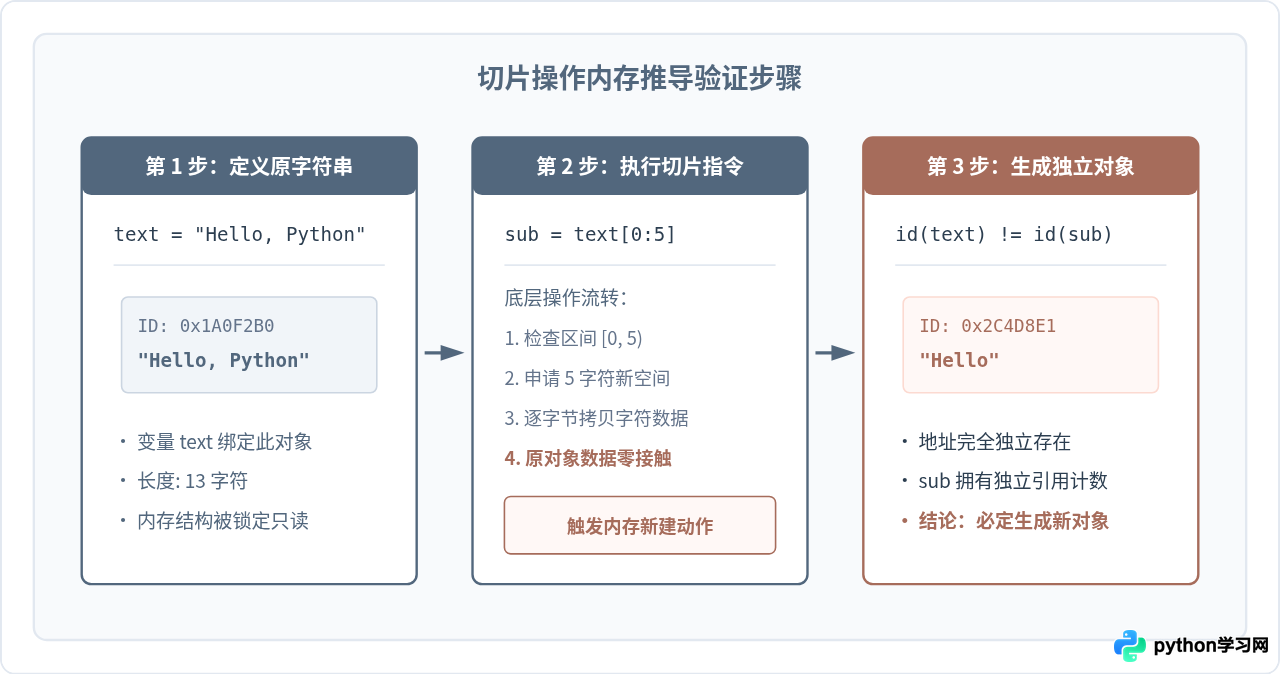
要确凿地确认截取字符串是否生成了新对象,最直接的手段就是观察对象的唯一身份标识符。在 Python 中,内置函数 id() 返回对象在生命周期内的内存地址整数。如果截取操作修改了原对象,两者的地址应当完全一致;若生成了新对象,地址则必定不同。
# 实验代码:观察原字符串与切片结果的地址
text = "Hello, Python"
sub_text = text[0:5]

print("原字符串值:", text, "| 内存地址:", id(text))
print("切片结果值:", sub_text, "| 内存地址:", id(sub_text))
print("是否为同一对象:", text is sub_text)原字符串值: Hello, Python | 内存地址: 4381987568
切片结果值: Hello | 内存地址: 4382093744
是否为同一对象: False
从输出中可以清晰地看到,sub_text 的内存地址与 text 完全不同,is 操作符直接返回 False。同时,原变量 text 依然完整保存着 "Hello, Python",并没有发生任何损耗或修改。
二、深层机理:Python 为何将字符串设计为不可变?
很多语言(例如 C++ 中的 std::string)支持直接修改字符串内部的某个字符。但在 Python 中,如果你尝试直接修改字符:
s = "hello"
s[0] = 'H' # 试图原位修改解释器会明确抛出 TypeError,拒绝元素赋值。Python 将字符串设计为不可变对象,主要是基于以下三个核心架构考量:
- 字典键与集合元素的哈希安全性(Hashability):Python 中的字典(
dict)和集合(set)底层重度依赖哈希表。字典的键必须拥有恒定不变的哈希值。如果字符串可以就地修改,一旦作为键的字符串被篡改,其哈希值改变将导致该键值对在哈希表中彻底无法定位。 - 天然的并发与线程安全:不可变对象无论被多少个线程或函数引用,由于其内部状态绝不可变,读取操作永远无需加锁,从根本上杜绝了数据竞争(Data Race)。
- 内存驻留(Interning)与优化共享:Python 对常用字符串常量开启了驻留机制。因为对象只读,相同字面量的字符串可以安全地复用同一份内存对象,极大节省了系统资源。
三、常见混淆场景与细节辨析
在日常开发中,有几种常见的写法容易让人误以为原字符串发生了改动或切片没有生成新对象:
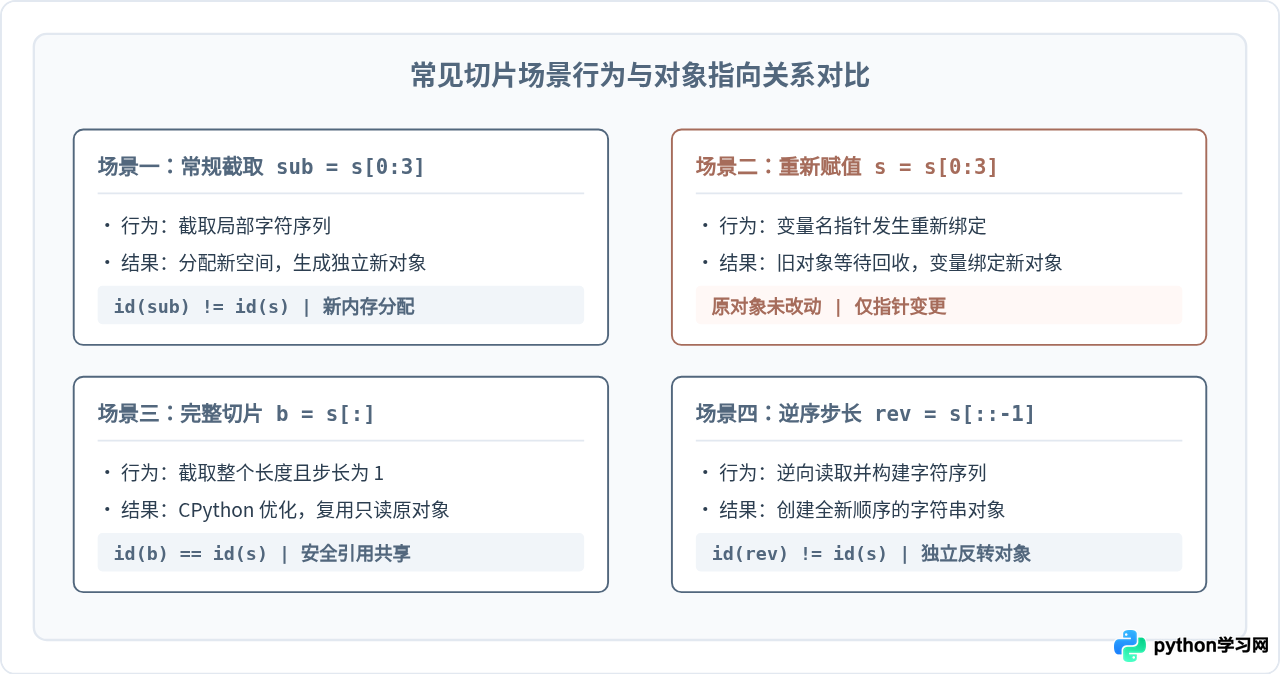
1. 重新赋值:s = s[0:5] 并非“原位修改”
很多开发者在代码中写 s = s[0:5],直觉上认为是“把变量 s 缩短了”。但实际上,这只是引用重新绑定(Rebinding)。右边的 s[0:5] 首先在堆中分配并创建了全新的字符串对象,然后赋值符号 = 让变量名 s 指向了这个新地址。原先长字符串的引用计数减少;若没有其它变量引用它,它会在随后的垃圾回收时被销毁,但在赋值那一刻,它本身绝对没有被就地更改。
2. 全切片 s[:] 与 CPython 的引用复用优化
有时候使用 id() 会测出一个让人意外的现象:
a = "hello_world"
b = a[:]
print(a is b) # 输出: TrueTrue
为什么这里 a is b 为 True?难道没有生成新对象?
这里恰恰是 Python 解释器的一项优雅优化:因为字符串是绝对不可变的,当切片参数完整覆盖原字符串(即切片长度等于原长度且步长为1)时,复制一份完全一样的字符串没有任何实际意义。为了节省内存与时间,CPython 的切片实现会直接将原对象引用返回。这不仅没有修改原字符串,反而是利用不可变性安全共享对象的典范。
四、实际应用中的性能影响与避坑建议
正因为字符串截取必然伴随内存开辟与字符拷贝(时间复杂度为 O(k),k 为截取长度),在实际工程中如果不注意这一点,很容易写出性能低下的代码:
+= 拼接。每次循环不仅生成截取新对象,拼接还会再生成一个新对象,内存反复申请释放会导致计算耗时呈二次方(O(N^2))级数恶化。
工程推荐做法:
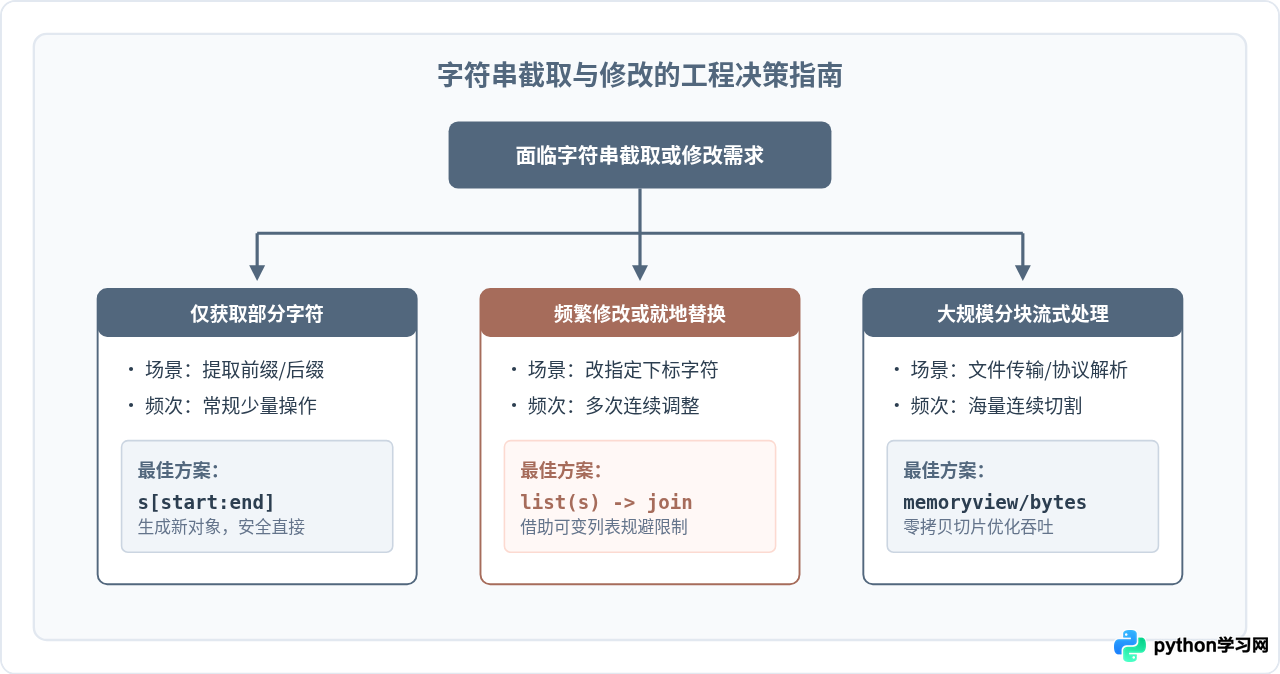
- 批量拼接优先使用列表与 join:在需要频繁裁剪并组装字符串时,先将各个切片收集到
list列表中,最后统一使用"".join(list)。由于列表是可变容器,追加元素的时间复杂度接近 O(1),最终一次性分配内存即可完成合成。 - 单字符修改需求转换为列表:如果业务确实需要“就地修改字符串某些位置的字符”,应先用
char_list = list(s)转成字符列表,修改完成后再拼回字符串。 - 二进制海量数据使用 bytearray 或 memoryview:若处理网络传输或大文件二进制切片,建议使用支持可变修改的
bytearray,或使用零拷贝切片的memoryview,避免重复开辟缓冲区。
五、总结
回到最初的问题:Python截取字符串是生成新对象还是修改原字符串?
答案无比明确——永远是生成新对象,绝不修改原字符串。理解这一点的价值在于:一方面可以消除对“数据在函数传参或切片后被意外修改”的担忧;另一方面,能促使我们在编写性能敏感代码时,清醒认识到每次切片背后的内存分配与数据拷贝成本,从而主动运用列表收集、join 聚合或底层高效缓冲区,写出兼顾安全性与运行效率的高质量 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









