

Python读取JSON文件出现UnicodeDecodeError的原因及修复
详细解析Python在读取JSON文件时触发UnicodeDecodeError的核心机理,提供标准修复方案、排错步骤及字符集检测方法。
在用 Python 读取 JSON 配置文件或数据文件时,UnicodeDecodeError 是最常见的一类运行期异常。这一错误发生的根本原因,在于底层文件对象在将硬盘上的二进制字节流解码为内存字符串时,所采用的字符编码与文件实际存储所用的字符编码不一致。解决这一问题的直接途径是在调用 open() 打开文件时显式指定正确的 encoding 参数,或者在必要时使用专门的字符集检测库识别真实编码。
一、报错场景与典型表现
假设你正在编写一个数据读取脚本,本地有一份名为 config.json 的文件。在 Windows 操作系统中执行以下简易代码时,程序往往会意外中断:
import json

# 常见的不规范读取方式
with open("config.json", "r") as f:
    data = json.load(f)
终端中抛出的完整错误调用栈通常类似如下内容:
Traceback (most recent call last):
  File "main.py", line 4, in <module>
    data = json.load(f)
  File "python3.10/json/__init__.py", line 293, in load
    return loads(fp.read(), ...)
  File "python3.10/codecs.py", line 322, in decode
    (result, consumed) = self._buffer_decode(data, self.errors, final)
UnicodeDecodeError: 'gbk' codec can't decode byte 0x80 in position 24: illegal multibyte sequence
或者在跨平台交换数据时,遇到包含 BOM 头的 UTF-8 文件抛出如下错误:
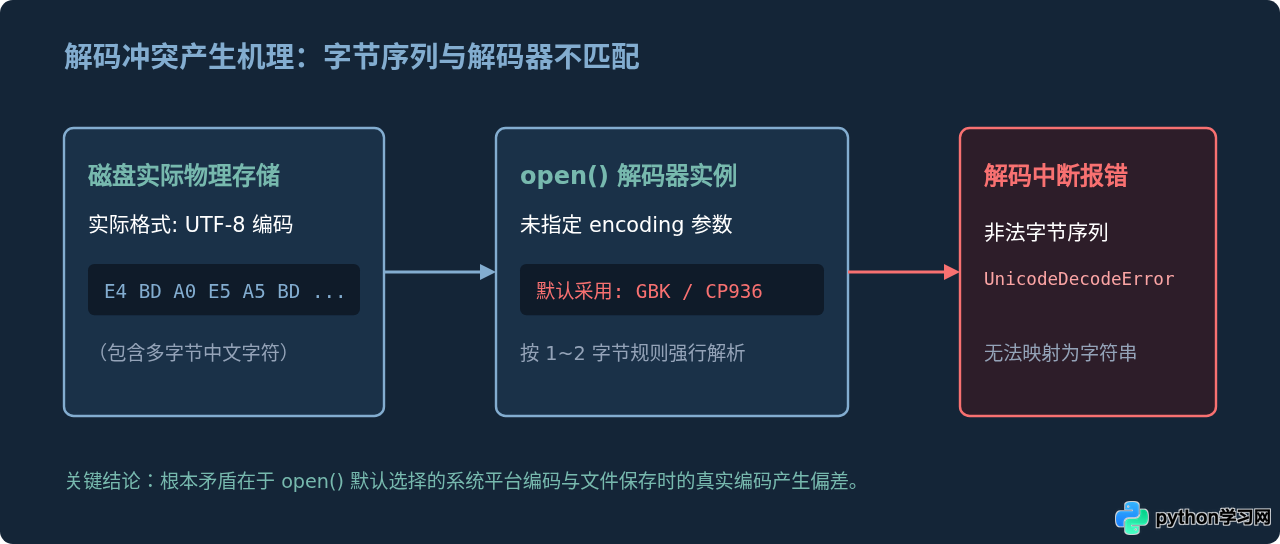
json.decoder.JSONDecodeError: Unexpected UTF-8 BOM (decode using utf-8-sig): line 1 column 1 (char 0)观察错误链可以发现,虽然最终是在调用 json.load() 时触发,但崩溃的源头位于 codecs.py 或底层的文本流读取 fp.read()。json.load() 接收的是一个文本文件流(TextIO),当 json.load() 要求文件对象读取字符串时,文件对象必须实时将字节解码为 Unicode 字符。一旦遇到无法按照当前编码规则映射的字节序列,解码器便会立即抛出 UnicodeDecodeError。
二、深层原因:平台默认值与编码差异
要彻底避免解码异常,需要理解以下三个关键技术细节:
open()函数的默认编码行为:在 Python 中,如果调用open(filename, "r")且没有传encoding参数,解释器将调用操作系统底层的locale.getpreferredencoding(False)获取默认字符集。在 Linux 和 macOS 环境下,该默认值通常是UTF-8;而在中文 Windows 系统上,该默认值通常是cp936(即 GBK 编码)。- JSON 标准规范的演进:根据互联网工程任务组发布的 RFC 8259 规范,在网络协议或软件间交换的 JSON 文本必须使用 UTF-8 进行编码。绝大多数开发工具(如 VS Code、Sublime Text)在创建和保存
.json文件时均默认采用 UTF-8 编码。当 Windows 平台上的 Python 试图用 GBK 解码 UTF-8 文件的中文字符字节时,由于 UTF-8 的 3 字节汉字结构不符合 GBK 的双字节编码范围,就会直接引发UnicodeDecodeError。 - 特殊前缀 BOM 字符:部分 Windows 编辑器(如早期 Windows 自带记事本)在保存 UTF-8 文件时,会在文件开头悄悄写入 3 个字节的“字节顺序标记”(Byte Order Mark,十六进制表示为
EF BB BF)。如果此时用普通utf-8解码,这三个字节会被解析为\ufeff,直接破坏了 JSON 首字符必须为{或[的语法要求,引发解析异常。
三、排查与修复步骤
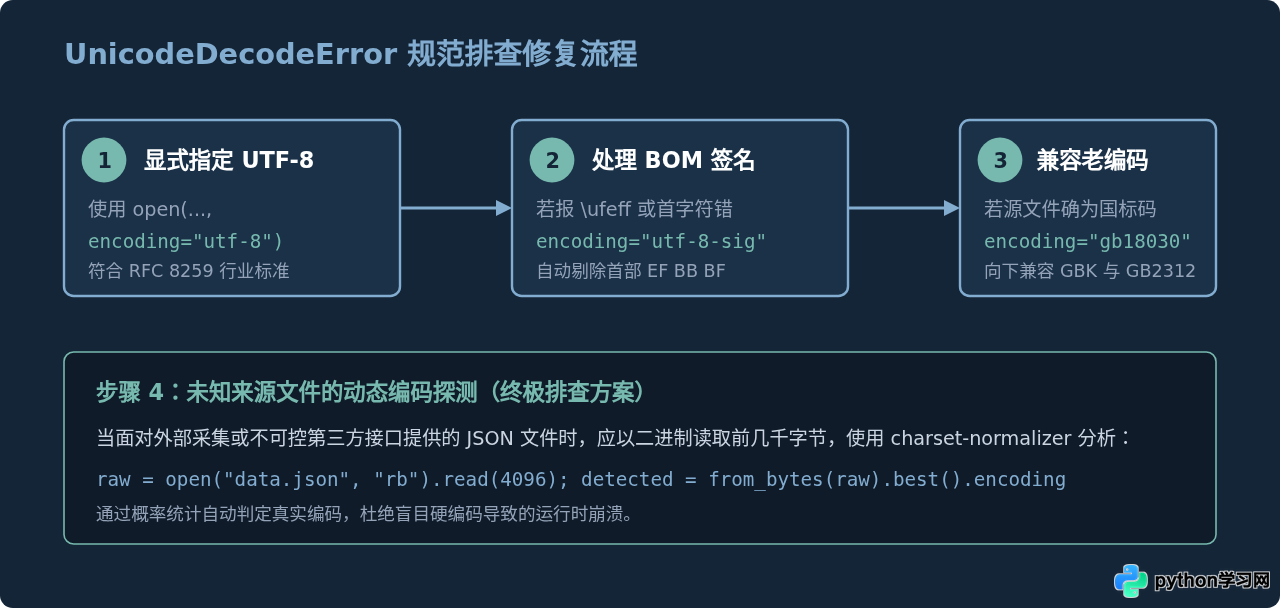
解决此问题遵循“显式声明 UTF-8 → 针对 BOM 调整 → 检测未知字符集”的由浅入深排查链条。请按照以下步骤逐步实施。
步骤 1:显式传入 encoding="utf-8" 参数(最常用修复)
在绝大多数开发实践中,只需在 open() 时加入 encoding="utf-8" 即可解决问题。这是因为绝大多数 JSON 文件本来就是以 UTF-8 编码存储的,仅是 Windows 系统下的默认解码器拖累了读取过程。
import json
from pathlib import Path

file_path = Path("config.json")

# 明确指定编码格式为 UTF-8
with file_path.open("r", encoding="utf-8") as f:
    config = json.load(f)

# 输出读取验证
print("读取成功,配置项数量:", len(config))
步骤 2:使用 utf-8-sig 处理带 BOM 头的文件
如果添加了 encoding="utf-8" 后,程序没有报 UnicodeDecodeError,而是报出 JSONDecodeError: Unexpected UTF-8 BOM,说明文件开头存在三个字节的 BOM 标识符。此时只需将编码类型更改为 utf-8-sig:
import json

# utf-8-sig 会在解码时自动跳过开头的 BOM 标记
with open("config.json", "r", encoding="utf-8-sig") as f:
    data = json.load(f)
utf-8-sig 具有良好的兼容性:即使文件本身没有 BOM 标记,它也会当作普通的 utf-8 处理;而当存在 BOM 时,它会自动剥离该标记,不会把 \ufeff 送入 JSON 解析器中。
步骤 3:针对遗留系统的中文文件选用 gb18030
某些企业内部系统、旧版导出的政企数据库或老旧系统生成的 JSON 文本,可能确实采用了中文国标字符集。如果用 utf-8 报错且文件在 Windows 中用记事本能正常看中文,可以尝试使用 gb18030 编码:
import json

# 相比 gbk,gb18030 是包含更多罕见字和扩展字符的超集
with open("legacy_data.json", "r", encoding="gb18030") as f:
legacy_data = json.load(f)gb18030 代替 gbk。gb18030 是国家强制标准编码,完整包含了 gbk 和 gb2312 的所有字符,并收录了大量中文生僻字和少数民族文字。如果指定 gbk,当文本中出现人名生僻字或特殊符号时依然会报 UnicodeDecodeError。
四、未知编码与第三方文件的动态识别
在批处理爬虫数据、用户上传文件或跨系统数据整合场景中,文件的来源不受控,事先无法得知真实编码。此时硬编码任何一种字符集都存在崩溃隐患。
标准做法是借助 charset-normalizer(Python 官方生态推荐的标准依赖库,在 requests 库中内置)对文件头部字节进行统计学检测:
import json
from charset_normalizer import from_bytes

def safe_load_json(file_path: str):
    # 先以二进制只读模式读取前 10KB 字节用于检测编码
    with open(file_path, "rb") as f:
        sample_bytes = f.read(10240)

    # 自动识别编码
    match = from_bytes(sample_bytes).best()
    if match is None:
        encoding_to_use = "utf-8"  # 兜底默认值
    else:
        encoding_to_use = match.encoding
        print(f"探测到文件真实编码为: {encoding_to_use} (置信度: {match.chaos:.2f})")

    # 使用探测到的编码读取正文
    with open(file_path, "r", encoding=encoding_to_use) as f:
        return json.load(f)

# 示例调用
result = safe_load_json("unknown_data.json")
print("解析成功,根字段列表:", list(result.keys()))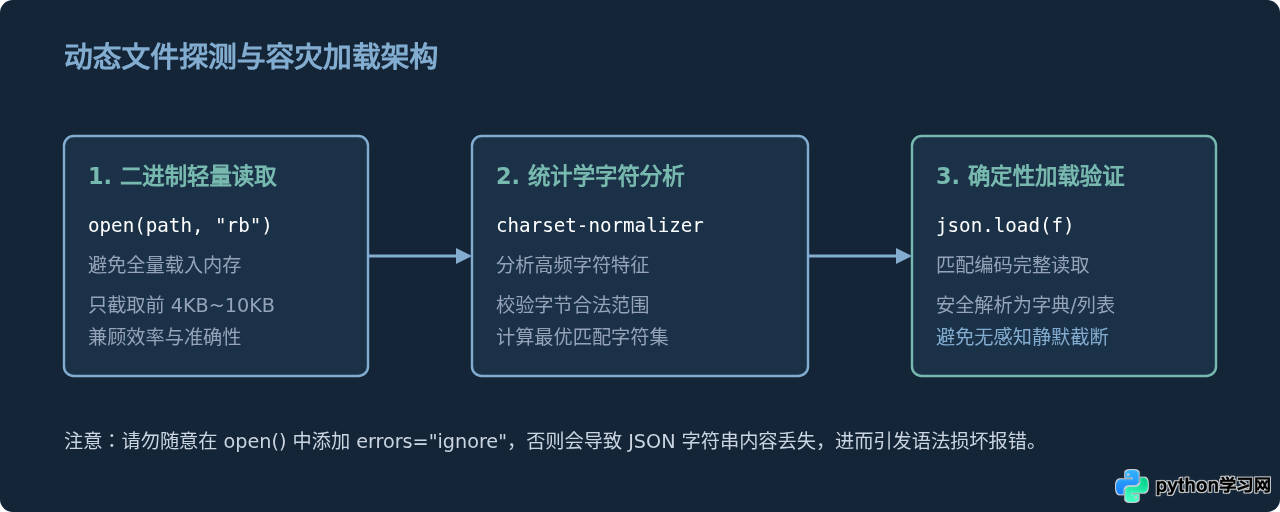
五、常见错误观念与注意事项
- 严禁滥用
errors="ignore": 在读取普通纯文本日志时,有时人们会使用open(..., errors="ignore")跳过无法解码的字节。然而,在读取 JSON 文件时绝对不能这样做。忽略非法字节会导致原本的双引号、逗号、转义字符甚至字段内容被直接剔除,原本的UnicodeDecodeError将会转化为更隐蔽、更难排查的json.decoder.JSONDecodeError。 - 避免使用二进制字符串手动解码:
有些人尝试用
f.read().decode('utf-8'),先以二进制模式读出bytes再手动decode。这种方式不仅增加了内存中完整字节串的占用,而且当文件尺寸极大时,容易产生双倍内存开销。直接将encoding交给open()或TextIOWrapper进行流式解码才是标准推荐写法。 - 源头治理:确保写入端也规范指定编码:
解码错误往往反映的是“存取不对齐”。在生成或导出 JSON 时,应当在 Python 中始终使用带有
ensure_ascii=False和显式 UTF-8 的规范写法:
显式设置# 规范的 JSON 写入模式 with open("output.json", "w", encoding="utf-8") as f: json.dump(data, f, ensure_ascii=False, indent=2)ensure_ascii=False可以直接保存直观的中文字符,而不是\u4f60\u597d形式的转义码,且配合encoding="utf-8"能确保生成的文件具备跨操作系统、跨语言的通用兼容性。
六、总结与速查清单
下表归纳了不同场景下读取 JSON 出现编码问题时的首选应对策略:
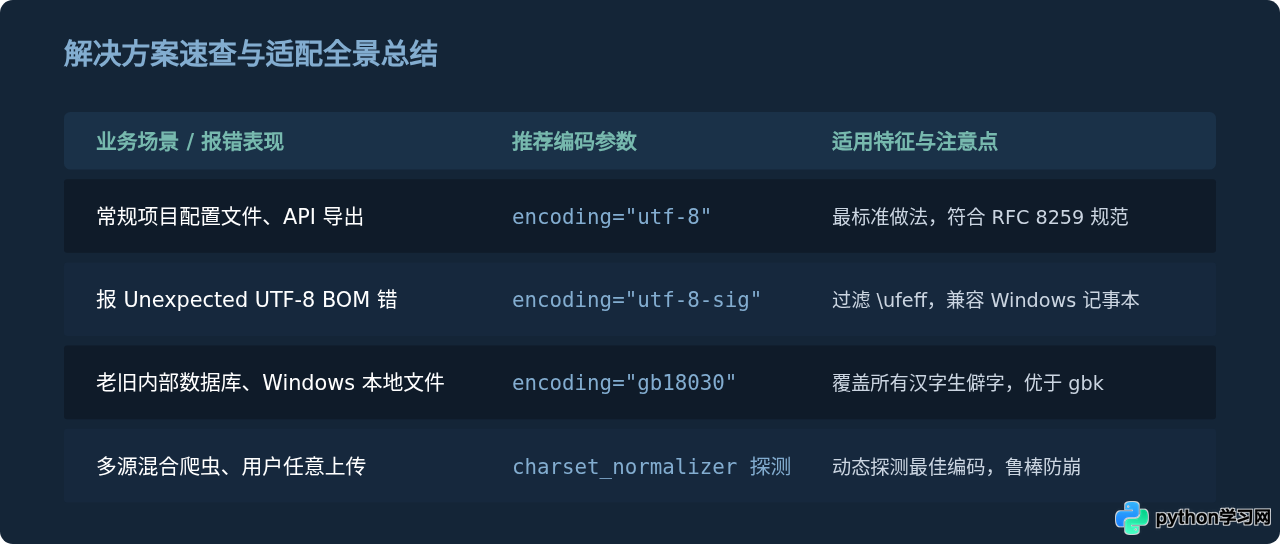
只要养成在每次使用 open() 操作文本文件时显式传入 encoding="utf-8" 的编码习惯,并在出现 BOM 异常时转用 utf-8-sig,就能在开发中规避绝大部分 UnicodeDecodeError,保障程序在 Windows、macOS 与 Linux 各环境下的一致与稳定。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









