

PyTorch中用detach()和no_grad()优化微积分计算性能
深入解析在PyTorch中如何利用detach()与torch.no_grad()优化微积分与数值计算性能,减少显存占用并加速执行。
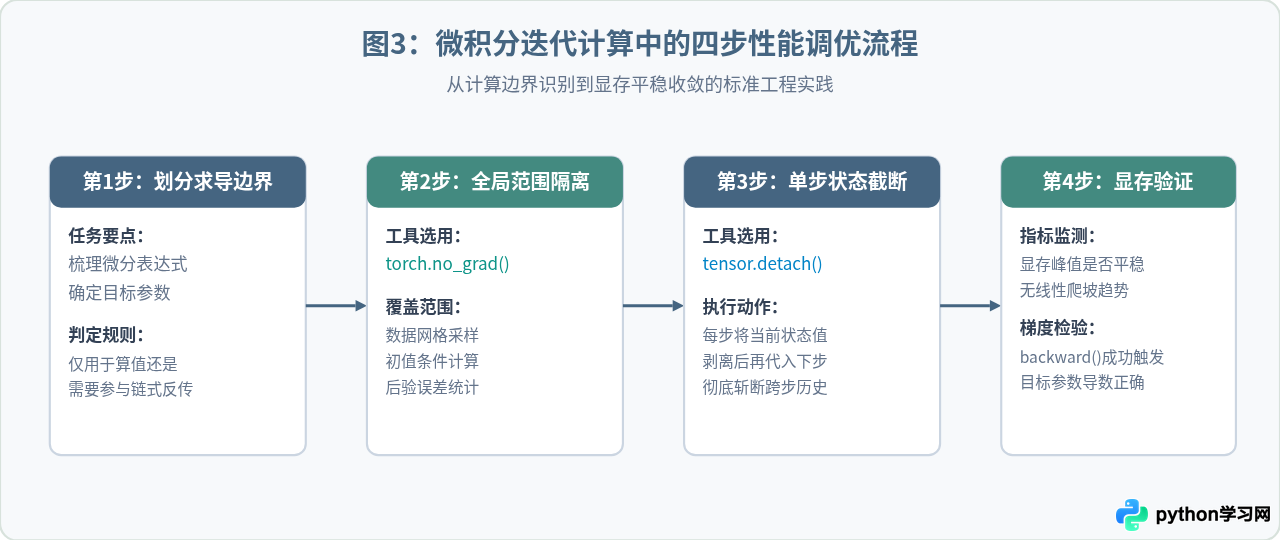
在PyTorch中进行数值微积分、物理信息神经网络(PINN)求解或带有梯度惩罚的高阶微分计算时,系统默认会追踪每一个张量运算并构建动态计算图。当计算流程中混杂着纯数值离散采样、中间辅助状态评估或分步梯度截断时,未受约束的动态图会保留全部前向传播的中间激活值,从而导致显存急剧膨胀并显著拖慢执行效率。合理运用 tensor.detach() 和 torch.no_grad() 能够精确切断冗余的图依赖关系或完全跳过图构建,是保障复杂微积分数值计算高效稳定的核心技巧。
一、自动微分开销机制与优化切入点
PyTorch的自动微分引擎(Autograd)基于反向传播链式法则工作。当一个张量的 requires_grad=True 时,任何基于它的运算都会在底层生成对应的反向计算节点(Node 或 grad_fn),并将前向传播中计算梯度所需的中间张量存入显存缓存区。
在数值微积分场景(例如梯度积分、有限差分逼近、龙格-库塔数值积分或哈密顿系统仿真)中,往往存在多轮迭代步进。如果不主动控制计算图生命周期,计算图会随着积分步数线性堆积,不仅导致计算延迟迅速增加,更极易引发 CUDA 显存溢出(Out of Memory)。
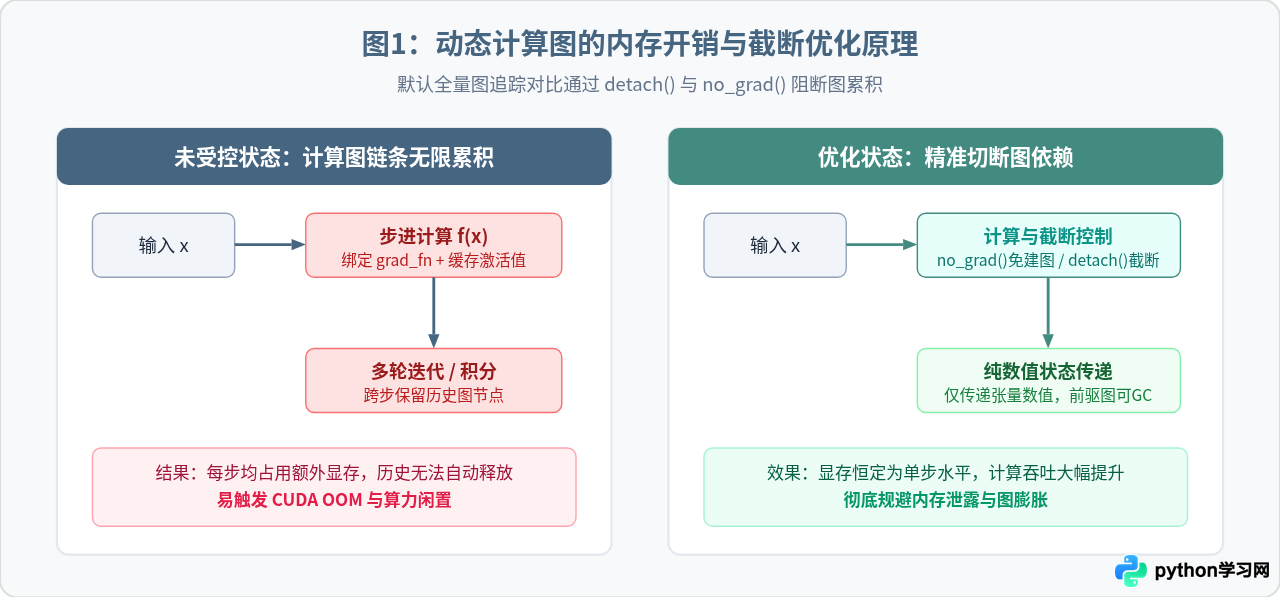
二、核心机制对比:torch.no_grad() 与 tensor.detach()
虽然两者都能停止梯度的记录,但它们在作用范围、底层实现与控制粒度上存在本质差别:
- torch.no_grad():上下文管理器(或函数装饰器)。它在线程局部变量中修改全局求导标记
GradMode::is_enabled() = false。在此上下文内执行的全部算子,均不会构建任何grad_fn,不会为反向传播保留中间张量。 - tensor.detach():针对单个张量的方法。它返回一个与原始张量共享底层数据存储(Storage)但
requires_grad=False的新视图。该张量从原本所在的计算图中被单独剥离,其后续运算不会向后追溯至剥离点之前的父节点。
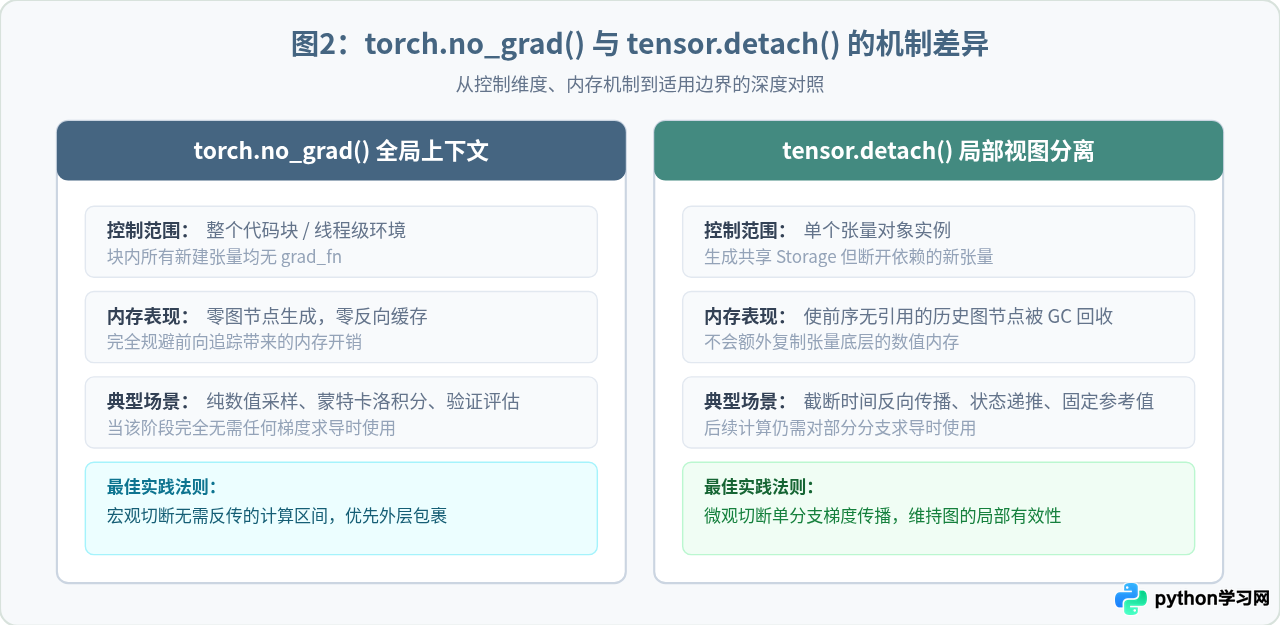
三、数值积分与微分方程求解的优化实践
考虑采用梯形法(Trapezoidal Rule)计算数值定积分:
\int_a^b f(x) dx \approx \sum_{i=0}^{N-1} \frac{f(x_i) + f(x_{i+1})}{2} \Delta x如果目标仅是求取该积分的数值结果,或者在训练循环中积分值仅作为已知输入参数,则整个积分求和过程绝不应该建立计算图:
import torch

def numerical_integral(f, a, b, steps=100000):
    # 纯数值求积分场景:使用 torch.no_grad() 避免为 10 万个离散点保留图节点
    with torch.no_grad():
        x = torch.linspace(a, b, steps, dtype=torch.float32, device="cuda" if torch.cuda.is_available() else "cpu")
        dx = (b - a) / (steps - 1)
        y = f(x)
        integral = torch.trapz(y, x)
    return integral

# 示例函数 f(x) = x^2 + sin(x)
f = lambda t: t**2 + torch.sin(t)
result = numerical_integral(f, 0.0, 3.14159)
print(f"数值积分结果: {result.item():.4f}")
如果不使用 torch.no_grad(),即使输入 x 初始未设置 requires_grad,一旦传入的函数 f 内部包含了带参数的神经网络模块或权重张量,PyTorch 就会强制为每一步构建由数万个节点组成的庞大图结构,显存瞬间激增数百兆甚至数吉字节。
四、混合导数与迭代步进中的 detach() 截断
在求解非线性常微分方程(ODE)或带有自适应步长的动力学系统时,我们常常需要用前一步的状态计算下一步,同时只针对当前时间步反传参数梯度。此时全局禁用梯度的 no_grad() 无法适用,必须在状态递推处使用 detach() 截断历史图。
下面展示一个欧拉法步进求解微分方程的优化范例。状态变量 state 在跨时间步传递时被明确 detach(),使得前一步的计算图得以被 Python 垃圾回收:
import torch

def solve_ode_step_truncated(model, initial_state, steps=1000, dt=0.01):
    state = initial_state
    trajectory_loss = 0.0

    for step in range(steps):
        # 核心优化点:切断上一步的计算图,避免反向传播穿透全部 1000 步
        state = state.detach()
        state.requires_grad_(True)

        # 当前单步物理导数预测
        d_state = model(state)
        next_state = state + d_state * dt

        # 计算当前步的物理守恒损失(如能量守恒误差)
        step_loss = torch.sum(next_state**2)

        # 仅针对当前步优化模型参数
        step_loss.backward()

        state = next_state

return state注意:如果省略了 state = state.detach(),虽然程序表面上能正常运行,但每一步的 next_state 都保留了指向历史所有步的引用,显存使用量会随着 steps 线性增加,在数百步后引发崩溃。
五、高阶导数计算中的特殊注意事项
在求解包含拉普拉斯算子或哈密顿量的高阶微积分问题时,通常需要计算二阶或更高阶导数:
\nabla^2 u = \frac{\partial^2 u}{\partial x^2} + \frac{\partial^2 u}{\partial y^2}此时需特别注意 torch.autograd.grad() 的 create_graph 参数与 detach() 的配合:
- 如果计算一阶导数是为了继续求二阶导数,计算一阶导时必须指定
create_graph=True,切不可在此时对一阶导张量执行detach()。 - 当高阶导数计算完成并合成最终损失标量(Loss)后,用于辅助评估残差或绘图的数据应立即
detach(),防止残余图节点阻碍反向传播后的内存释放。
六、优化选型决策与显存/算力消耗总结
针对不同的微积分与数值计算场景,可参考以下决策路径来选取最适合的优化手段:
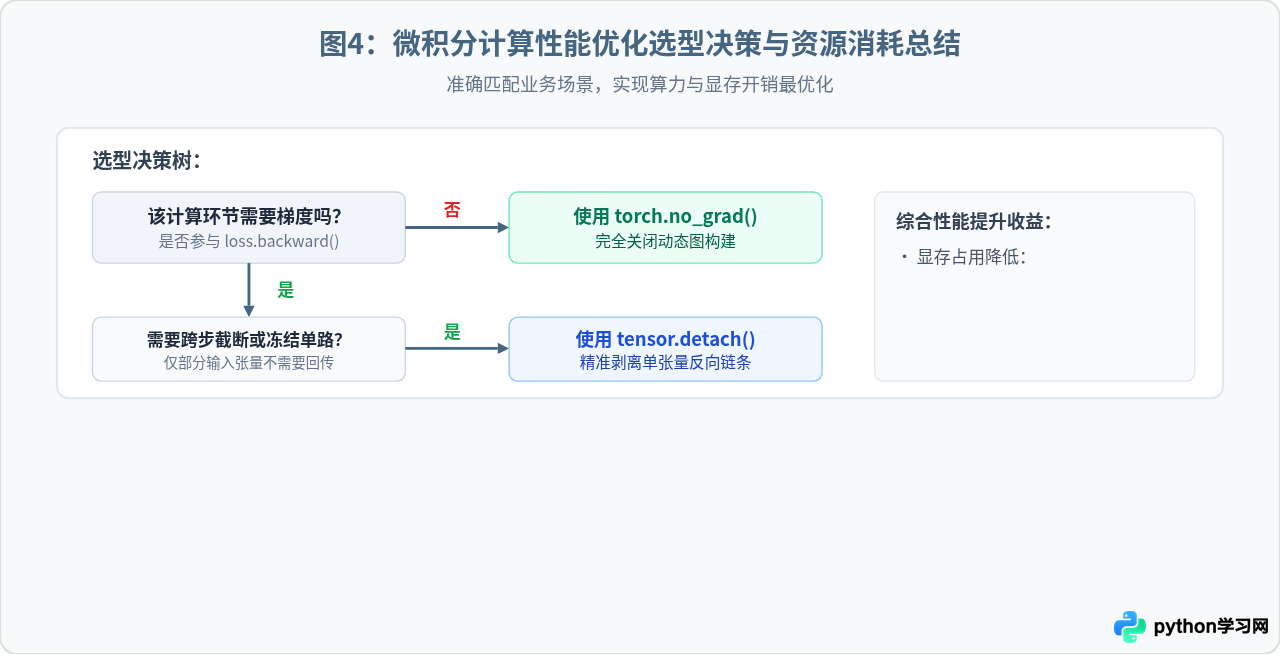
通过遵循“全局无关求导用 no_grad() 隔离,递推中间状态用 detach() 截断”的原则,不仅能使微积分数值计算的显存消耗降低至恒定常数级别,还能消除冗余节点对 PyTorch 自动微分引擎调度器的开销,实现兼顾数值精度与计算吞吐的高性能实现。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









