

Python二分查找怎么统计比较次数
详细讲解在Python二分查找中统计元素比较次数的多种方法,涵盖经典三分支显式计数、双分支单比较计数以及利用包装类劫持运算符的零侵入统计方案,并深入辨析循环轮数与真实比较次数的区别。
在 Python 中统计二分查找的比较次数,核心在于明确“比较”的具体定义,并在每次进行元素大小判断时递增计数器。最直接的做法是在循环内使用累加变量,并在 arr[mid] == target 与 arr[mid] < target 等分支判断处精确记录;若希望在不修改二分算法结构的前提下统计,则可以通过自定义比较对象或包装类重写比较运算符。本文将从单次迭代的比较细节入手,逐步讲解显式计数、双分支优化以及零侵入的包装类统计方法,并辨析循环轮数与真实比较次数的区别。
一、为什么简单的循环计数不能代替比较次数
许多初学者在统计二分查找比较次数时,容易习惯性地在 while 循环开头写上一句 count += 1。这种做法统计的实际上是迭代轮数(即折半区间的缩减次数),而不是数组元素与目标值之间的真实比较次数。
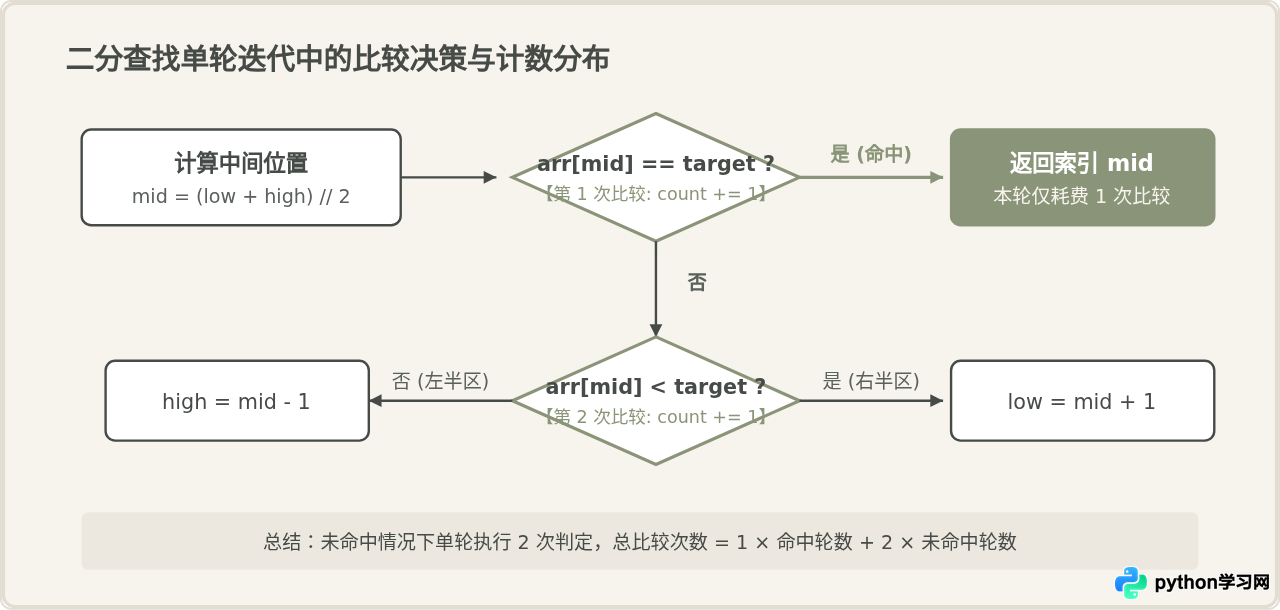
在经典的“三分支”二分查找代码中,每次循环往往包含两次判断:
- 第一次比较:检查中间元素是否等于目标值(
arr[mid] == target)。 - 第二次比较:如果第一次不满足,进入
elif检查中间元素是否小于目标值(arr[mid] < target)。
这意味着:如果目标值恰好在当前 mid 处命中,程序只执行了 1 次等于判定;而如果未命中,程序会紧接着执行第 2 次小于判定。因此,一次循环可能对应 1 次或 2 次比较,简单统计循环次数会导致统计出的比较次数偏少。
二、三分支标准二分查找的显式计数实现
要在经典实现中精确统计比较次数,只需在每次执行关系运算符时对计数器做自增操作。通常可以让函数返回一个元组 (index, comparisons),分别表示目标所在的索引(未找到时为 -1)以及总比较次数。
def binary_search_count_standard(arr, target):
    """
    经典三分支二分查找(精确统计元素比较次数)
    返回: (目标索引, 比较次数)
    """
    low = 0
    high = len(arr) - 1
    comparisons = 0

    while low <= high:
        mid = (low + high) // 2

        # 第一次比较:判断是否相等
        comparisons += 1
        if arr[mid] == target:
            return mid, comparisons

        # 第二次比较:判断大小关系
        comparisons += 1
        if arr[mid] < target:
            low = mid + 1
        else:
            high = mid - 1

    return -1, comparisons
我们以一段具体的测试脚本验证该统计过程:
# 示例验证
data = [11, 23, 35, 47, 58, 69, 82]

# 情况 1:第一次直接命中中间元素 47
idx1, count1 = binary_search_count_standard(data, 47)
print(f"查找 47 -> 索引: {idx1}, 比较次数: {count1}")  # 索引: 3, 比较次数: 1

# 情况 2:查找位于右侧的 58
idx2, count2 = binary_search_count_standard(data, 58)
print(f"查找 58 -> 索引: {idx2}, 比较次数: {count2}")  # 索引: 4, 比较次数: 5
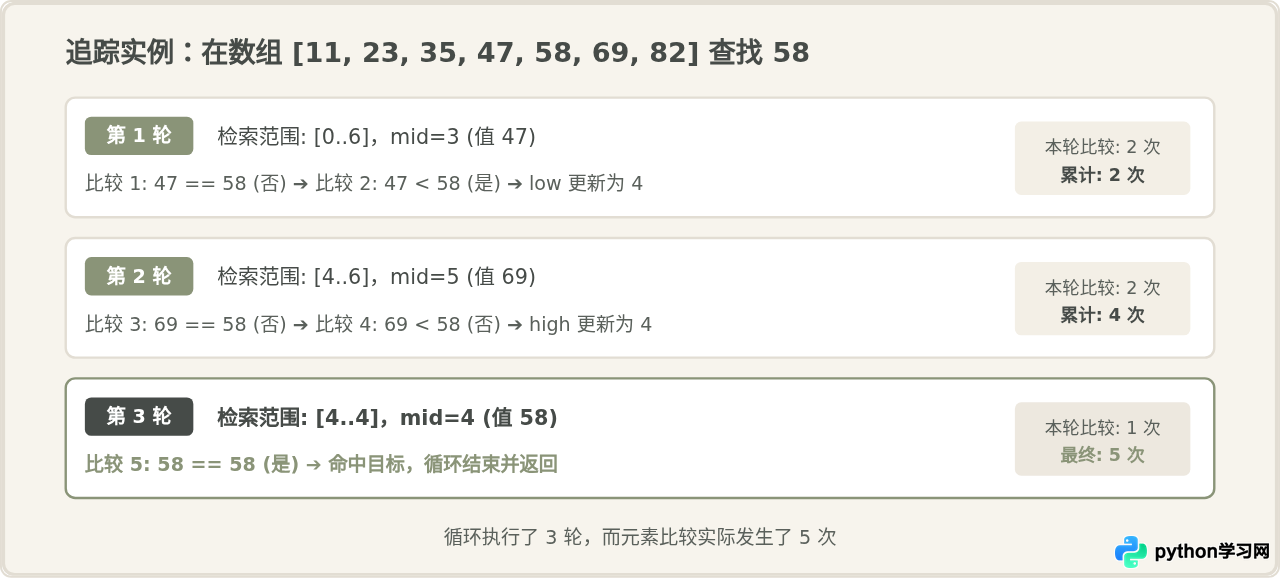
在查找 58 时,经历了以下具体步骤:
- 第 1 轮(区间 0~6,
mid=3,值为 47):比较47 == 58(不成立,计数=1),比较47 < 58(成立,计数=2),区间调整为 4~6。 - 第 2 轮(区间 4~6,
mid=5,值为 69):比较69 == 58(不成立,计数=3),比较69 < 58(不成立,计数=4),区间调整为 4~4。 - 第 3 轮(区间 4~4,
mid=4,值为 58):比较58 == 58(成立,计数=5),返回索引 4。
三、双分支结构:单次迭代严格一次比较
如果希望二分查找在每一轮迭代中只执行严格的 1 次比较,可以采用双分支二分结构。双分支实现不在循环内部急于判断等于,而是始终只用一个小于号 < 将搜索空间压缩至单个元素,循环退出后再做一次最终判断。
def binary_search_count_two_branch(arr, target):
    """
    双分支二分查找(每轮循环仅执行 1 次元素比较)
    返回: (目标索引, 比较次数)
    """
    if not arr:
        return -1, 0

    low = 0
    high = len(arr) - 1
    comparisons = 0

    # 循环内每次只缩减一半,区间长度收缩到 1 时跳出
    while low < high:
        mid = (low + high) // 2
        comparisons += 1
        if arr[mid] < target:
            low = mid + 1
        else:
            high = mid

    # 循环结束后,针对剩下的唯一元素执行最后一次比较
    comparisons += 1
    if arr[low] == target:
        return low, comparisons
    else:
        return -1, comparisons
这种写法的特点在于:比较次数的增长极为稳定。对于长度为 $n$ 的数组,无论目标在数组的开头、中间还是末尾,循环内的比较次数始终严格等于 $\lceil \log_2 n \rceil$,加上最后的一次相等检查,总比较次数固定在 $\lceil \log_2 n \rceil + 1$ 次左右。
四、零侵入方案:使用包装类(CountingWrapper)
在实际工程或测试场景中,二分查找代码可能来自标准库(如 bisect)或已封装好的现成模块,我们往往不便或者不能直接修改函数内部的源码来添加 comparisons += 1。
此时,Python 的数据模型(Data Model)提供了极其优雅的解法:编写一个包装类,重写富比较魔术方法(如 __lt__、__eq__ 等)。只要在比较时触发这些方法,就自动在全局或类属性中累加计数。
class CountingWrapper:
    """包装类:用于自动拦截并统计元素之间的所有比较操作"""
    total_comparisons = 0

    def __init__(self, value):
        self.value = value

    @classmethod
    def reset_count(cls):
        cls.total_comparisons = 0

    def __lt__(self, other):
        CountingWrapper.total_comparisons += 1
        other_val = other.value if isinstance(other, CountingWrapper) else other
        return self.value < other_val

    def __eq__(self, other):
        CountingWrapper.total_comparisons += 1
        other_val = other.value if isinstance(other, CountingWrapper) else other
        return self.value == other_val

    def __gt__(self, other):
        CountingWrapper.total_comparisons += 1
        other_val = other.value if isinstance(other, CountingWrapper) else other
        return self.value > other_val

    def __repr__(self):
        return f"W({self.value})"
使用包装类配合原生的二分查找函数(无需任何计数器代码):
def standard_binary_search(arr, target):
    """标准的未经侵入修改的二分查找"""
    low, high = 0, len(arr) - 1
    while low <= high:
        mid = (low + high) // 2
        if arr[mid] == target:
            return mid
        elif arr[mid] < target:
            low = mid + 1
        else:
            high = mid - 1
    return -1

# 准备测试数据并进行包装
raw_data = [10, 20, 30, 40, 50, 60, 70]
wrapped_data = [CountingWrapper(x) for x in raw_data]

# 重置计数器并进行搜索
CountingWrapper.reset_count()
target_val = CountingWrapper(50)

found_idx = standard_binary_search(wrapped_data, target_val)
print(f"找到索引: {found_idx}")
print(f"底层拦截到的总比较次数: {CountingWrapper.total_comparisons}")
# 输出:找到索引: 4,底层拦截到的总比较次数: 5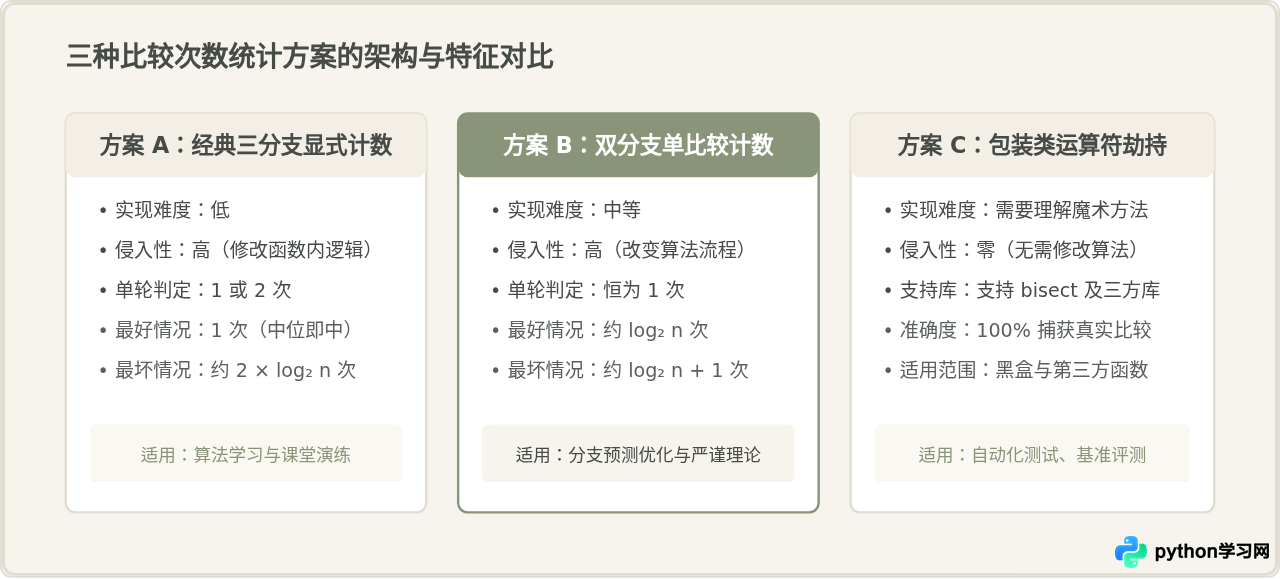
五、常见混淆点与深入辨析
常见说法:“二分查找在长度为 n 的数组中,比较次数一定等于 $\log_2 n$ 吗?”
辨析:这种说法忽略了二分查找的实现结构差异与运气成分:
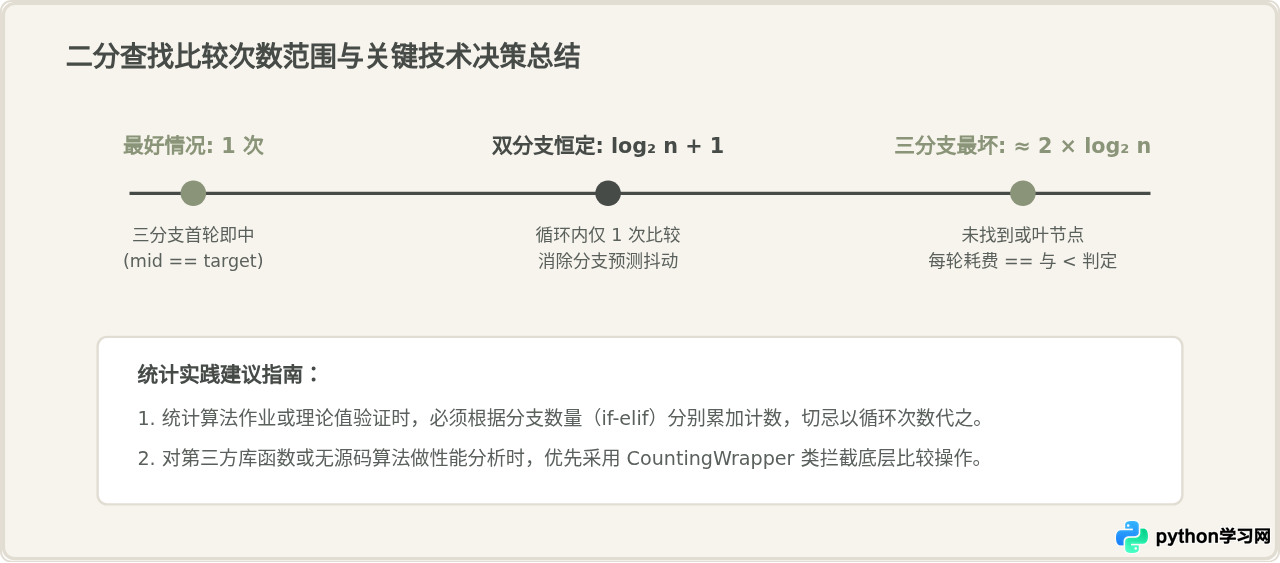
- 最好情况:在三分支二分中,如果第一次计算出的
mid刚好等于目标值,只进行 1 次比较就会立刻退出循环。此时比较次数为 1,远小于 $\log_2 n$。 - 常数因子差异:理论复杂度 $O(\log n)$ 隐藏了常数项。在三分支二分的最坏情况(未找到目标)下,每一层二叉判定树都要经历
==和<两次比较,实际发生的比较次数接近 $2 \lceil \log_2 n \rceil$;而在双分支二分中,每层只有 1 次比较,比较次数严格贴近 $\lceil \log_2 n \rceil$。
为了直观对比不同长度下各情况的统计特征,下表总结了三分支与双分支在元素比较次数上的理论界限:
| 实现模式 | 最好情况(命中) | 最坏情况(末尾或未找到) | 单次循环比较开销 | 是否依赖中间命中 |
|---|---|---|---|---|
| 三分支显式计数 | 1 次 | 约 $2 \lceil \log_2 n \rceil$ 次 | 1 次(命中)或 2 次(未命中) | 是(命中即提前结束) |
| 双分支优化计数 | $\lceil \log_2 n \rceil + 1$ 次 | $\lceil \log_2 n \rceil + 1$ 次 | 恒为 1 次(退出后再比 1 次) | 否(始终完全折半收缩) |
| 包装类自动拦截 | 与被测函数逻辑一致 | 与被测函数逻辑一致 | 自动感知底层所有比较运算 | 取决于被调用的算法实现 |
六、总结
统计 Python 二分查找的比较次数,核心关键是识别算法实现是三分支结构还是双分支结构。在经典三分支代码中,每次迭代存在等于和小于两次独立的比较操作,计数器需要分置于两处判断前;在双分支写法中,单次循环严格只做一次比较;而当需要无侵入测试已有算法或标准库函数时,借助 Python 类的 __lt__ 与 __eq__ 魔术方法封装数据,是最准确且通用的专业手段。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









