

Python人工智能入门项目:机器学习与深度学习实战案例
本文通过房价预测与手写数字识别两个经典项目,系统讲解Python机器学习与深度学习的实战流程、核心算法、代码实现与常见避坑指南。
初学 Python 人工智能时,很多开发者容易在理论概念中迷失,分不清何时该用传统的 Scikit-Learn,何时又必须引入 PyTorch 等深度学习框架。本文直接从实战出发,选取了两个具有代表性的基石项目:一个是基于 Scikit-Learn 的加州房价回归预测(经典机器学习项目),另一个是基于 PyTorch 的手写数字图像识别(深度学习卷积神经网络)。通过这两个案例的完整实现,读者将清晰掌握两种技术范式的差异、项目落地完整链路以及关键避坑技巧。
一、机器学习与深度学习的核心差异与选型
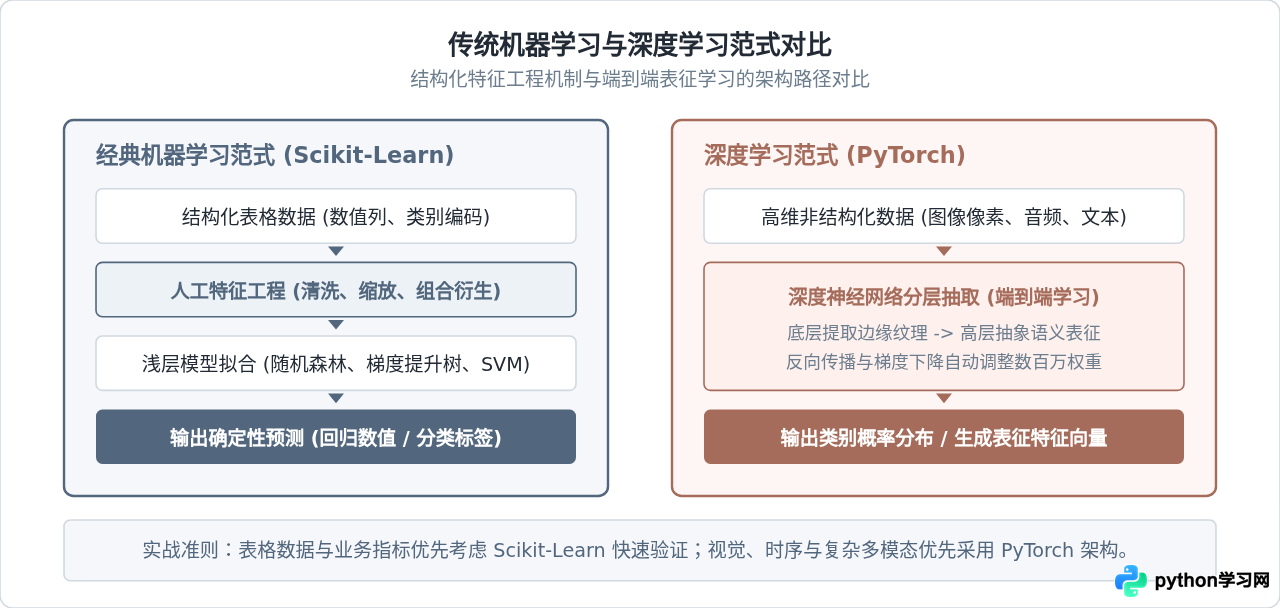
理解人工智能项目的第一步是建立合理的工具选型认知。经典机器学习与现代深度学习并不是替代关系,而是面向不同数据结构和业务复杂度的互补方案:
- 经典机器学习(以 Scikit-Learn 为代表):核心优势在于对结构化表格数据(如带有数值特征、类别标签的数据表)的高效处理。它依赖工程师进行明确的特征工程(Feature Engineering),例如缺失值填充、离群点处理、标准化及特征交叉。其模型参数量少、训练速度极快,在算力有限的单机 CPU 环境下即可完成高质量拟合,且决策树与线性模型具备天然的可解释性。
- 深度学习(以 PyTorch、TensorFlow 为代表):核心优势在于处理非结构化数据(如图像像素、音频频谱、自然语言序列)。它采用多层神经网络自动实现特征的分层抽取与组合,省去了繁重的手工特征构造,但对训练样本量和硬件算力(GPU/TPU)有较高依赖,且模型通常呈现端到端的黑盒特征。
在环境搭建方面,推荐使用纯净的 Python 3.10+ 虚拟环境,并通过 pip 安装本案例所需的库依赖:
pip install numpy pandas scikit-learn torch torchvision matplotlib二、机器学习实战:加州房价回归预测(Scikit-Learn)
该项目的业务目标是根据地理位置、房屋年限、周边居民收入水平等特征,预测该区域的房屋中位数价格。这是一个典型的监督学习回归任务。
1. 完整业务操作流程
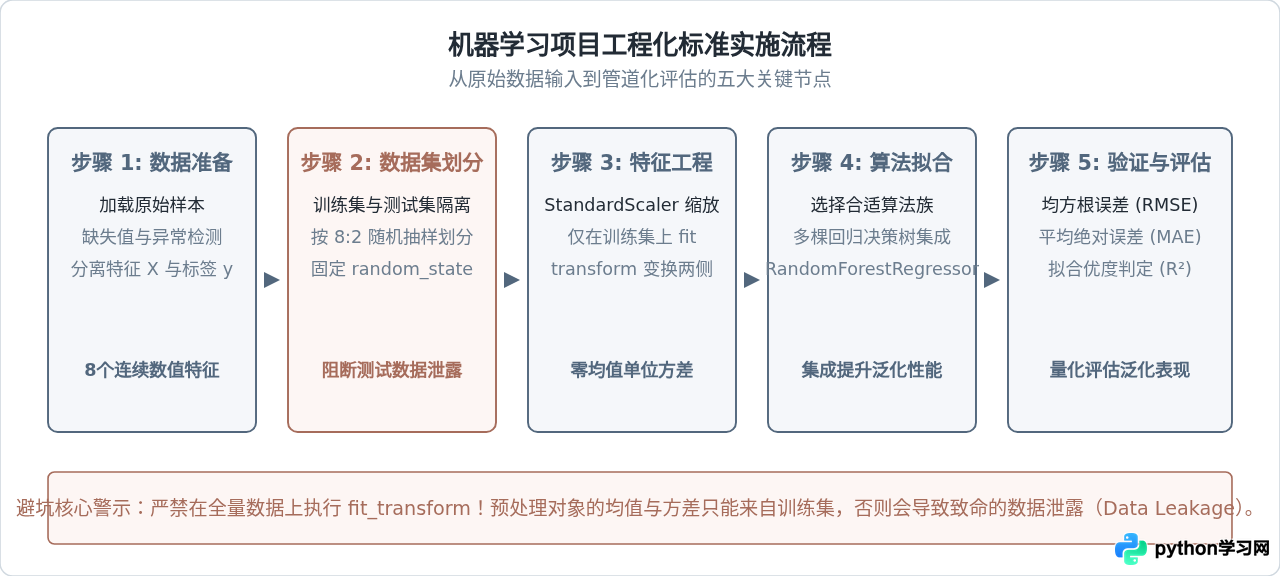
在实际工程中,机器学习不仅仅是调用一行模型拟合代码,而是遵循严谨的管道化流水线:
2. 实战可运行代码
以下代码展示从数据切分、标准化到随机森林回归模型训练与指标评估的完整实现:
import numpy as np
from sklearn.datasets import fetch_california_housing
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score

# 1. 载入数据集
housing = fetch_california_housing(as_frame=True)
X, y = housing.data, housing.target

# 2. 严格隔离训练集与测试集 (8:2 分割)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 3. 特征工程:只在训练集上计算均值与标准差
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)  # 测试集仅做 transform

# 4. 构建并拟合集成随机森林回归器
model = RandomForestRegressor(
    n_estimators=100,
    max_depth=15,
    min_samples_split=4,
    random_state=42,
    n_jobs=-1
)
model.fit(X_train_scaled, y_train)

# 5. 模型预测与性能指标计算
y_pred = model.predict(X_test_scaled)
rmse = np.sqrt(mean_squared_error(y_test, y_pred))
mae = mean_absolute_error(y_test, y_pred)
r2 = r2_score(y_test, y_pred)

print(f"评估结果统计:")
print(f"均方根误差 (RMSE): {rmse:.4f}")
print(f"平均绝对误差 (MAE): {mae:.4f}")
print(f"决定系数 (R^2 Score): {r2:.4f}")在标准执行环境下,该脚本的测试集评估输出通常接近以下水平:
均方根误差 (RMSE): 0.4982
平均绝对误差 (MAE): 0.3245
决定系数 (R^2 Score): 0.8115
R² 达到 0.81 说明随机森林对加州房价 80% 以上的方差具备解释能力,表现远优于纯线性回归基线(通常 R² 在 0.58 左右)。
三、深度学习实战:手写数字图像识别(PyTorch)
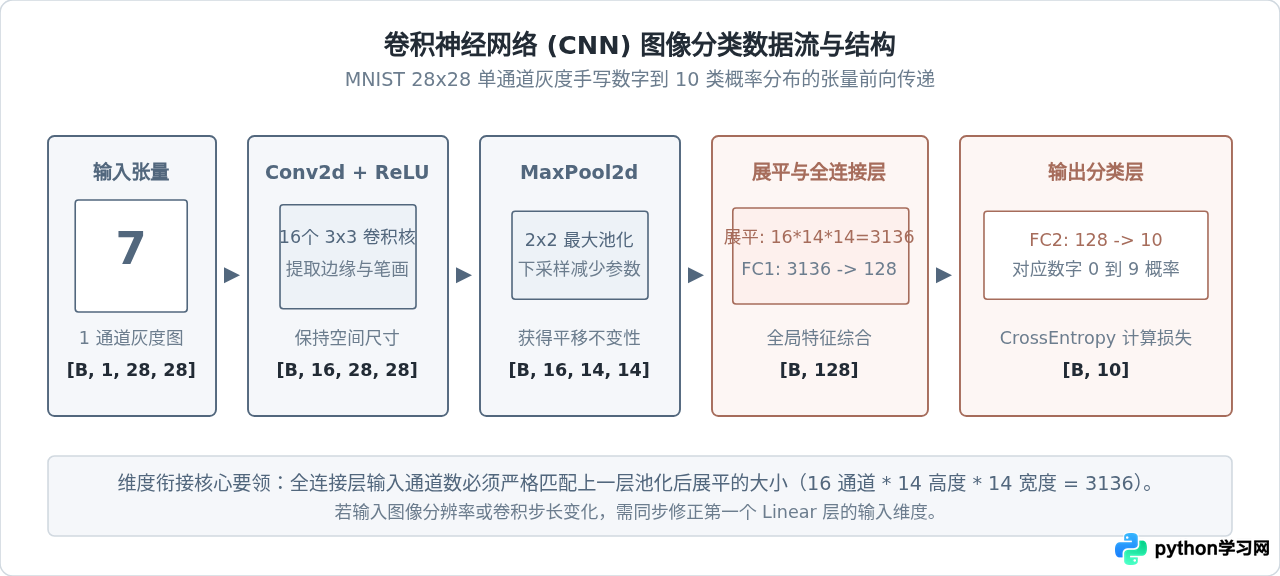
处理视觉信号等非结构化数据时,传统表格模型难以捕捉二维像素间的空间邻近关联。我们采用经典的卷积神经网络(Convolutional Neural Network, CNN)对 MNIST 数据集(28×28 单通道灰度图)进行分类。
1. 网络结构与特征提取流转
深度学习的核心是张量(Tensor)在各网络层之间的维度变换与前向特征映射:
2. PyTorch 完整可运行代码
深度学习的训练范式包含三个经典步骤:前向计算输出、计算损失并反向传播梯度、优化器更新权重参数。以下代码演示一个完整周期的训练与验证流程:
import torch
import torch.nn as nn
import torch.optim as optim
from torchvision import datasets, transforms
from torch.utils.data import DataLoader

# 1. 统一硬件运行设备选择
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print(f"当前运行计算后端: {device}")

# 2. 数据流水线与加载器构建 (数据增强与标准化)
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.1307,), (0.3081,))  # MNIST 官方推荐均值与标准差
])

train_dataset = datasets.MNIST(root='./data', train=True, download=True, transform=transform)
test_dataset = datasets.MNIST(root='./data', train=False, download=True, transform=transform)

train_loader = DataLoader(train_dataset, batch_size=64, shuffle=True)
test_loader = DataLoader(test_dataset, batch_size=1000, shuffle=False)

# 3. 构造卷积神经网络架构类
class ConvNet(nn.Module):
    def __init__(self):
        super(ConvNet, self).__init__()
        self.features = nn.Sequential(
            nn.Conv2d(in_channels=1, out_channels=16, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2)  # 输出尺寸: [16, 14, 14]
        )
        self.classifier = nn.Sequential(
            nn.Linear(16 * 14 * 14, 128),
            nn.ReLU(),
            nn.Dropout(p=0.25),
            nn.Linear(128, 10)  # 10 类别输出
        )

    def forward(self, x):
        x = self.features(x)
        x = x.view(x.size(0), -1)  # 展平为一维张量
        x = self.classifier(x)
        return x

model = ConvNet().to(device)
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=0.001)

# 4. 模型训练循环
def train_one_epoch(epoch):
    model.train()
    total_loss = 0.0
    for batch_idx, (data, target) in enumerate(train_loader):
        data, target = data.to(device), target.to(device)

        optimizer.zero_grad()            # 必须手动清零旧梯度
        output = model(data)             # 前向传播
        loss = criterion(output, target) # 计算损失
        loss.backward()                  # 反向传播计算新梯度
        optimizer.step()                 # 更新权重参数

        total_loss += loss.item()
    print(f"Epoch {epoch} 训练完成,平均损失: {total_loss / len(train_loader):.4f}")

# 5. 模型验证与准确率评估
def evaluate():
    model.eval()
    test_loss = 0.0
    correct = 0
    with torch.no_grad():  # 评估时关闭梯度计算,节省显存与算力
        for data, target in test_loader:
            data, target = data.to(device), target.to(device)
            output = model(data)
            test_loss += criterion(output, target).item()
            pred = output.argmax(dim=1, keepdim=True)
            correct += pred.eq(target.view_as(pred)).sum().item()

    accuracy = 100.0 * correct / len(test_loader.dataset)
    print(f"测试集评估结果:准确率 = {accuracy:.2f}%")

# 启动训练 3 轮演示
for epoch in range(1, 4):
    train_one_epoch(epoch)
evaluate()仅需训练 3 个 Epoch,该轻量 CNN 模型在测试集上的分类准确率即可迅速达到 98.5% 以上。相比于全连接网络,卷积层利用局部连接与权值共享机制,在大幅降低参数量(本网络仅约 40 万参数)的同时,显著增强了对数字形变与位移的容忍度。
四、新手常见错误排查与调试清单
在调试 AI 项目代码时,多数报错并非源于复杂的数学原理,而是源于张量操作与数据流转的细节疏漏:
| 常见问题表现 | 根本原因排查 | 针对性解决方案 |
|---|---|---|
| 数据泄露 (Data Leakage) | 在未划分数据集前就统一对全量数据执行了标准化或缺失值均值填充。 | 严格先划分 train_test_split,预处理对象仅调用 scaler.fit(X_train),测试集只执行 transform。 |
| 张量形状报错 (RuntimeError: shape mismatch) | 全连接层(Linear)的输入维度与上一层池化或卷积展平后的输出尺寸不一致。 | 在 forward 中先打印 x.shape,确认通道与长宽乘积后再设置 Linear 的 in_features。 |
| 模型无法收敛,损失居高不下 | 训练循环中遗漏了 optimizer.zero_grad(),导致梯度在每个 batch 间持续累加错误。 |
确保在每次执行 loss.backward() 之前调用 optimizer.zero_grad()。 |
| 评估模式显存溢出或结果异常 | 在测试阶段未关闭梯度图计算,或未将模型切换至 eval() 状态。 |
测试与推断逻辑必须包裹在 with torch.no_grad(): 内,并显式执行 model.eval()。 |
五、项目总结与后续进阶路径
通过本文两个实战案例,我们可以总结出清晰的 AI 项目研发基线策略。面对具体业务场景时,不要盲目追求复杂度,而应建立“基线模型优先”的工程思维:
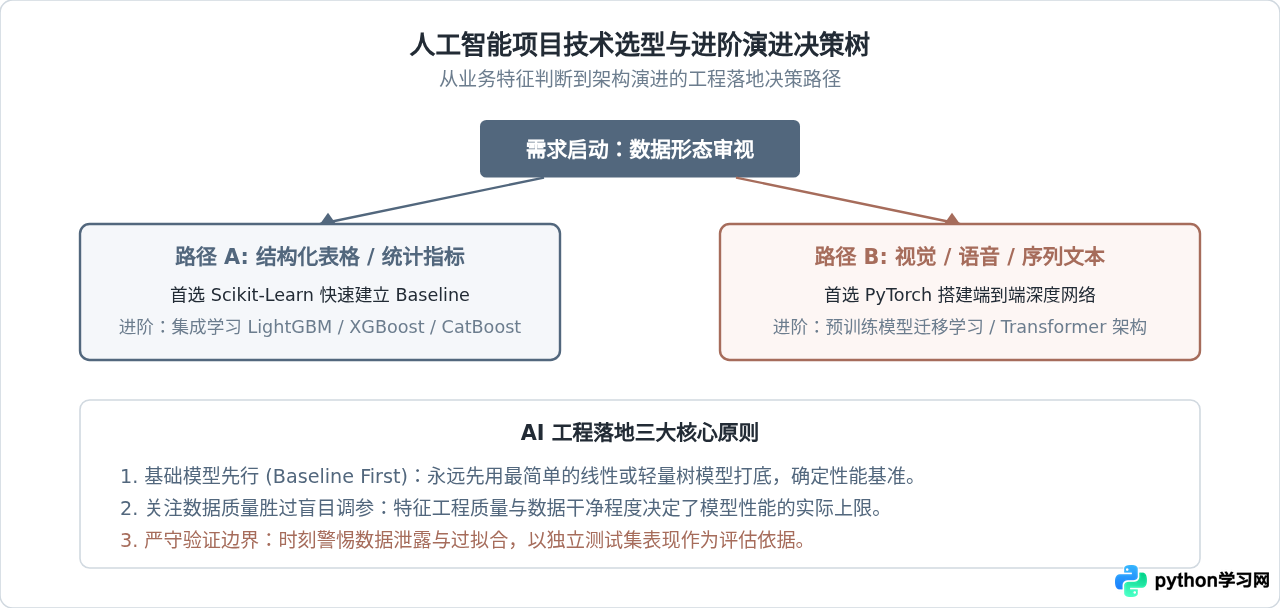
完成这两个入门案例后,读者的进阶建议是:针对表格数据,深入学习 LightGBM 与特征重要性分析;针对图像与文本,学习基于预训练模型(如 torchvision 中的 ResNet 或 Hugging Face 中的 Transformer)进行微调迁移,以此逐步过渡到工业级项目的复杂场景中。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









