

除了Web开发,Python还有哪些核心技术框架?数据科学与AI领域盘点
全面盘点Python在Web开发之外的核心技术框架,深入解析数据分析、经典机器学习、深度学习及大模型(LLM)开发等关键领域的技术选型与实战要点。
许多开发者初次接触 Python 是通过 Django、FastAPI 或 Flask 构建 Web 后端,但在现代软件工程中,Python 真正无可替代的领域是数据科学与人工智能。从最底层的多维数组向量化运算,到经典统计建模,再到千亿参数大语言模型(LLM)的训练与高并发推理,Python 拥有完整而精密的技术框架栈。本文直接梳理数据科学与 AI 全生命周期的核心技术框架及其关键选型依据。
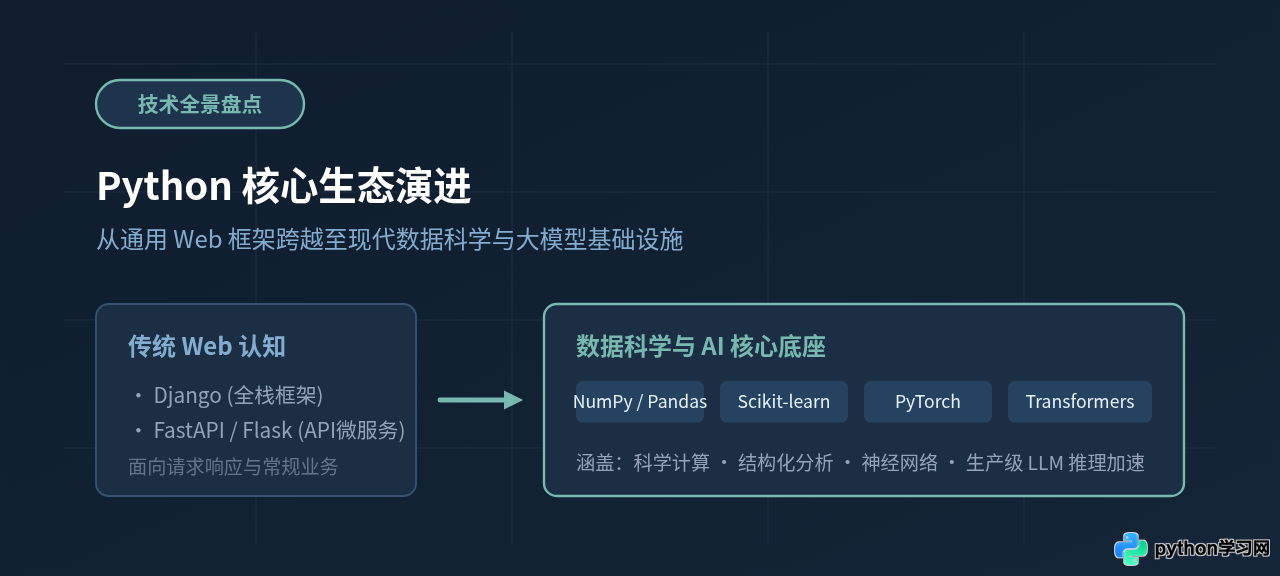
图 0:Python 技术生态全景:从 Web 服务向智能计算中心的演进
一、数据科学与 AI 技术栈分层架构
在工程实践中,数据科学与 AI 并非单点工具的堆砌,而是清晰分层的工程技术体系。从底层硬件(CPU/GPU)与 C/C++ 运行时,到最上层的大模型应用开发,各个框架在流水线中各司其职:
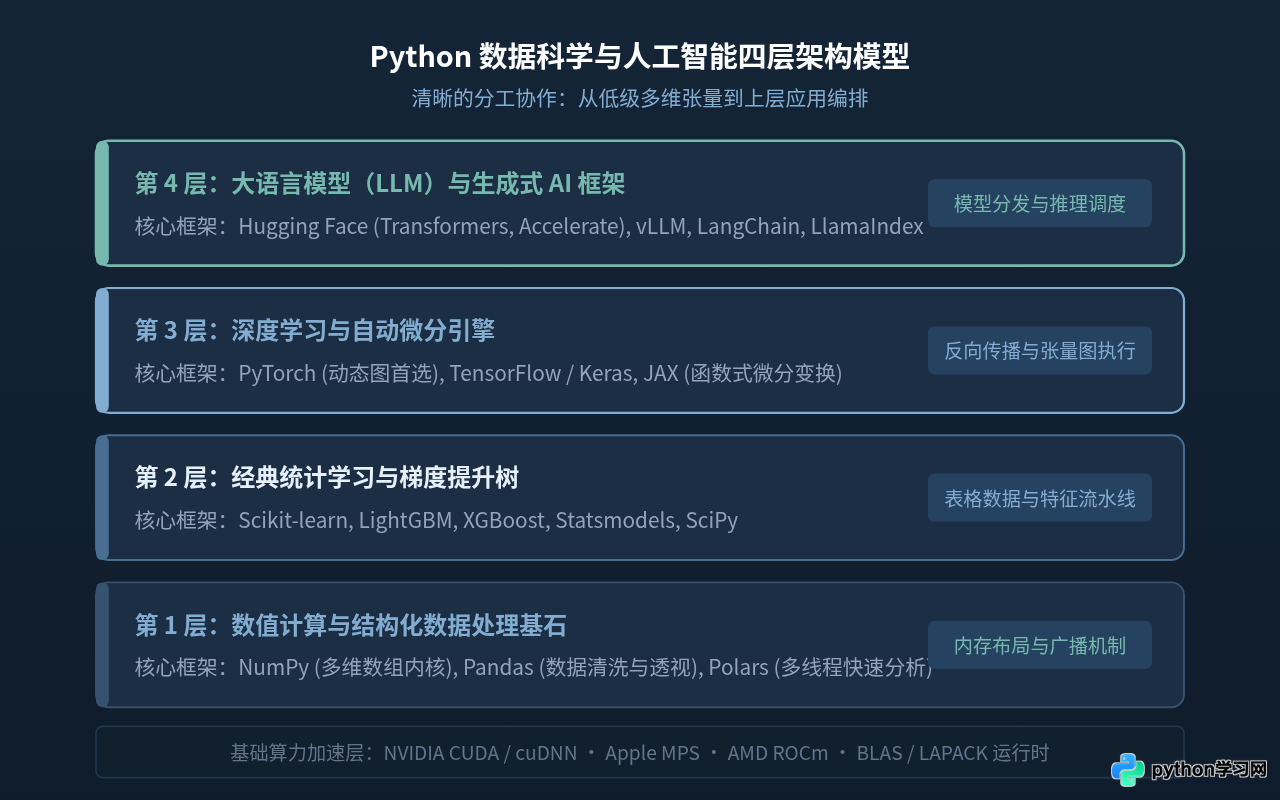
图 1:Python 数据科学与人工智能四层架构模型
二、底层基石:数值计算与数据整理框架
无论后续是跑复杂的 Transformer 还是训练一棵决策树,所有原始输入都必须被量化为内存中的连续矩阵。如果使用 Python 自带的列表(list)进行多层嵌套循环,由于解释执行和对象开销,速度会比底层编译语言慢上百倍。这一层的核心任务就是提供高性能连续内存块与向量化操作。
1. NumPy:整个科学计算世界的通用货币
NumPy 提供了 ndarray(N 维数组)对象。它的底层采用 C 语言编写,连续存储同质数据类型,支持广播(Broadcasting)机制和向量化矢量运算。当调用 a + b 时,底层直接触发高度优化的 SIMD 指令集,而非在 Python 解释器内循环单个元素。
import numpy as np

# 示例:创建连续浮点型二维矩阵并进行向量化标量乘法与矩阵乘
matrix_a = np.array([[1.0, 2.0], [3.0, 4.0]], dtype=np.float32)
matrix_b = np.array([[5.0, 6.0], [7.0, 8.0]], dtype=np.float32)

# 避免 Python for 循环,直接调用向量化乘法
result = np.dot(matrix_a, matrix_b)
print("矩阵点积计算结果示例:\n", result)
2. Pandas 与 Polars:结构化表格数据处理
NumPy 擅长纯数值矩阵,但在实际业务中,数据往往包含表头、缺失值(NaN)、字符串枚举与时间戳。Pandas 提供的 DataFrame 与 Series 成为现代数据清洗的标准接口。
- Pandas:生态最为成熟,几乎所有机器学习书籍和生产脚本都依赖它进行数据过滤、缺失值填补与分组聚合(GroupBy)。但在处理数十吉字节(GB)的大型文件时单线程瓶颈明显。
- Polars:基于 Rust 编写的新生代 DataFrame 框架,原生支持多线程并行、惰性计算查询优化(Lazy Execution)与 Apache Arrow 内存格式,在处理超大单机数据集时常能带来数倍到十倍的性能提升。
三、经典机器学习:建模、统计与梯度提升树
深度学习固然强大,但在银行风控评分卡、电商搜索排序、传感器异常检测等绝大多数结构化表格数据场景中,经典机器学习模型以高可解释性、低算力消耗和稳健的预测表现,仍然是生产落地的主力军。
1. Scikit-learn:规范优雅的统一 API 标准
Scikit-learn(简称 sklearn)是 Python 生态中最具工业美感的库之一。它确立了机器学习生命周期的标准面向对象范式:
Estimator.fit(X, y):模型拟合与参数学习。Transformer.transform(X):特征变换(标准化、归一化、独热编码)。Predictor.predict(X):对新样本输出预测值。
通过 Pipeline 机制,开发者可以将缺失值补全、特征缩放与最终估计器串联为一个整体,杜绝了测试集数据泄漏(Data Leakage)的工程隐患。
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline
from sklearn.metrics import accuracy_score

# 1. 模拟生成结构化分类数据集
X, y = make_classification(n_samples=1000, n_features=10, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 2. 构建严密的工程流水线(防止测试集特征泄露)
model_pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', LogisticRegression(C=1.0, solver='lbfgs'))
])

# 3. 拟合与评估
model_pipeline.fit(X_train, y_train)
predictions = model_pipeline.predict(X_test)
print(f"验证集分类准确率示例: {accuracy_score(y_test, predictions):.4f}")
2. XGBoost 与 LightGBM:表格数据的屠龙刀
在各类商业推荐与 Kaggle 数据挖掘竞赛中,基于决策树的梯度提升算法(GBDT)在表格数据上的表现常常超越深度神经网络。XGBoost 引入了二阶泰勒展开和正则项;LightGBM 则通过基于直方图(Histogram)的切分算法与按叶子生长(Leaf-wise)策略,大幅降低了内存消耗并提升了训练速度。
四、端到端数据与 AI 应用研发落地流程
将上述框架在生产中串联起来,通常遵循严谨的阶段性流水线。每个阶段输出的数据格式必须精确适配下一阶段框架的输入要求:
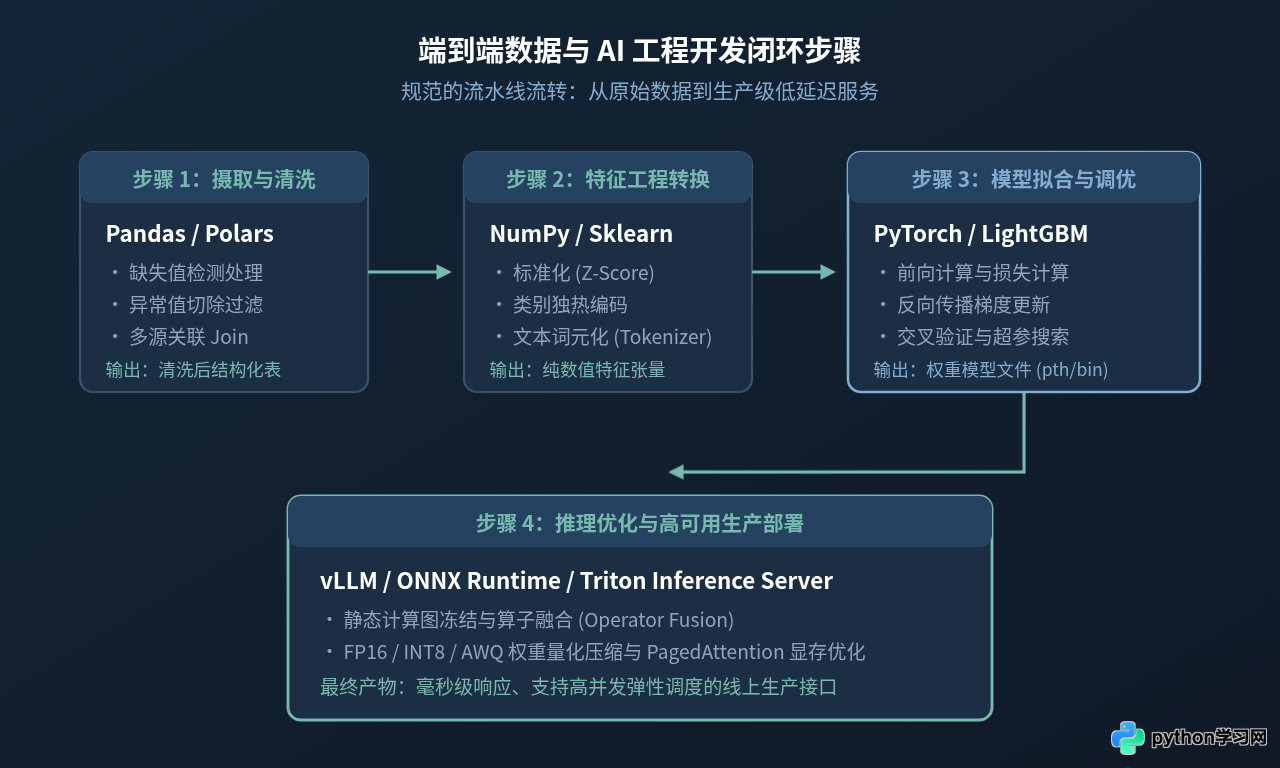
图 2:从数据清洗到模型部署落地的全流程流水线
五、深度学习与神经网络核心引擎
当面临图像识别、目标检测、语音交互与大规模自然语言建模时,传统手工提取特征(Feature Engineering)的方式难以应对高维非线性空间。深度学习框架的核心使命是提供:自动微分(Autograd)机制与GPU/TPU 硬件加速能力。
1. PyTorch:学术界与大模型时代的事实工业标准
由 Meta 人工智能研究院开源的 PyTorch 凭借其“动态计算图”(Define-by-Run)彻底赢得了开发者的青睐。在 PyTorch 中,编写神经网络就像编写普通的 Python 原生代码一样,可以自由使用 Python 的 if 分支、for 循环和原生调试器(pdb)。
import torch
import torch.nn as nn

# 定义一个轻量多层感知机(MLP)
class SimpleClassifier(nn.Module):
    def __init__(self, in_features=16, num_classes=2):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(in_features, 32),
            nn.ReLU(),
            nn.Linear(32, num_classes)
        )

    def forward(self, x):
        return self.net(x)

# 动态反向传播验证
model = SimpleClassifier()
sample_input = torch.randn(4, 16) # 批量为4的随机特征输入
sample_target = torch.tensor([1, 0, 1, 0])

criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

# 单步训练迭代循环
optimizer.zero_grad()
output = model(sample_input)
loss = criterion(output, sample_target)
loss.backward()  # 自动微分:反向传播计算梯度
optimizer.step() # 参数更新

print(f"前向传播损失值计算示例: {loss.item():.4f}")
2. TensorFlow 与 Keras:工业级全栈服务体系
由 Google 主导的 TensorFlow 凭借成熟的 TFLite(端侧移动设备部署)和 TF Serving(工业级 C++ 推理服务网格),在大型传统企业级服务与移动边缘计算中依然占据重要地位。其高阶 API Keras 则以极简的人性化设计著称,目前 Keras 3 已经支持无缝切换 PyTorch、TensorFlow 和 JAX 作为底层后端。
3. JAX:前沿函数式张量计算利器
由 Google DeepMind 重点应用的 JAX 走的是另一条纯函数式路线。它将 NumPy 的标准 API 与 grad(任意阶微分)、jit(XLA 即时编译优化)、vmap(自动矢量化批处理)相结合,在强化学习与科学计算(如分子动力学、气象预测)中极受推崇。
六、大模型(LLM)与生成式 AI 应用框架
过去几年,AI 开发范式发生了根本性转移:从“从零训练小模型”转向“基于预训练基础模型(Foundation Model)进行微调、检索增强(RAG)与 Agent 编排”。围绕这一变化,Python 生态迅速涌现出一批现象级核心框架。
1. Hugging Face(Transformers & Accelerate)
Hugging Face 的 transformers 库已成为全球开源大模型(如 Llama、Qwen、Mistral 等)事实上的中枢枢纽。无论加载文本 Tokenizer、模型权重,还是执行 LoRA 轻量微调,只需几行代码即可完成。
2. vLLM:高并发低延迟的生产级推理引擎
在大语言模型投入生产时,原生 PyTorch 的内存管理机制会导致大量的显存碎片(高达 60%~80% 浪费在 KV Cache 上)。加州大学伯克利分校提出的 vLLM 引入了类似操作系统虚拟内存分页的 PagedAttention 算法,使单卡吞吐量直接飙升数倍,并内置兼容 OpenAI 的标准 RESTful API 服务,已成为各大企业自建大模型 API 服务的标配。
3. LangChain 与 LlamaIndex:上下文与智能体连接器
大模型本身是封闭的“黑盒脑泡”,缺乏企业内部实时数据。LlamaIndex 专注于高精度文档切片、向量索引与检索增强生成(RAG);而 LangChain 则提供了调用外部 API、执行代码、多步推理规划(Agent)的标准管道粘合层。
七、各领域核心技术框架对比矩阵
为了帮助读者根据实际计算资源和业务场景准确选型,下表对四大领域的典型框架核心特征进行横向对比:
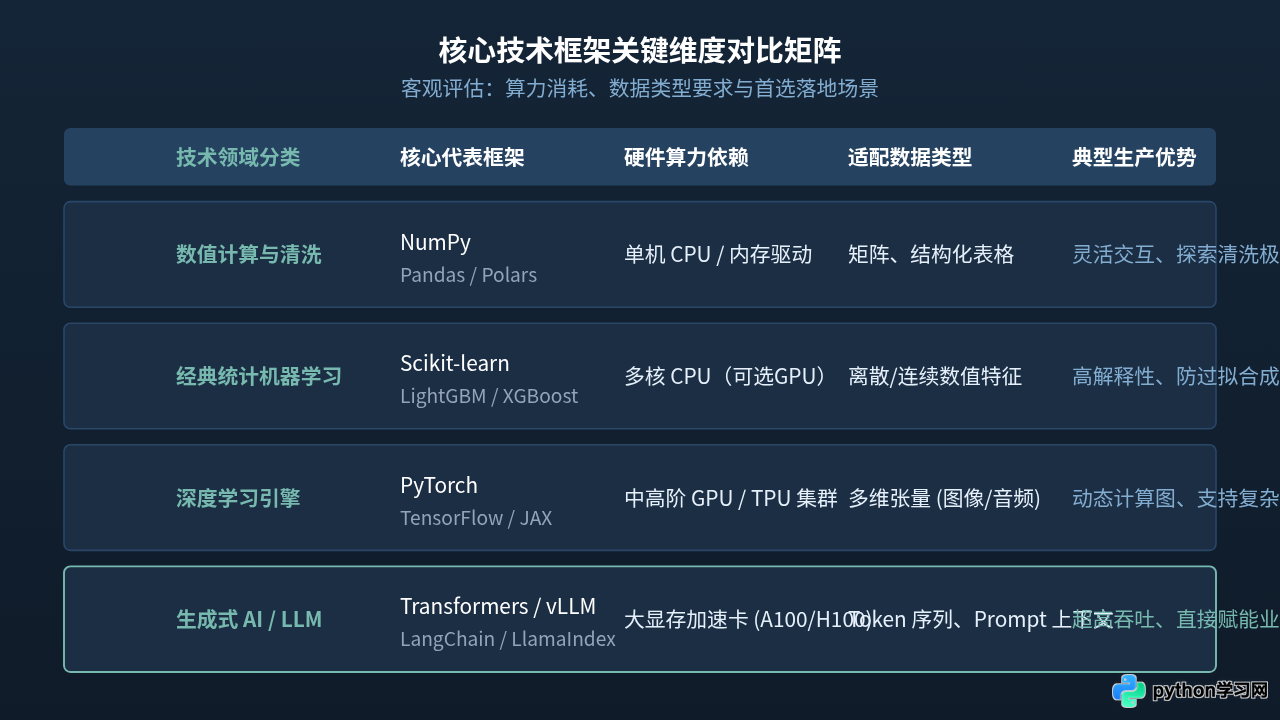
图 3:跨领域技术框架的多维对比矩阵
八、框架技术选型决策路径
面对业务需求,切忌盲目上马最复杂、成本最高的大模型。合理的工程选型决策应当遵循“奥卡姆剃刀原则”:优先使用能够以最小算力代价达成指标的框架。
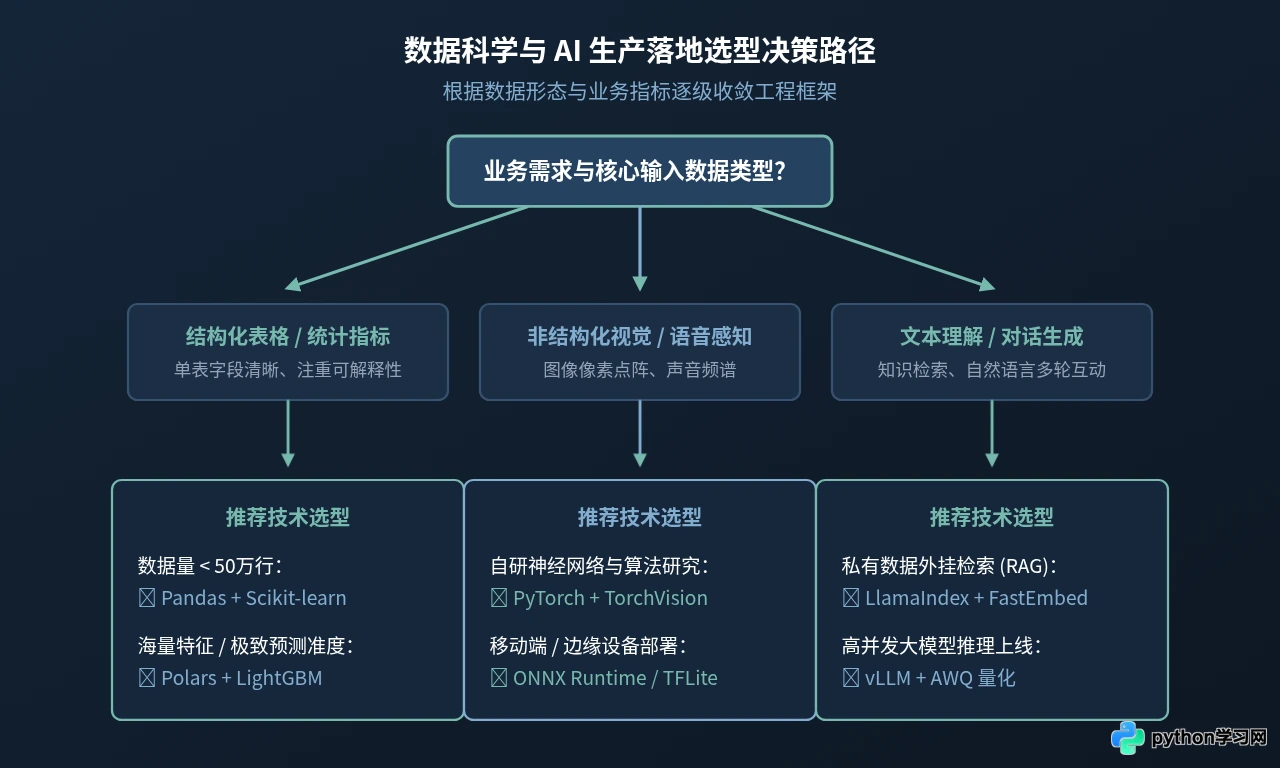
图 4:数据科学与 AI 生产落地技术选型路径
九、总结与学习路径建议
掌握 Python 并不意味着仅仅掌握编写路由函数与 ORM 模型。在数据科学与人工智能时代,Python 是连接底层异构算力(CPU、GPU、NPU)与上层复杂算法逻辑的黏合剂:
- 第一阶段(夯实基础):熟练掌握
NumPy的广播机制与矩阵轴(axis)概念,并能够熟练使用Pandas/Polars完成数据的缺失值处理、多表关联和分组统计。 - 第二阶段(严谨建模):通过
Scikit-learn理解特征缩放、交叉验证与防数据泄漏的Pipeline理念;掌握LightGBM快速解决业务中的结构化预测问题。 - 第三阶段(深度学习核心):深入
PyTorch的张量运算与自动微分(autograd)机制,能够编写自定义nn.Module与训练评估循环。 - 第四阶段(现代大模型实践):熟练借助
Hugging Face Transformers快速复用业界前沿开源权重,并使用vLLM实现高吞吐生产推理部署,结合LlamaIndex搭建企业知识库检索。
通过这套层层递进的技术栈,开发者可以跨越传统的 Web CRUD 逻辑,真正构建起能够从海量数据中挖掘价值、具备智能决策与推理能力的现代化计算系统。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









