

为什么团队搭建Python环境开始改用uv而不是conda?
深度解析为什么越来越多的技术团队在搭建 Python 环境时选择用 uv 替代传统的 conda。从底层解析性能、跨平台锁文件机制、标准生态兼容性到团队 CI/CD 落地实践,全景对比两者的核心差异与迁移路径。
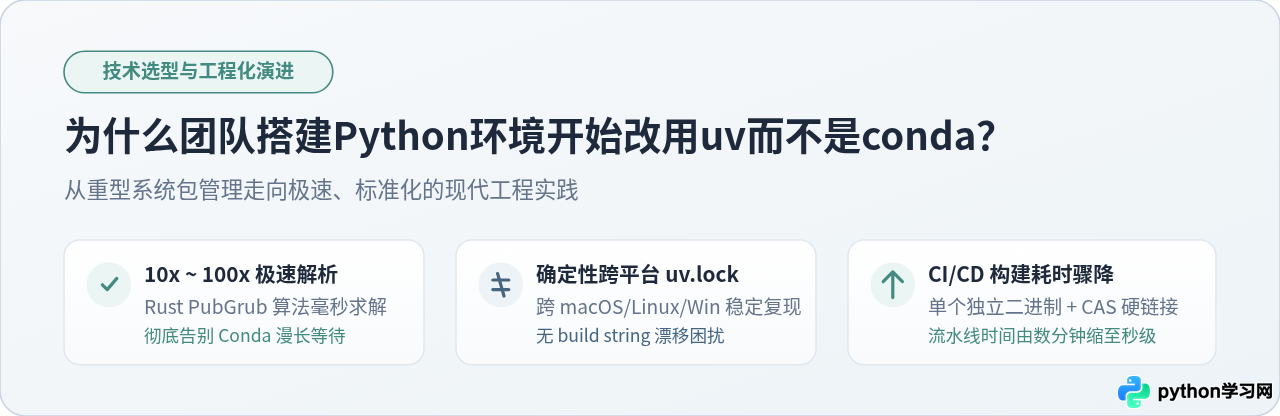
越来越多的团队在搭建 Python 环境时选择改用 uv 替代传统的 conda,核心原因在于:uv 提供了相较 Conda 提升 10 至 100 倍的极致解析与安装速度、严格基于 PEP 规范的标准跨平台锁文件(uv.lock),以及将 CI/CD 构建和容器部署耗时从数分钟压缩至数秒的工程化能力。随着现代 PyPI 预编译轮子(Wheel)与独立 CUDA 轮子生态的完善,Conda 曾经不可替代的系统级二进制打包优势在主流 Web 服务、微服务和机器学习研发中已不再是刚需,而其解析缓慢、环境漂移和包体积臃肿的痛点则日益阻碍团队敏捷交付。
一、底层定位差异:系统跨语言管理 vs 现代 Python 工程链
要理解团队选型的根本转变,首先需要厘清 Conda 与 uv 在设计出发点上的本质区别:
- Conda(全系统/跨语言二进制包管理器):诞生于 Python 数据科学早期(2012年前后)。当时跨平台编译 C/C++、Fortran 科学计算库(如 NumPy、SciPy、GDAL、BLAS)门槛极高,pip 的 Wheel 二进制分发格式尚未普及。Conda 的核心定位是将 Python 解释器、C 系统动态库、编译器乃至非 Python 工具整合在一个私有仓库(Defaults / Conda-Forge)中整体分发。
- uv(现代 Python 工程化项目与环境管理器):由 Astral 团队使用 Rust 研发,基于现代 Python 官方标准(PEP 508、PEP 517、PEP 621)构建。它不仅充当极速 pip 替代品,更统一接管了 Python 解释器下载、虚拟环境创建、依赖树求解、跨平台依赖锁定以及命令行工具运行,是一站式的现代工程底座。
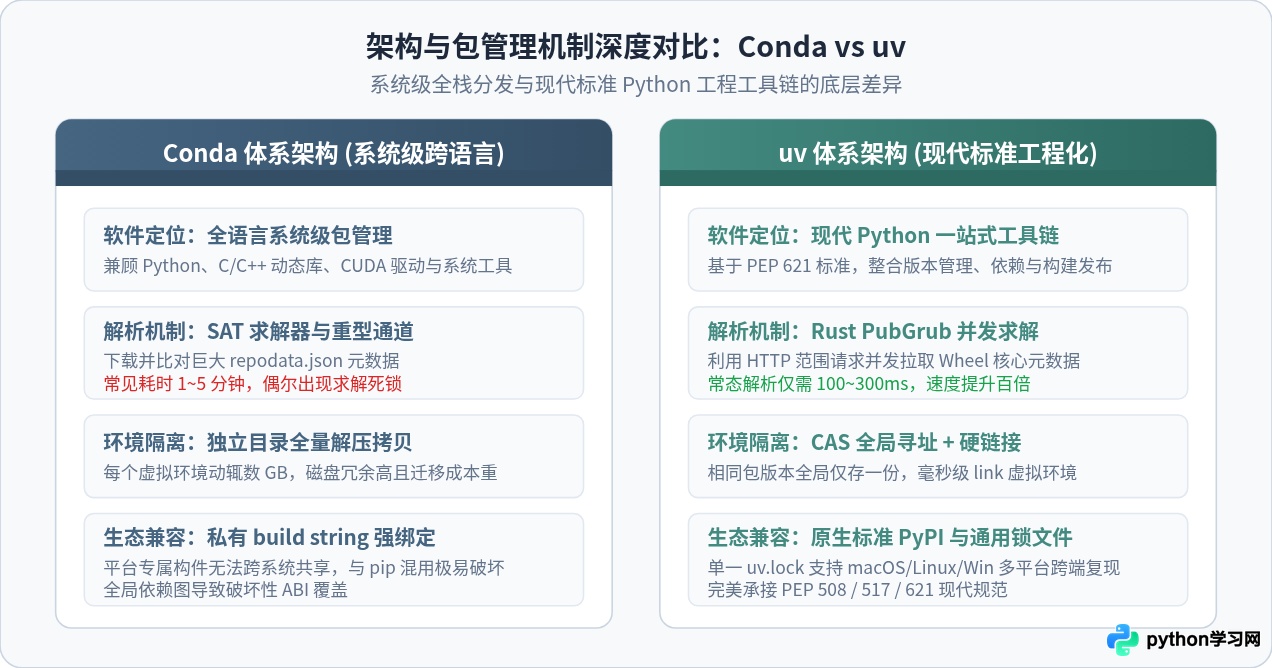
从底层机制来看,Conda 将 Python 视为整个操作系统依赖树中的普通节点,其求解器必须考虑底层动态链接库的相容性;而 uv 则紧扣现代 Python 社区的 Wheel 预编译体系,借助 HTTP 范围请求并发拉取元数据,配合 PubGrub 算法在内存中毫秒级求出最优解。这种架构层面的解耦让 uv 的效率带来了质的飞跃。
二、驱动团队放弃 Conda 的四大核心痛点
在企业与多人员协作项目中,Conda 长期积累的工程短板直接影响了研发周期的每个环节,主要表现为以下四个突出痛点:
1. 依赖解析耗时呈指数级增长
Conda 采用经典的 SAT 求解器。每当环境中的包数量增多或引入复杂科学计算库时,求解器需要比对全量 repodata.json 元数据。在日常开发中,执行一次 conda install 或 conda env create 耗时 2 至 5 分钟属于家常便饭,甚至频繁遭遇死锁卡死。相比之下,uv 利用 Rust 语言的并发能力与优化的 PubGrub 算法,将数百个依赖的解析压缩在 200 至 500 毫秒 内完成,彻底消除了等待感。
2. 跨平台协作中的“环境漂移”与不可复现
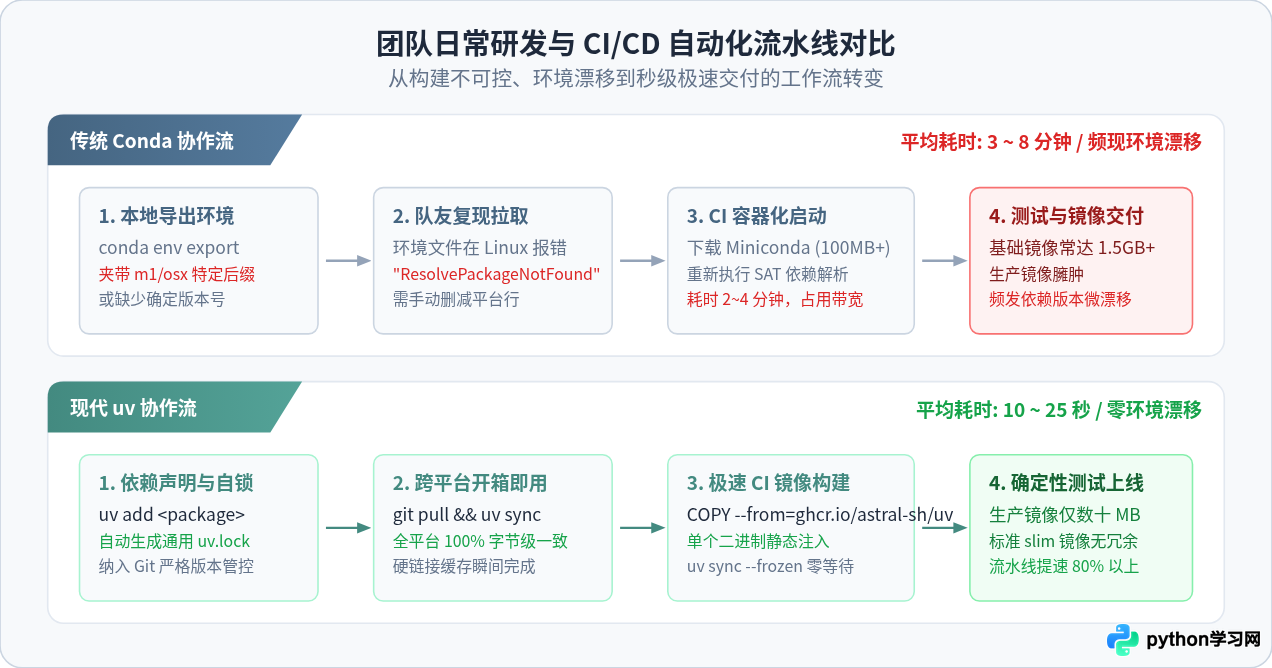
团队成员的开发设备往往涵盖 macOS(Apple Silicon)、Linux 研发机与 Windows。使用 Conda 导出的 environment.yml 通常包含平台特定的构建哈希字符串(如 py310h5eee18b_0 或 osx-arm64 标识),这导致一份在 Mac 本地导出的配置文件直接在 Linux 服务器或 CI 容器中运行报错 ResolvePackageNotFound。开发者不得不花费大量时间手动清理无用字段,极易引发生产与开发环境版本微漂移。
conda env export > environment.yml 后,队友在 Ubuntu 运行 conda env create -f environment.yml 时经常中断,因为该文件锁定了 macOS 特有的二进制包版本。
3. 混用 pip 与 conda 导致的 ABI 破坏与环境崩溃
许多最新的深度学习库、私有包或内部 SDK 仅发布在 PyPI 上。团队在 Conda 环境中执行 pip install 是常见操作,但由于 Conda 和 pip 拥有独立的元数据记录体系,后续一旦再次运行 conda update,Conda 很容易静默覆盖或破坏 pip 安装的底层共享库,最终造成难以排查的 Segmentation fault 或动态库符号缺失错误。
4. 容器化部署与 CI/CD 资源的巨大浪费
在云原生部署与微服务流水线中,镜像体积与冷启动速度直接决定了发布效率:
- Conda 容器:即便使用 Miniconda,基础镜像也在数百兆,完整装配后镜像动辄 1.5GB ~ 3GB。CI 流水线每跑一次测试都要重新下载大包解压,拖慢构建时效。
- uv 容器:uv 自身是单个静态编译二进制文件(约 30MB),支持多阶段 Docker 构建。通过硬链接缓存与
uv sync --frozen,容器镜像仅保留运行时必需的site-packages,最终镜像体积可控制在普通 Debian-slim 或 Alpine 水平(100MB 左右)。
三、从 Conda 迁移到 uv 的标准实操指南
迁移至 uv 并不需要颠覆现有业务代码。uv 完全遵循现代 Python 社区的标准规范,迁移过程主要分为四个清晰步骤:
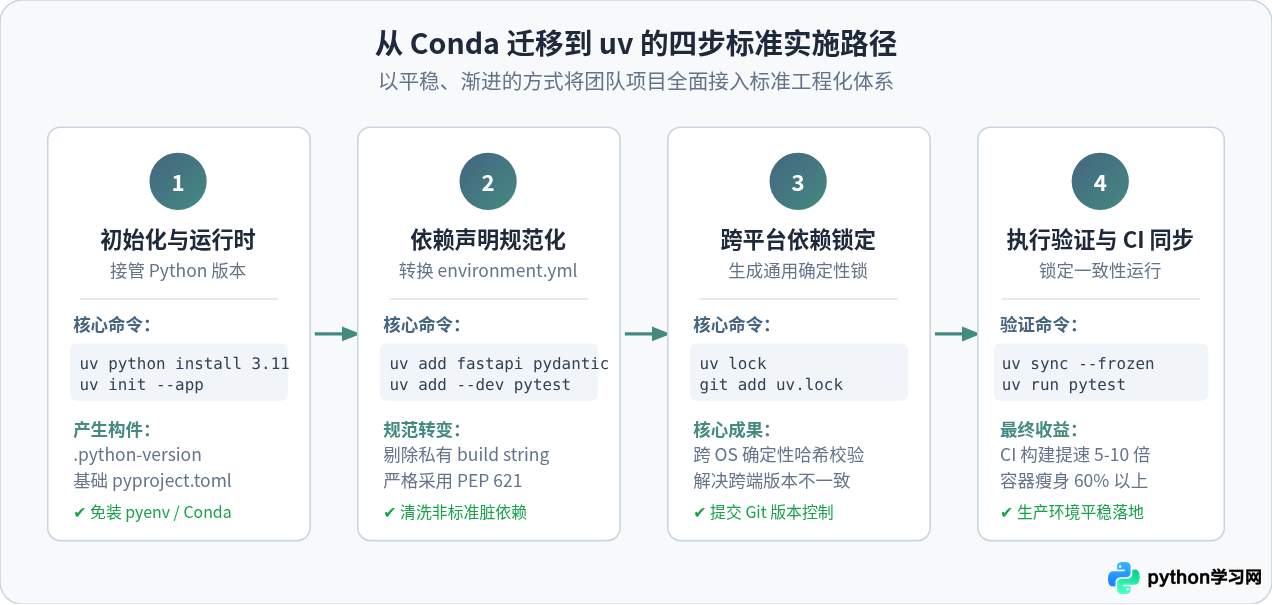
步骤一:安装 uv 并声明目标 Python 版本
uv 支持独立管理 Python 运行时,团队无需再依赖 Conda 或全局安装的 pyenv:
# 1. 安装 uv(macOS / Linux)
curl -LsSf https://astral.sh/uv/install.sh | sh

# 2. 安装指定版本的独立 Python 运行时(不会污染系统)
uv python install 3.11

# 3. 在项目根目录初始化现代项目结构
uv init --app my-project
cd my-project
该操作会在项目下生成 .python-version 文件,固定团队所使用的 Python 解释器大版本。
步骤二:整理原有的依赖并写入 pyproject.toml
放弃臃肿的 environment.yml,通过 uv add 录入核心业务依赖。uv 会自动将它们格式化写入符合 PEP 621 规范的 pyproject.toml:
# 添加生产业务依赖
uv add "fastapi>=0.110.0" "uvicorn[standard]" "pydantic>=2.6" "requests"

# 区分开发与测试依赖(例如单元测试、代码格式化工具)
uv add --dev pytest pytest-asyncio ruff mypy
此时生成的 pyproject.toml 内容清晰标准:
[project]
name = "my-project"
version = "0.1.0"
description = "Team microservice project"
readme = "README.md"
requires-python = ">=3.11"
dependencies = [
    "fastapi>=0.110.0",
    "pydantic>=2.6",
    "requests",
    "uvicorn[standard]",
]

[dependency-groups]
dev = [
    "mypy",
    "pytest",
    "pytest-asyncio",
    "ruff",
]
步骤三:生成团队统一的跨平台锁定文件 uv.lock
运行 uv lock 命令,uv 的并发求解器会在零点几秒内计算出所有直接与间接依赖的确定版本,并生成统一的 uv.lock:
# 生成平台无关的确定性跨平台锁文件
uv lock

# 将 pyproject.toml 和 uv.lock 提交至版本控制系统
git add pyproject.toml uv.lock .python-version
git commit -m "chore: migrate project environment from conda to uv"uv.lock 采用统一的 Universal Lockfile 机制。同一份锁文件同时包含了对 Linux、macOS(Intel & ARM)、Windows 的兼容哈希,保证任何团队成员 git pull 之后安装的依赖字节级完全一致。
步骤四:本地运行验证与 CI/CD 落地
本地运行任何指令无需手动 source activate,直接使用 uv run 执行,系统会自动确保依赖已处于最新同步状态:
# 本地运行测试用例(自动加载虚拟环境)
uv run pytest tests/

# 本地启动开发服务器
uv run uvicorn app.main:app --reload
在 CI/CD 流水线(如 GitHub Actions 或 GitLab CI)与 Docker 构建中,使用 --frozen 参数可严格锁定依赖版本,杜绝未授权的升级:
# Dockerfile 推荐示范:极速多阶段构建
FROM python:3.11-slim AS builder

# 复制官方静态 uv 二进制文件
COPY --from=ghcr.io/astral-sh/uv:latest /uv /bin/uv

WORKDIR /app
COPY pyproject.toml uv.lock ./

# 同步生产依赖到系统或隔离目录(--frozen 禁止变更锁文件,--no-dev 剔除调试包)
RUN uv sync --frozen --no-dev --no-install-project

COPY . .

CMD ["uv", "run", "uvicorn", "app.main:app", "--host", "0.0.0.0", "--port", "8000"]
四、技术选型决策与边界:Conda 还有存在价值吗?
尽管 uv 在绝大部分软件工程和主流数据研发中展现了全面优势,但在做技术决策时,团队仍需理性评估边界条件:
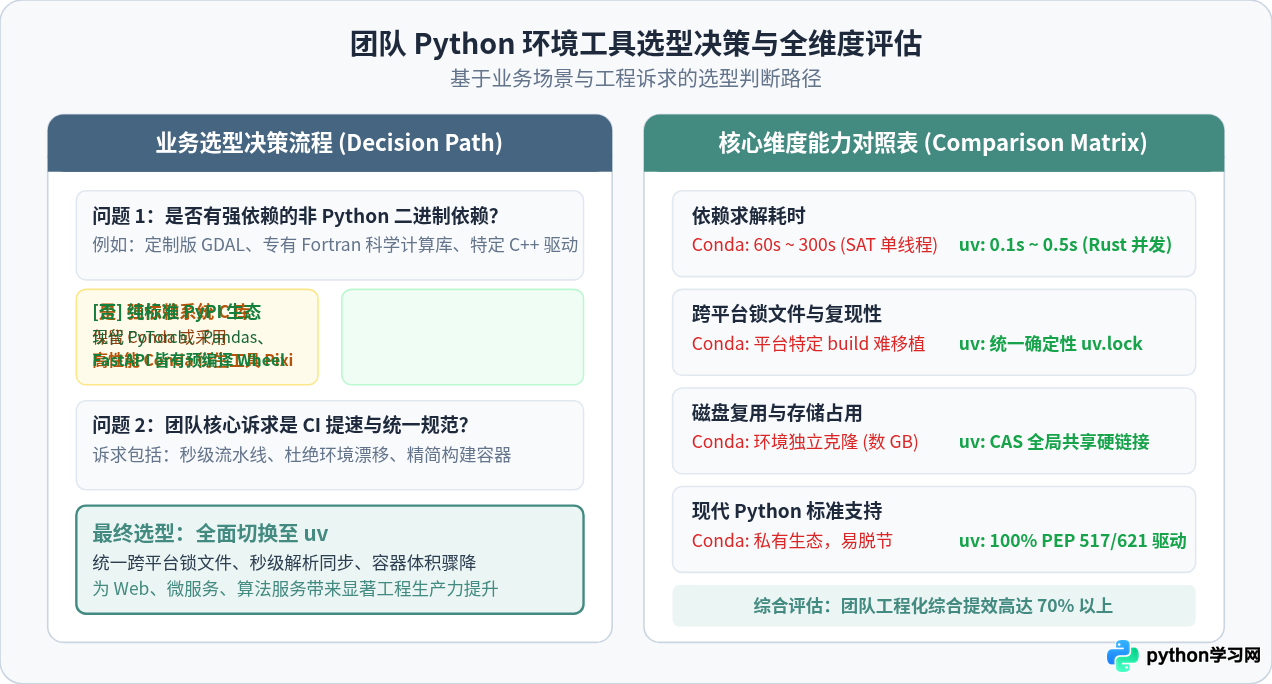
1. 什么时候依然应该留在 Conda 生态?
- 项目深度依赖未打包进 Wheel 的非 Python 二进制底层库:例如特定版本的非标准 GIS/GDAL 库、专有编译的 Fortran/C++ 数值模拟软件、生物信息学专用命令行工具集等。此类工具在 PyPI 上没有可直接运行的 Wheel,必须由 Conda 等跨语言包管理器负责链接系统级依赖。
- 提示:若此类项目希望获得如 uv 般快速的解析体验,可以考虑采用同属 Conda 生态但使用 Rust 重写的高性能工具 Pixi。
2. PyTorch 与 GPU 驱动在 uv 下如何配置?
过去很多算法团队坚守 Conda 是为了 conda install pytorch torchvision pytorch-cuda=11.8 -c pytorch -c nvidia。如今 PyTorch 官方已提供极其完善的独立 CUDA Wheel。在 uv 中只需在 pyproject.toml 中配置 PyTorch 官方额外索引,即可享受纯净极速的 GPU 依赖安装:
# 声明使用 PyTorch 官方 CUDA 12.1 预编译轮子
[[tool.uv.index]]
name = "pytorch-cu121"
url = "https://download.pytorch.org/whl/cu121"
explicit = true

[tool.uv.sources]
torch = { index = "pytorch-cu121" }
torchvision = { index = "pytorch-cu121" }
五、总结:工程化提效的关键指标复盘
核心复盘与收益总结
| 评估维度 | Conda (传统模式) | uv (现代工程模式) | 团队实际收益 |
|---|---|---|---|
| 依赖解析耗时 | 1 ~ 5 分钟 (SAT 串行) | 0.1 ~ 0.5 秒 (PubGrub 并发) | 本地迭代与构建无需等待,效率提升 10-100x |
| 跨平台环境一致性 | 容易产生 build string 平台漂移 | 确定性跨平台 uv.lock |
彻底消除“在我机器上是好的”问题 |
| 磁盘空间占用 | 每个环境全量拷贝,动辄数 GB | CAS 全局缓存 + 硬链接秒级复用 | 开发者硬盘与 CI 缓存节省 70% 以上空间 |
| CI/CD 与容器化交付 | 镜像臃肿,冷启动漫长 | 单个静态二进制,秒级冻结同步 | 流水线时间减少 80%,容器轻量化 |
| 生态规范依从度 | 私有渠道与专有格式,易与 pip 冲突 | 100% 遵循 PEP 517 / 621 标准 | 与现代 Python 社区工具链无缝融合 |
团队从 Conda 走向 uv,本质上是从“重型多语言系统管理”回归到“标准、敏捷、可复现的现代 Python 工程体系”。对于绝大多数从事 Web 后端开发、微服务架构、通用数据科学分析以及现代深度学习模型研发的团队而言,改用 uv 带来的构建提速与协作确定性,已经成为提升研发体验与工程交付质量的确定性选择。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









