

Python生成1到100范围内100个不重复随机数
详细讲解在Python中生成1到100范围内100个不重复随机数的高效方法,涵盖random.sample、random.shuffle算法原理、性能对比及常见避坑指南。
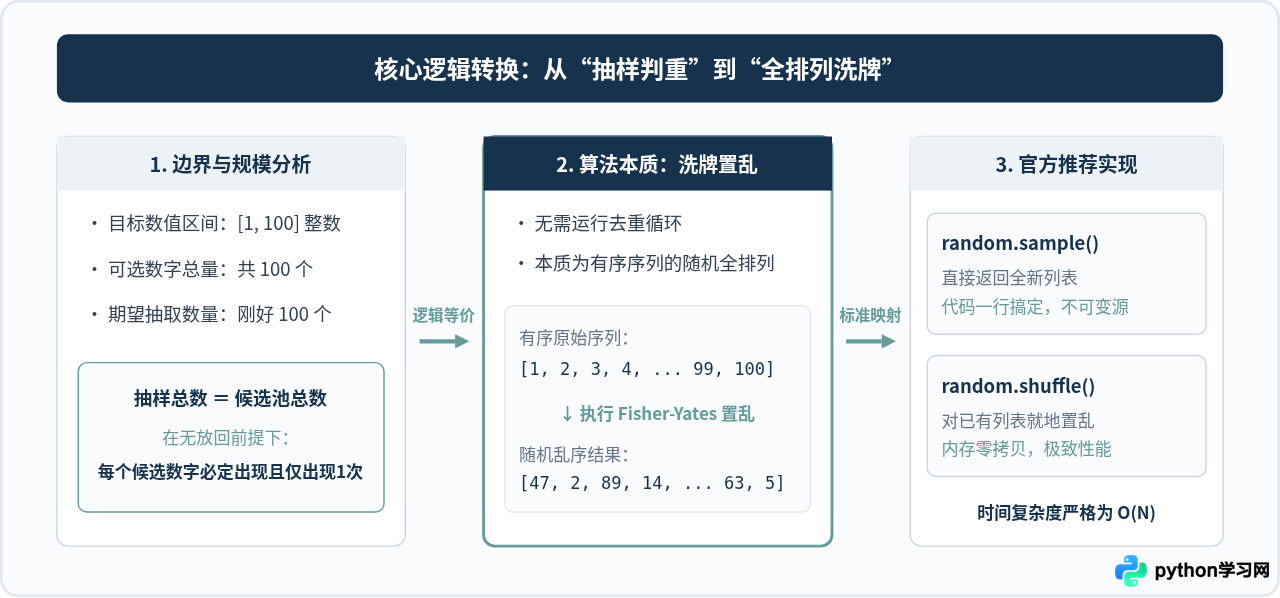
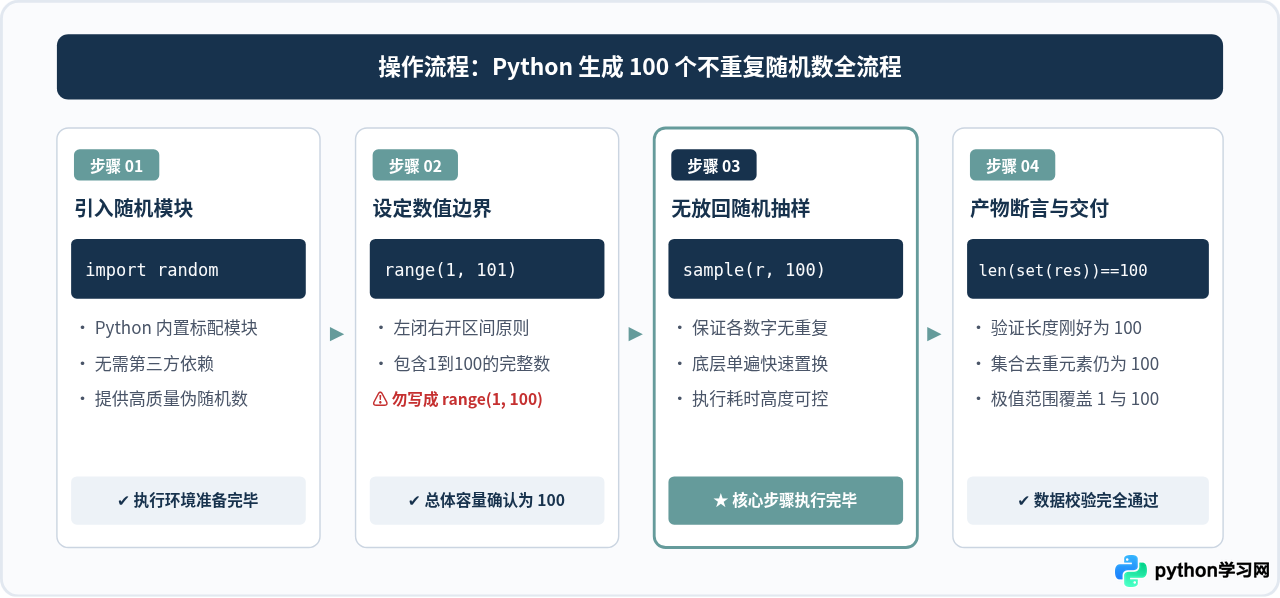
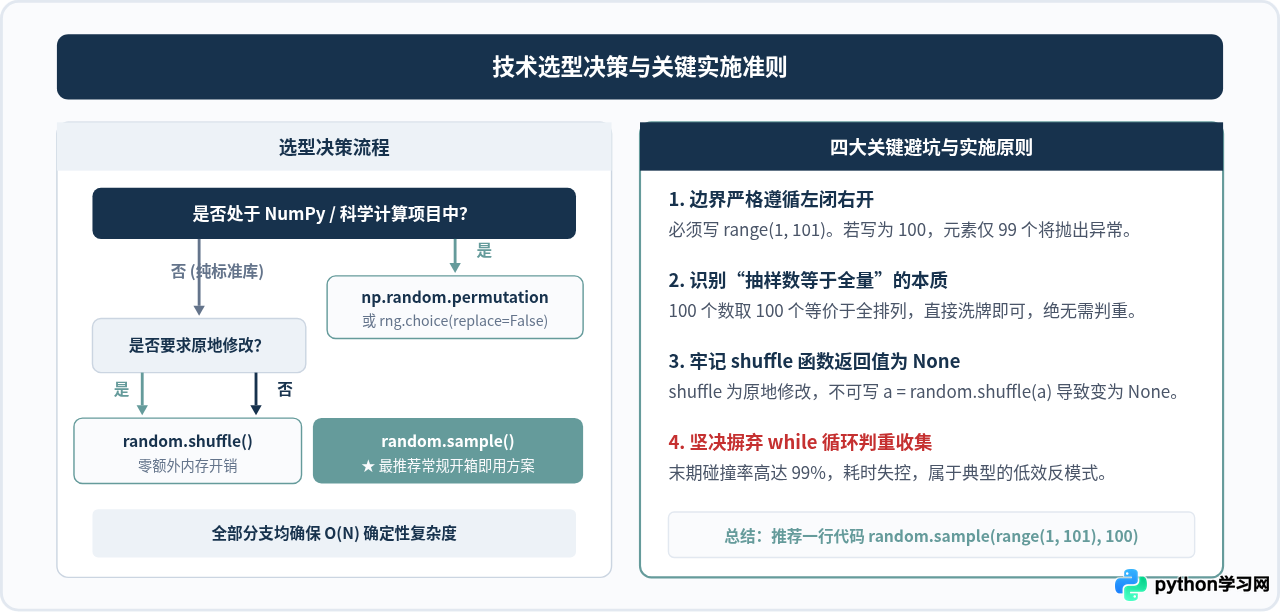
在 Python 中生成 1 到 100 范围内 100 个不重复的随机数,最推荐且最规范的方法是直接使用标准库的 random.sample(range(1, 101), 100),或者构造列表后调用 random.shuffle() 进行原地洗牌。理解这个问题的核心在于看清其数学本质:1 到 100 之间共有 100 个整数,要求“无重复地取出 100 个数”,在逻辑上等价于对这 100 个数字做一次随机全排列,而无需在循环中反复产生随机数再手动去重。
一、首选方案:使用 random.sample()
对于绝大多数日常开发,最直接且不易出错的方案是调用 Python 内置 random 模块的 sample() 函数。它专门用于从给定的总体(population)中进行无放回抽样(sampling without replacement)。
1. 完整实现代码
import random

# 使用 range(1, 101) 构建 1 到 100 的区间,抽样数量指定为 100
random_numbers = random.sample(range(1, 101), 100)

# 输出前 10 个数字作为示例观察
print("生成的列表长度:", len(random_numbers))
print("前 10 个随机数示例:", random_numbers[:10])
2. 关键细节解析
- 左闭右开区间:在 Python 中,
range(start, stop)遵循“左闭右开”规则,包含start但不包含stop。因此,要覆盖 1 到 100,第二个参数必须写为101。如果误写成range(1, 100),区间内实际只有 99 个数(1 到 99)。 - 越界安全保护:如果候选池数量小于抽取数量,
random.sample()会直接抛出ValueError: Sample larger than population or is negative,这从机制上保证了抽样结果绝不会产生重复或填充伪数据。 - 独立副本:
sample()会返回一个全新的list实例,原序列或范围对象不受任何影响。
二、原地修改方案:使用 random.shuffle()
如果当前环境中已经维护了一个现成的列表,或者对内存分配非常敏感,使用 random.shuffle() 是最理想的方案。
1. 完整实现代码
import random

# 1. 显式构造包含 1 到 100 的列表
numbers = list(range(1, 101))

# 2. 原地随机打乱列表元素的排列顺序
random.shuffle(numbers)

# 3. 查看洗牌后的前 10 个元素
print("打乱后的前 10 个数字:", numbers[:10])
2. 原理与注意事项
random.shuffle() 采用经典的 Fisher-Yates 洗牌算法(也称 Knuth 洗牌算法)。其主要优势包括:
- 时间复杂度 O(N):算法从列表末尾向前遍历,每次将当前位置元素与随机选取的一个前方未处理位置元素进行交换,仅需一次遍历即可完成无偏置随机打乱。
- 原地置乱(In-place):直接修改传入的列表对象,不创建新的列表实例,空间复杂度为常数级 O(1)。
- 返回值是 None:初学者容易犯的一个错误是写出
numbers = random.shuffle(numbers)。由于该函数在设计上修改原列表并返回None,这样赋值会导致变量变为None。正确的做法是单独调用该函数。
三、常见误区:为什么不要用 while 循环与 set 过滤
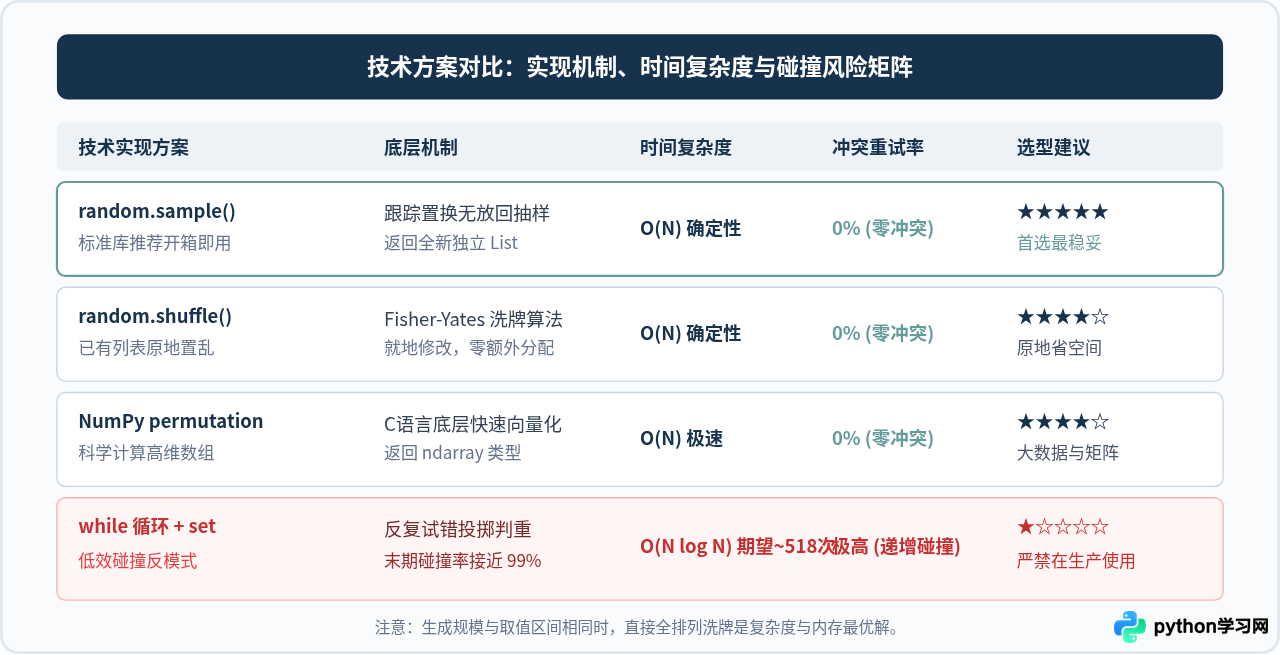
初学编程时,部分读者可能会直觉性地采用“不断生成单个随机数,塞入集合(set)直到凑满 100 个”的思路。尽管这种写法最终也能得到结果,但在工程实践中属于严重的反面模式。
import random

# 不推荐的低效写法
collected = set()
while len(collected) < 100:
    collected.add(random.randint(1, 100))

result = list(collected)
1. 为什么这种写法不可取?
- 遭遇“赠券收集问题”(Coupon Collector's Problem):当集合中已有 90 个数字时,下一次生成数字不重复的概率只有 10%;当集合中已有 99 个数字时,生成最后一个未出现数字的概率仅为 1/100。为了拿到最后那一个数,期望需要生成 100 次随机数。
- 运算次数激增与不确定性:数学期望表明,生成 100 个互不相同的数需要调用
randint约100 × (1/1 + 1/2 + ... + 1/100) ≈ 518.7次。若在极其极端的情况下,循环耗时甚至无法事先预估。 - 破坏乱序特性:集合转回列表时,在某些 Python 内部哈希实现机制下,较小整数可能会按特定哈希桶槽位输出,从而失去了均匀打乱的效果。
四、扩展场景:科学计算中的 NumPy 实现
如果项目本身依赖数据科学或机器学习工具链(例如涉及 Pandas 或 PyTorch),使用 NumPy 往往更加契合,且底层为 C 语言优化,执行效率极高。
import numpy as np

# 方式一:直接生成打乱的排列数组
arr = np.random.permutation(np.arange(1, 101))
print("NumPy 随机排列示例:", arr[:10])

# 方式二:使用官方推荐的新一代 Generator API (NumPy 1.17+)
rng = np.random.default_rng()
arr_gen = rng.choice(np.arange(1, 101), size=100, replace=False)
print("Generator 无放回抽样示例:", arr_gen[:10])
在 NumPy 的 choice 中,显式指定 replace=False 即代表进行无放回抽样。生成的对象为 ndarray,可直接无缝对接后续矩阵运算与统计分析。
五、结果验证与完整断言脚本
在编写自动化脚本或单元测试时,可以通过以下一组断言语句完整检验生成的结果是否符合要求:
import random

# 生成结果
result = random.sample(range(1, 101), 100)

# 1. 验证数量刚好为 100
assert len(result) == 100, "列表长度应为 100"

# 2. 验证元素互不重复(转为 set 后长度仍为 100)
assert len(set(result)) == 100, "存在重复元素"

# 3. 验证范围覆盖 1 到 100
assert min(result) == 1, "最小值必须为 1"
assert max(result) == 100, "最大值必须为 100"

# 4. 验证全部元素均为整数
assert all(isinstance(x, int) for x in result), "列表中应全部为整数"

print("全部断言校验通过!结果完全符合要求。")
总结
在 Python 中生成 1 到 100 范围内的 100 个不重复随机数,本质上是对连续整数序列进行全排列。最简捷高效的方法是使用 random.sample(range(1, 101), 100),若需原地操作则使用 random.shuffle(list(range(1, 101)))。两种方案均能在 $O(N)$ 时间复杂度内可靠完成,既简洁优雅,又规避了低效循环去重的性能缺陷。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









