

NumPy 数组切片与 Python 原生列表切片的区别
深入对比NumPy数组切片与Python原生列表切片的核心区别,解析视图(View)与副本(Copy)的内存机制、多维切片语法差异、性能表现及避免数据意外污染的最佳实践。
在 Python 数据处理中,切片(Slicing)是截取序列局部元素最常用的基础操作。很多刚从 Python 原生列表转向 NumPy 的开发者,往往会下意识地认为两者的切片行为是一样的。但实际上,Python 原生列表切片会创建全新的独立列表(浅拷贝),而 NumPy 数组切片默认返回的是原数组的“视图”(View)。这一核心机制差异不仅决定了修改切片是否会波及原数据,还在高维多轴索引、内存占用和运行性能上带来了截然不同的表现。
一、核心机制差异:浅拷贝与共享视图
理解这两种切片区别的钥匙,在于计算机底层的内存组织方式。Python 原生列表是一个动态指针数组,其中保存着各个独立 Python 对象的引用;而 NumPy 的 ndarray 则是面向高性能连续数值计算设计的结构体,包含元数据头(Header)与连续数据缓冲区(Data Buffer)。
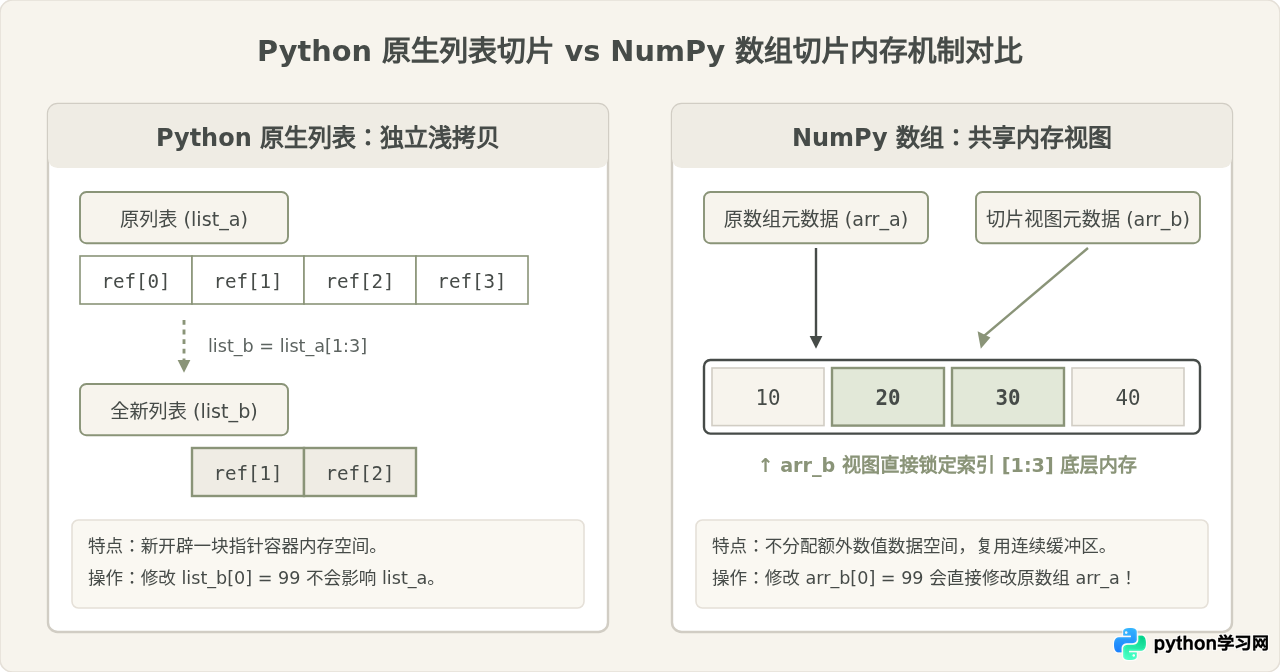
当执行 Python 原生列表切片 sub_list = original_list[1:3] 时,解释器会新开辟一块内存空间,创建一个全新的 list 容器对象,并将对应切片区间的对象引用依次复制过去。因为新旧列表是两个完全独立的容器,所以在切片结果上增删元素或重新给元素赋值,都不会修改原列表的结构和内容。
与此相对,NumPy 切片 sub_arr = original_arr[1:3] 默认绝不复制底层的数值数据。NumPy 只创建了一个新的数组描述符(包含形状 shape、步幅 strides 和数据起始指针),它直接指向原始数组相同的底层连续内存区域。这种轻量级的指针引用在 NumPy 中被称为视图(View)。
二、代码实证:数据修改的联动效应
通过可运行的代码,可以直观验证两者在数据赋值时的根本分歧。在原生 Python 列表中,对切片赋值只能影响切片变量本身:
# Python 原生列表切片示例
raw_list = [10, 20, 30, 40, 50]
sliced_list = raw_list[1:4]

# 修改切片中的元素
sliced_list[0] = 999

print("切片列表:", sliced_list)  # 输出: [999, 30, 40]
print("原始列表:", raw_list)     # 输出: [10, 20, 30, 40, 50] (完全没有受到影响)
但在 NumPy 中,由于 sliced_arr 是原始数组的视图,修改切片中的数据就等于直接修改原始内存位置:
import numpy as np

# NumPy 数组切片示例
raw_arr = np.array([10, 20, 30, 40, 50])
sliced_arr = raw_arr[1:4]

# 修改切片中的元素
sliced_arr[0] = 999

print("切片数组:", sliced_arr)  # 输出: [999, 30, 40]
print("原始数组:", raw_arr) # 输出: [ 10 999 30 40 50] (原数组被同步改写!)很多初学者在编写函数时,将 NumPy 数组切片作为局部变量传递给预处理逻辑。如果该逻辑内部存在原地修改(例如 sub_arr += 1 或 sub_arr[sub_arr < 0] = 0),外部传入的整个原始大数组就会在不知不觉中被篡改。如果不希望影响原数据,必须显式调用 .copy() 方法。
三、多维切片与语法支持对比
除了内存机制,另一个显著区别在于多维数据的截取能力。Python 列表只能支持一维连续序列,如果想要表达矩阵或高维数据,通常需要使用“列表的列表”(嵌套列表)。
1. 嵌套列表切片的链式陷阱
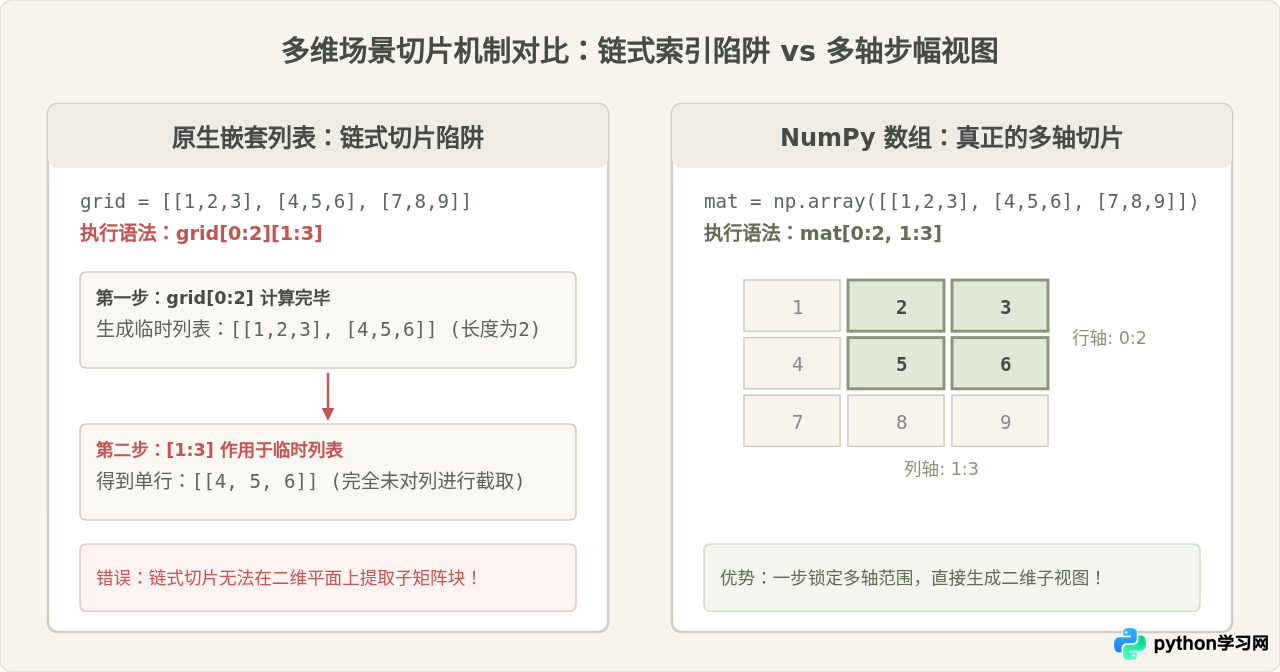
在面对嵌套列表时,初学者常常尝试使用类似 matrix[0:2][1:3] 的语法,希望能提取第 0 到 1 行、第 1 到 2 列的二维子矩阵。但这在 Python 原生语法中是完全无效的。
因为 matrix[0:2] 首先执行,生成了一个仅包含前两行的临时新列表;紧接着的 [1:3] 是对这个只有 2 个元素的临时列表按行索引切片,其结果仅仅是取出了第二行,根本没有在列维度进行任何筛选。要想截取二维切片,原生列表必须借助列表推导式:[row[1:3] for row in matrix[0:2]],书写繁琐且运行极其缓慢。
2. NumPy 原生高维多轴切片
NumPy 原生支持多维多轴切片,只需要用逗号隔开各个维度的切片范围,形式为 arr[行切片, 列切片, ...]。NumPy 在底层通过步幅(Strides)计算行跨度和列跨度,瞬间完成跨维度的视图映射。
import numpy as np

# 二维矩阵切片对比
matrix = np.array([
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
])

# 提取前两行的第 1 到 2 列
sub_matrix = matrix[0:2, 1:3]

print(sub_matrix)
# 预期且正确的输出:
# [[2 3]
#  [5 6]]
四、性能与内存消耗:O(1) 瞬时创建与 O(k) 拷贝
机制上的根本差异直接映射到运行开销上。原生列表的切片因为需要开辟新内存并复制包含 $k$ 个指针的引用数组,其时间复杂度和空间复杂度均为 $O(k)$,其中 $k$ 为切片长度。
而在 NumPy 中,切片操作无论截取的是 10 个元素还是 1 亿个元素,由于只创建了一个小巧的 ndarray 对象头(Header),并直接复用原始的数据缓冲区指针,其时间复杂度和额外内存占用均为稳定的 $O(1)$ 常数级。
| 对比维度 | Python 原生列表切片 | NumPy 数组基础切片 |
|---|---|---|
| 生成对象性质 | 独立的新 list 容器对象(浅拷贝引用) |
原数组的数据视图(View,共享内存) |
| 修改元素影响 | 修改切片元素不影响原列表 | 修改切片元素直接改变原数组 |
| 时间复杂度 | $O(k)$,与切片提取的元素量成正比 | $O(1)$,微秒级常数时间完成 |
| 额外内存消耗 | $O(k)$,需开辟存储所有引用指针的数组空间 | $O(1)$,仅需约数十字节的描述符头信息 |
| 多维切片支持 | 不支持原生多轴切片,链式切片逻辑受限 | 原生支持逗号分隔多轴切片 arr[0:2, 1:4] |
| 步长反转与跨步 | 支持 list[::-1](复制出新列表) |
支持 arr[::-1](仅翻转步长 strides,无复制) |
五、视图还是拷贝?判断方法与排查流程
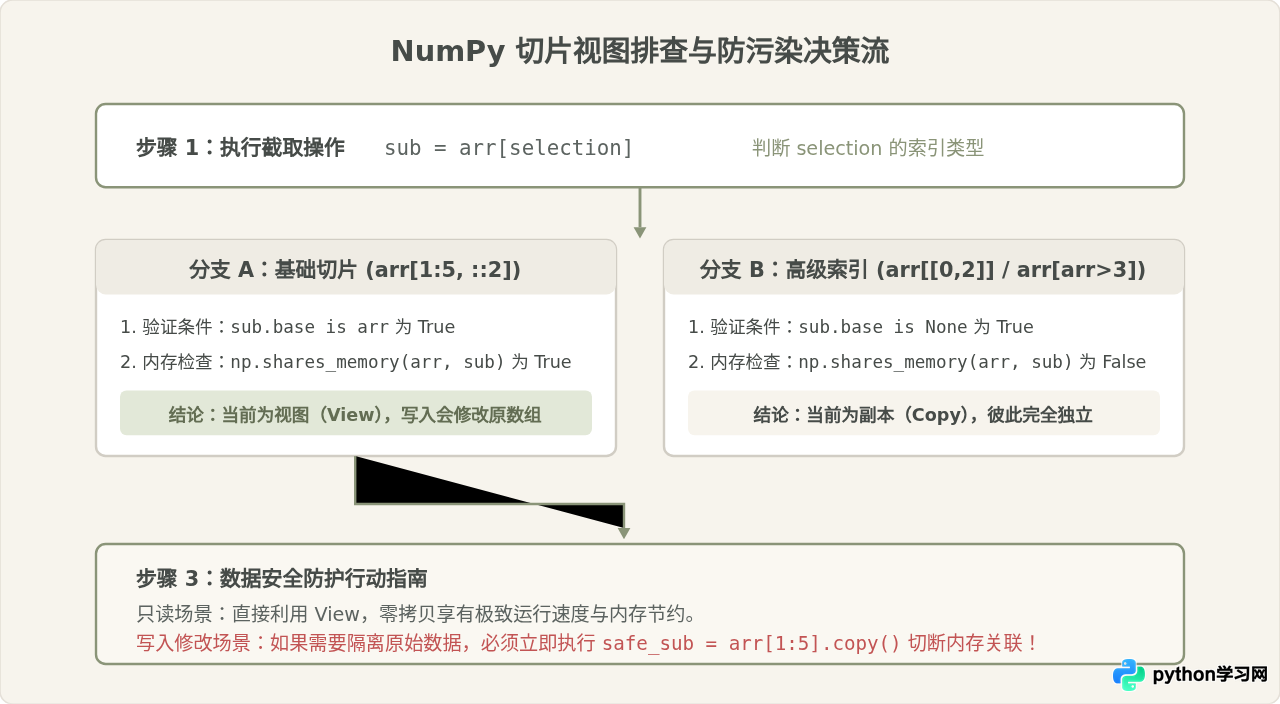
在 NumPy 的实际使用中,并非所有索引操作返回的都是视图。NumPy 存在两套索引规则:基础切片(Basic Slicing)与高级索引(Advanced / Fancy Indexing)。必须清楚如何判断手头的数组到底与原数组共享内存,还是已经变成了独立的拷贝。
- 基础切片(返回视图):使用常规冒号范围
arr[start:stop:step],或者多维的arr[1:3, :],返回视图。 - 高级索引(返回拷贝):使用整数列表、整数数组(如
arr[[0, 2]])或布尔掩码(如arr[arr > 5])作为索引时,NumPy 无法通过简单的固定步幅来表达非连续数据,因此会**触发数据深拷贝**,生成完全独立的数组!
代码验证内存归属
要在代码中确切确认一个 NumPy 数组是否是切片视图,可以使用以下两种官方推荐的标准方式:
import numpy as np

arr = np.arange(10)
view_slice = arr[2:6]
copy_slice = arr[[2, 3, 4, 5]]  # 花式索引

# 方法一:检查 .base 属性
# 如果是视图,.base 会指向被切片的原数组;如果是独立拷贝,.base 为 None
print(view_slice.base is arr)   # 输出: True (确认为视图)
print(copy_slice.base is None)  # 输出: True (确认为独立副本)

# 方法二:使用 np.shares_memory() 检测物理内存重叠
print(np.shares_memory(arr, view_slice))  # 输出: True
print(np.shares_memory(arr, copy_slice))  # 输出: False
六、总结与实践建议
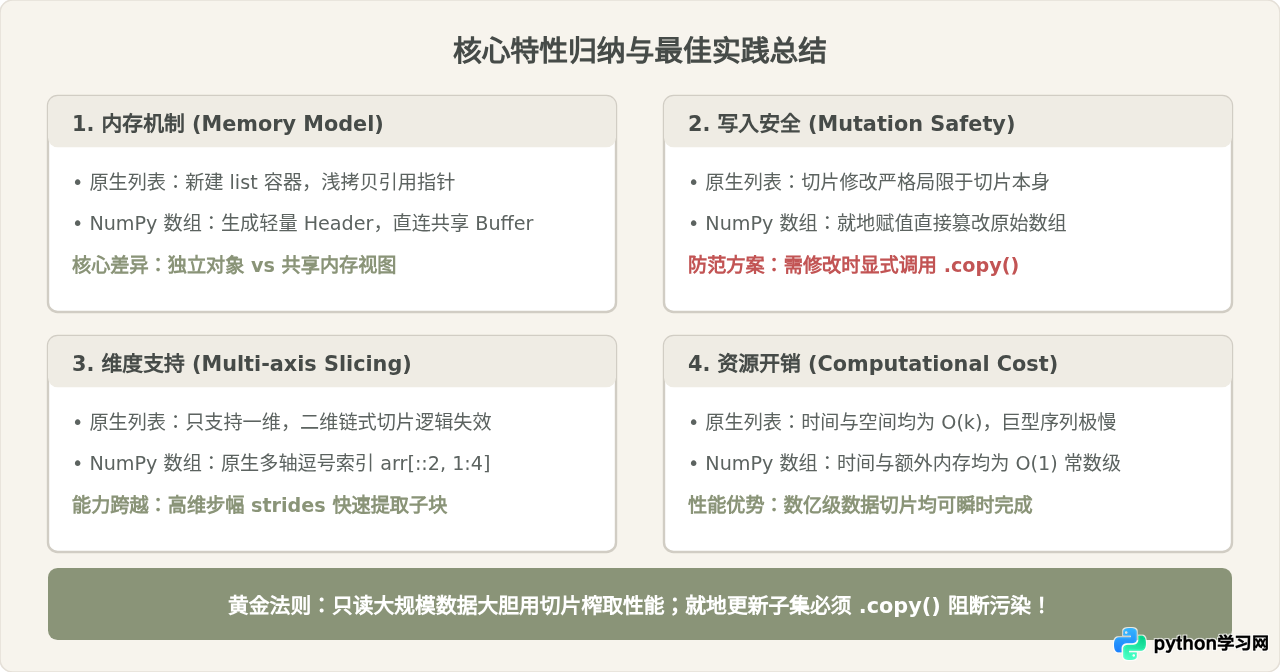
掌握 NumPy 切片与 Python 列表切片的区别,是编写高健壮性、高性能数据科学代码的必修课。简而言之,两者的设计初衷不同:Python 列表侧重通用容器的安全隔离,切片天然提供浅拷贝;NumPy 则追求工业级科学计算的极致吞吐量,以共享内存视图为基准设计。
七、常见问题解答(FAQ)
Q1:既然 NumPy 切片会联动修改原数组,为什么不默认设计成复制(Copy)?
A:NumPy 主要面向海量科学计算与机器学习场景,一个多维矩阵往往占用数百兆甚至数十吉字节的内存。如果基础切片默认进行拷贝,不仅会在瞬间耗尽服务器内存,还会产生巨大的内存分配与数据搬移 CPU 开销。通过默认视图(View),NumPy 实现了常数时间复杂度 $O(1)$ 的切片截取,将性能推到了极致。
Q2:对原生列表执行切片后,如果列表里的元素是字典或子列表,修改它们会影响原列表吗?
A:会。因为原生列表切片是“浅拷贝”(Shallow Copy),它只复制了最外层的指针数组。如果切片内部包含可变对象(如嵌套字典或嵌套列表),切片列表与原列表依然持有这些子对象的相同引用。若要实现彻底的独立,需要使用标准库的 copy.deepcopy()。
Q3:NumPy 中如果使用布尔索引,为什么不返回视图?
A:NumPy 的视图机制完全依赖固定的步幅(Strides)进行跨步寻址。布尔掩码筛选出的元素在内存中的分布通常是不规则且不连续的,无法仅凭单一的基准指针和固定步长表达,因此 NumPy 必须为匹配到的元素重新分配连续内存并进行复制。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









