

Python列表含None或混合类型导致排序报错怎么解决
在Python 3中对包含None或混合数据类型的列表进行排序时,会触发TypeError报错。本文深入剖析Python 3的类型安全比较机制,提供自定义key函数双元组映射、前置数据清洗过滤、类型分流排序等4种实用解决方案与避坑指南。
在 Python 3 中对包含 None 或混合数据类型(例如同时存在整数与字符串)的列表调用 list.sort() 或内置函数 sorted() 时,解释器会抛出形如 TypeError: '<' not supported between instances of 'NoneType' and 'int' 的异常。解决这个问题的核心路径有两条:如果 None 或不合规元素属于无效脏数据,优先在排序前通过列表推导式直接过滤;如果需要保留全部原始元素,则使用排序方法的 key 参数提供映射逻辑,将元素转换为可比较的二元组(如 (x is None, x))或统一类型,让比较在受控的规则下进行。
一、为什么会出现 TypeError 排序报错
很多从 Python 2 迁移或者初学 Python 的开发者会对这个报错感到困惑。在旧版 Python 2 中,不同类型的对象之间允许直接使用小于号 < 进行大小比较,且系统默认将 None 判定为比任意数值和字符串都要小。这种宽松的比较策略虽然避免了崩溃,但在实际工程中常常会产生难以察觉的数据偏差。
Python 3 确立了严格的类型安全设计原则:只有在双方实现了对应的富比较运算符(主要是 __lt__)且类型兼容时,才能进行大小比较。Python 默认的排序算法 Timsort 依靠元素之间成对的 < 操作来决定先后位置。当 Timsort 尝试拿 int 与 NoneType、或拿 str 与 int 比较大小时,发现两类对象均未向对方定义比较规则,因此立即触发 TypeError 并中断执行。
# 典型报错示例 1:列表中包含 None
data1 = [10, 5, None, 20]
data1.sort()
# 输出:TypeError: '<' not supported between instances of 'NoneType' and 'int'

# 典型报错示例 2:数字与字符串混合
data2 = [100, "20", 30, "apple"]
sorted(data2)
# 输出:TypeError: '<' not supported between instances of 'str' and 'int'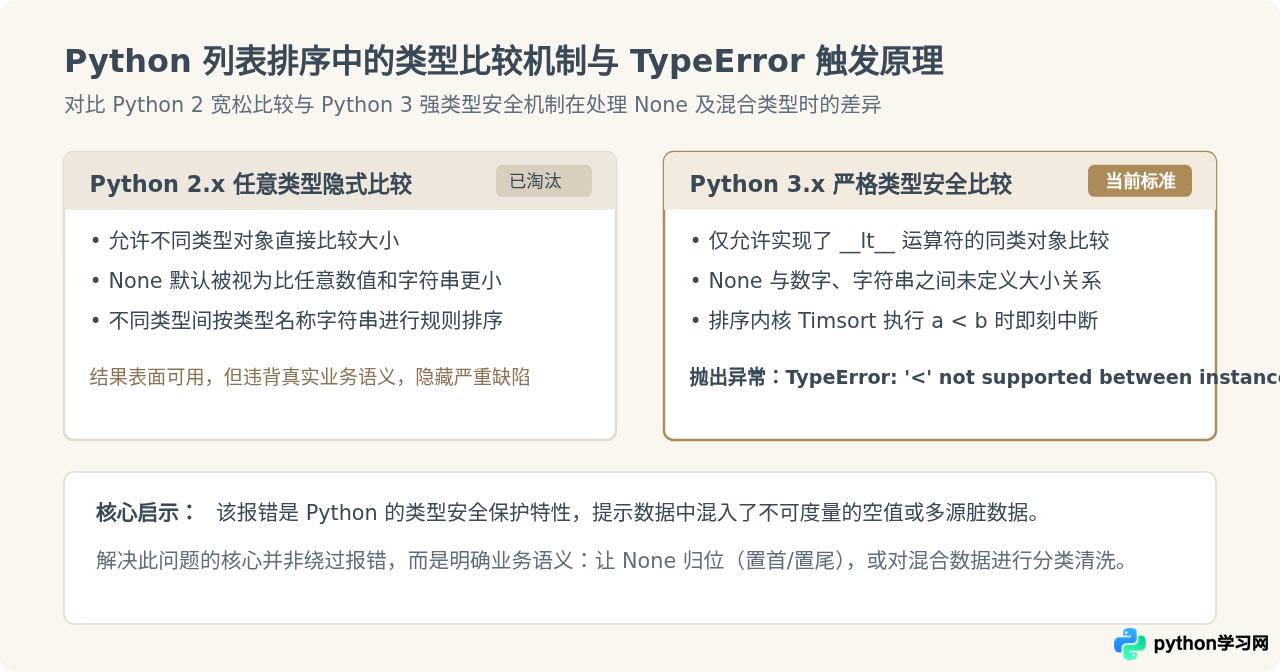
二、使用双元组 key 函数处理含 None 列表
当列表中包含 None 且业务要求保留所有元素时,最通用的方案是利用 sort(key=...) 或 sorted(..., key=...)。Python 的元组自带逐项比对特性:先比对元组第一个元素,若第一个元素已能分出胜负,则不再计算和比对后续元素(短路比较)。
1. 将 None 统一移动到列表末尾
希望正常数值升序排列,而将 None 整体推至队尾时,可以定义键函数 key=lambda x: (x is None, x)。对于正常数值,x is None 为 False;对于 None,该值为 True。由于在布尔排序中 False < True(即 0 < 1),所有非 None 元素自然排在前面。
关键在于:当两个元素都为 None 时,其元组第一项均为 True,因为相等而本应比较第二项,但此时短路机制与列表稳定性使得两个 None 无需比对第二项,完全避开了 None < None 的报错。
items = [42, None, 18, None, 7]

# 将 None 排在最后,非 None 元素按从小到大升序排序
sorted_items = sorted(items, key=lambda x: (x is None, x))
print(sorted_items)
# 输出结果:[7, 18, 42, None, None]
2. 将 None 统一移动到列表开头
如果业务需要将 None 作为占位符置于列表最前端,只需将布尔判断取反为 x is not None。此时 None 映射为 False,数值映射为 True,None 自然靠前:
items = [42, None, 18, None, 7]

# 将 None 排在最前面,非 None 元素正常升序排序
sorted_items = sorted(items, key=lambda x: (x is not None, x))
print(sorted_items)
# 输出结果:[None, None, 7, 18, 42]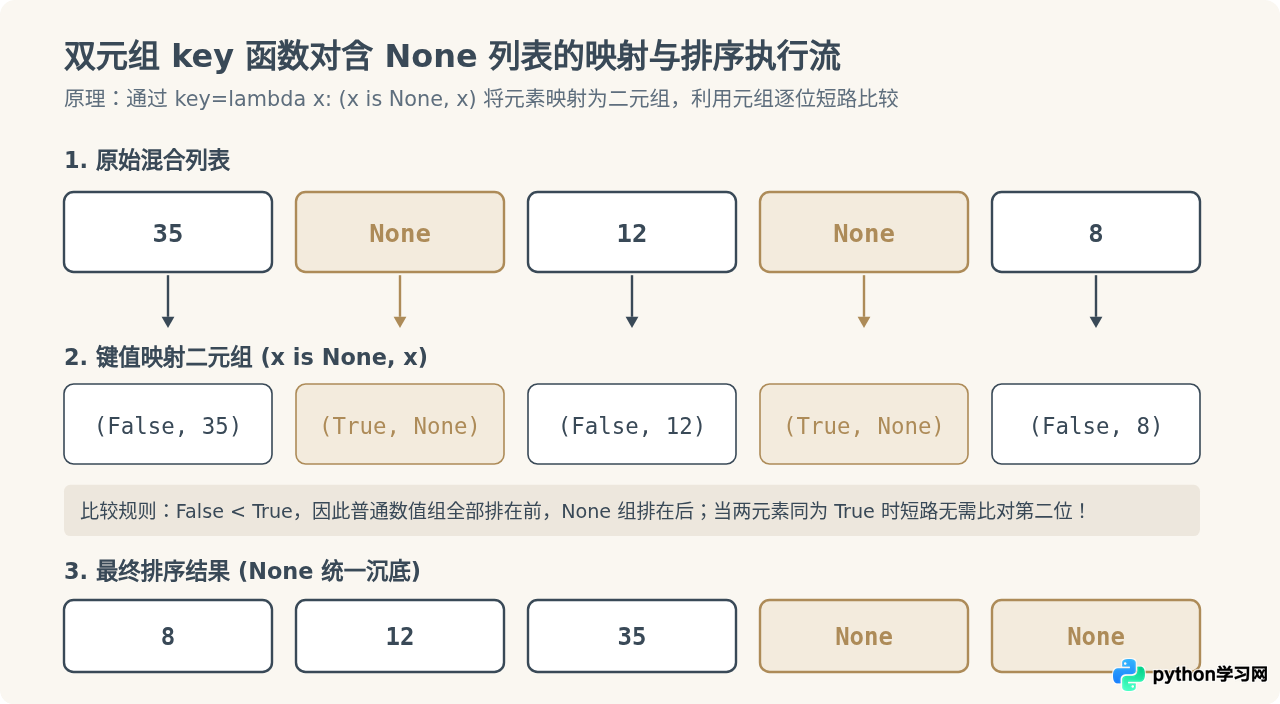
注意 reverse=True 时的反转效应:如果添加了 reverse=True 想要对数值降序排列,由于整个二元组都会被翻转,原本排在末尾的 (True, None) 会翻转到最前面。如果希望在数值降序的同时依然让 None 保持在最末尾,第一项标志位应改为 x is not None,第二项数值可取相反数或使用单独的控制逻辑。
三、数字与字符串混合类型的排序策略
当列表中混合了数字与字符串(例如从 CSV 或接口解析出未严格类型化的数据 [5, "12", "apple", 3])时,不能盲目套用 None 的二元组。根据具体业务目标,有三种常见的解决策略:
1. 统一转换为字符串字典序
如果当前排序仅用于日志展示、文本搜索对齐,且不强调纯数值的数学大小,可以直接指定 key=str:
raw_data = [100, "20", 3, "apple"]
result = sorted(raw_data, key=str)
print(result)
# 输出结果:[100, '20', 3, 'apple']
# 注意:'100' 在字典序中排在 '20' 和 '3' 之前,这改变了数值的相对大小。
2. 类型分区排序(数字在前,字符串在后)
如果希望“所有数字按数学大小升序排在前面,所有字符串按字母顺序排在后面”,依然可以使用二元组进行类型分区:
mixed = ["banana", 45, 12, "apple", 3]

# 0 代表数字分区,1 代表字符串分区
def mixed_key(x):
    if isinstance(x, (int, float)):
        return (0, x)
    return (1, str(x))

sorted_mixed = sorted(mixed, key=mixed_key)
print(sorted_mixed)
# 输出结果:[3, 12, 45, 'apple', 'banana']
3. 数值优先解析转换
如果列表中的字符串其实是“未转换的数字文本”(如 "12"、"3.14"),应该优先尝试转换为浮点数:
items = ["10", 2, "30", 5]

def parse_num_key(x):
    try:
        return float(x)
    except (ValueError, TypeError):
        return float('inf')  # 无法转换的非数字字符串推到末尾

print(sorted(items, key=parse_num_key))
# 输出结果:[2, 5, '10', '30']
四、前置数据清洗与结构化拆分
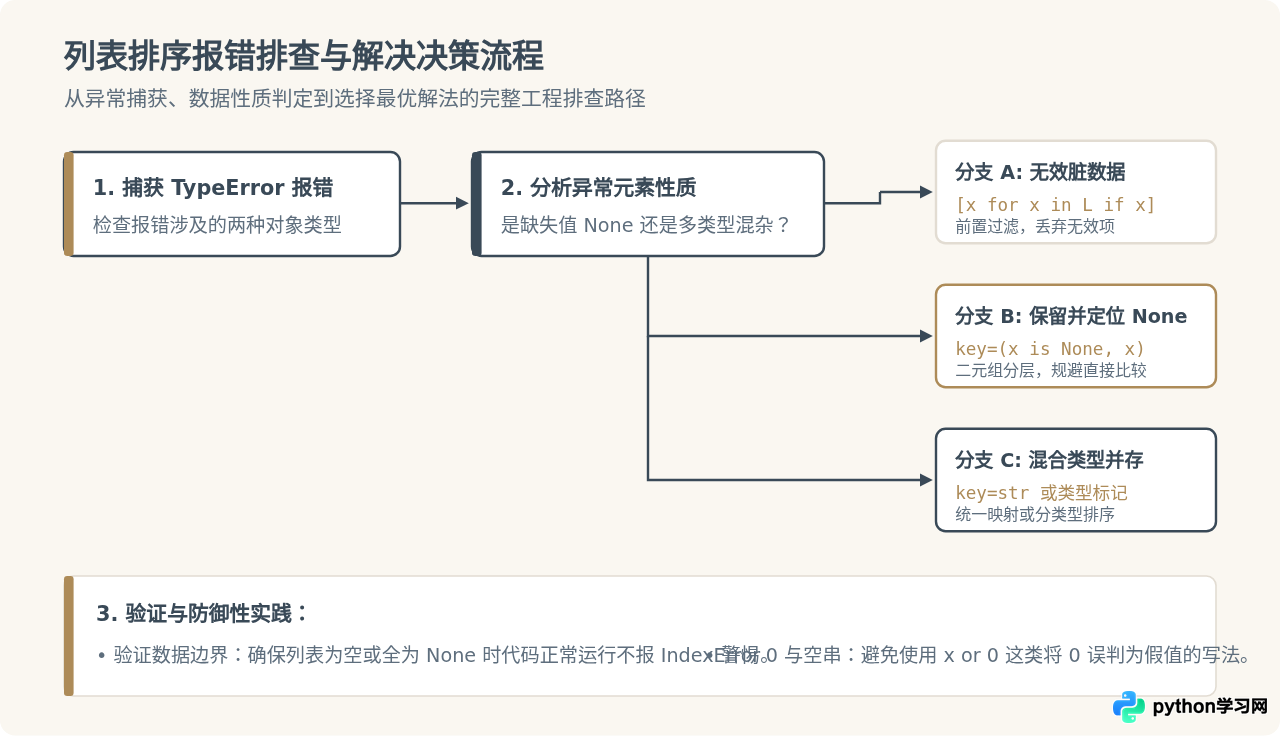
很多情况下,列表中混入 None 纯粹是上游数据采集时的脏数据。此时强行在排序逻辑中写兼容函数,反而会把脏数据隐蔽地传递给下游计算模块。更健壮的工程做法是在排序前进行数据清洗与结构分离。
1. 直接过滤丢弃法
如果业务确定不需要 None,直接使用列表推导式提取有效数据后再排序。这是性能最好、代码可读性最高的方法:
raw_scores = [85, None, 92, 78, None, 99]

# 明确过滤掉 None 元素
clean_scores = sorted([x for x in raw_scores if x is not None])
print(clean_scores)
# 输出结果:[78, 85, 92, 99]
2. 分离排序再拼接法
如果必须保留 None,但希望逻辑完全解耦,也可以先将非 None 元素过滤排序,最后把 None 重新拼接回去:
data = [15, None, 3, None, 22]

valid_sorted = sorted([x for x in data if x is not None])
none_count = data.count(None)

# 拼接在末尾
final_result = valid_sorted + [None] * none_count
print(final_result)
# 输出结果:[3, 15, 22, None, None]
五、常见误区与性能分析
在处理列表排序报错时,开发者容易陷入几个常见的代码陷阱,需要格外警惕:
1. 误区:使用 key=lambda x: x or 0 替换 None
有些开发者习惯写 key=lambda x: x or 0 或 key=lambda x: x or ""。这种写法在元素包含 0 或 False 时会引发严重的逻辑混淆:例如当元素本身就是合法数值 0 时,它与 None 都会被评估为 0,导致真实的零值和缺失的空值无法区分,甚至可能改变稳定排序下的相对位置。始终建议使用精确的身份比对 x is None。
2. 性能考量:Schwartzian 变换与时间复杂度
在 Python 中,sort(key=func) 底层采用 Schwartzian 变换机制:
- 在排序开始前,对列表中的每个元素仅调用一次
key函数,预先计算出一个包含键值的元组列表,时间复杂度为O(N)。 - 随后 Timsort 在 C 语言底层对预计算出的键值进行排序,时间复杂度为
O(N log N)。在整个比较过程中,并不会重复执行 Python 层面的 lambda 函数。 - 因此,即便使用元组
(x is None, x)作为 key,其带来的额外开销也极为轻微,完全能够胜任千万级数据规模的排序需求。
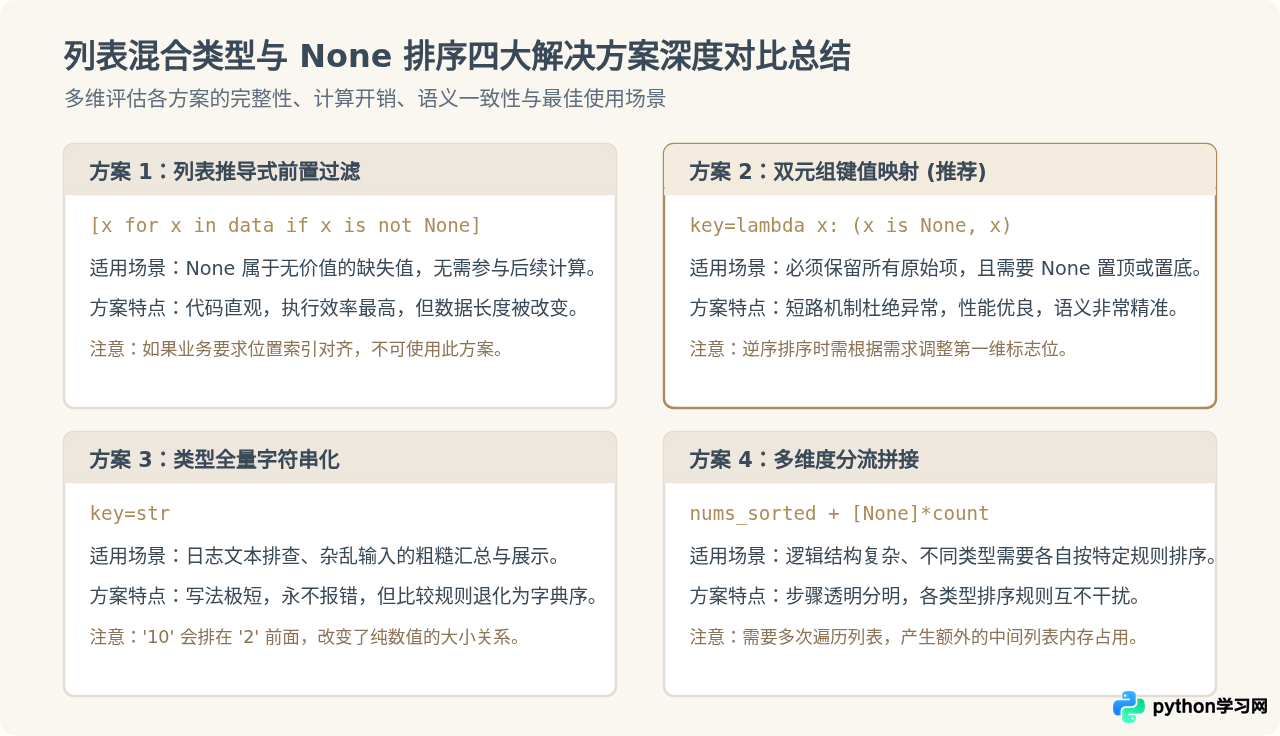
六、工程速查总结
遇到 TypeError: '<' not supported between instances 报错时,推荐按照以下检查清单快速定位并修复:
- 确认数据源中是否包含缺失值:打印
any(x is None for x in data)。若包含且无需保留,直接使用[x for x in data if x is not None]清洗。 - 需要保留 None 元素的位置:将排序调用改为
sorted(data, key=lambda x: (x is None, x))。该写法充分利用元组短路比较机制,在保持高性能的同时杜绝一切比较异常。 - 混合类型数据对齐:如果列表同时包含字符串与数值,切勿直接调用
sort(),应根据业务语义决定是按字符串字典序统一(key=str),还是通过自定义函数返回元组实现类型分区排序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









