

Python爬虫实战:怎么抓取网页数据并保存为CSV
全面讲解使用Python抓取网页数据并导出为标准CSV文件的完整实战流程,涵盖HTTP请求构建、DOM解析提取、标准CSV写入与常见编码避坑。
抓取网页数据并保存为CSV文件的核心路径非常清晰:先使用网络请求库下载目标网页的HTML源码,再借助HTML解析器定位并抽取结构化字段,最后调用Python内置的CSV模块按行写入文件。本文通过完整的代码示例与步骤拆解,展示从发送请求到安全生成CSV表格的全部技术细节。
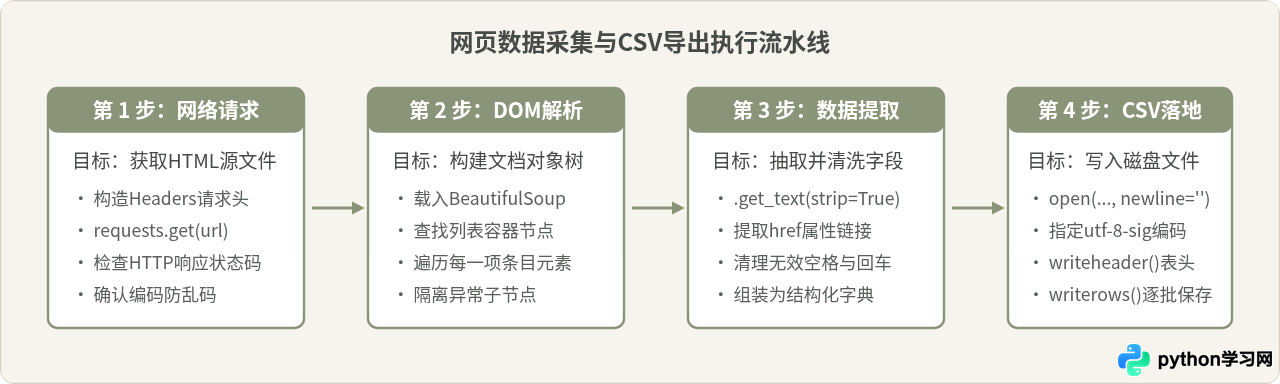
一、抓取与存储的核心流水线
在编写具体代码前,需要明确整个抓取程序的数据流动方式。一个健壮的爬虫程序通常由四个顺序衔接的阶段构成:发送请求、解析文档树、组装字段字典、流式写入磁盘。
二、环境准备与依赖安装
完成本任务需要安装两个第三方库,其余工具均为Python官方标准库:
requests:用于向目标服务器发起HTTP请求,获取网页响应内容。beautifulsoup4:用于对HTML文档进行语法树解析与节点检索。csv:Python自带标准模块,无需额外安装,负责标准逗号分隔值文本的编解码与转义。
在终端或命令行中执行以下安装命令:
pip install requests beautifulsoup4三、容易混淆的写入方式:字符串拼接与标准模块辨析
许多初学者在第一次尝试保存数据时,习惯使用常规的文件写入操作,通过字符串拼接实现:
# 常见但存在重大隐患的写法
with open("data.csv", "w", encoding="utf-8") as f:
    f.write("title,price,intro\n")
    f.write(f"{title},{price},{intro}\n")
这种写法在字段内容只包含简单纯英文字符、纯数字时看似完全正常,但只要字段内部包含半角逗号、双引号或换行符,整个CSV的列结构就会立刻被破坏。例如简介字段如果包含“轻薄,便携”,直接拼接会导致该行在表格软件中被拆分成两列,后续字段全部错位。
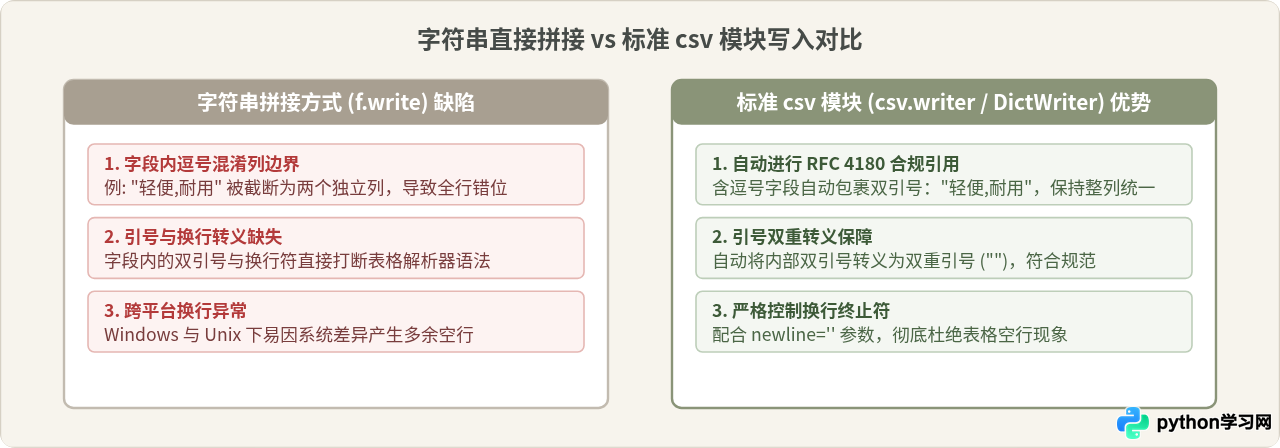
关键准则:永远不要通过字符串拼接手动拼凑CSV格式。使用Python标准库的 csv.writer 或 csv.DictWriter,由底层模块自动处理字段包裹与引号转义。
四、实战演练:从DOM树映射到二维表格
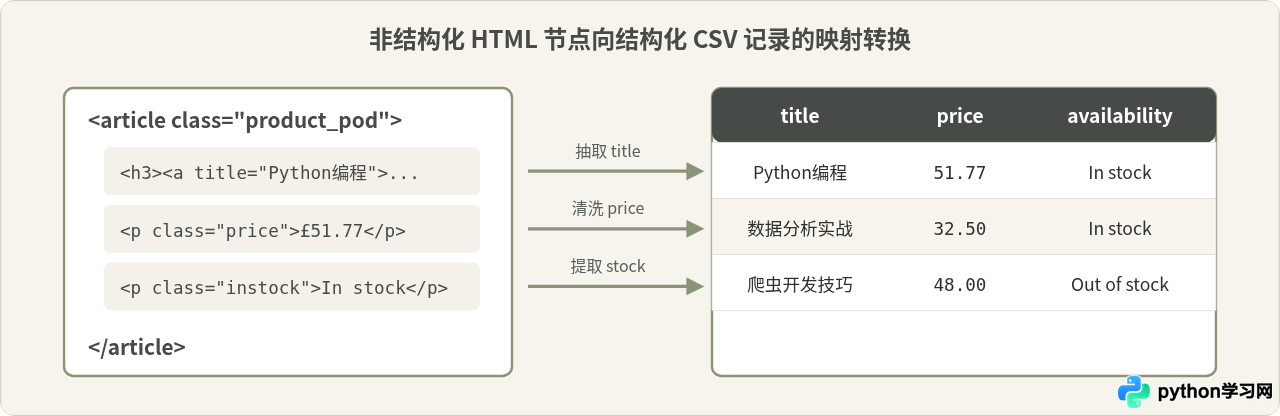
为了直观说明数据转化的过程,假设我们要抓取一个包含图书列表的网页。HTML层级结构往往是树状嵌套的,而CSV是严格的二维矩阵结构。提取过程的本质就是将HTML中散落的节点文本抽取出来,映射为表格的一行。
完整爬虫脚本实现
以下代码提供完整的实战程序。以公开用于爬虫测试的练习网站 books.toscrape.com 为例,完整演示抓取列表并将数据保存至 books_output.csv 的过程:
import csv
import requests
from bs4 import BeautifulSoup

def crawl_books_to_csv(target_url, output_file_path):
    # 1. 模拟常用浏览器 User-Agent,规避基本的反爬识别
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }

    try:
        response = requests.get(target_url, headers=headers, timeout=10)
        response.raise_for_status()  # 若返回4xx或5xx状态码直接抛出异常
        response.encoding = response.apparent_encoding  # 确保自动适配编码
    except requests.RequestException as err:
        print(f"网络请求失败:{err}")
        return

    # 2. 构建 BeautifulSoup 文档树
    soup = BeautifulSoup(response.text, "html.parser")

    # 定位所有包含书籍信息的卡片节点
    items = soup.find_all("article", class_="product_pod")
    data_list = []

    for item in items:
        # 提取标题:优先取 a 标签中的 title 完整属性,不存在时退回取文本
        title_tag = item.find("h3").find("a") if item.find("h3") else None
        title = title_tag.get("title", "").strip() if title_tag else "未知书名"

        # 提取价格:清理价格符号
        price_tag = item.find("p", class_="price_color")
        price = price_tag.get_text(strip=True).replace("Â", "") if price_tag else "0.00"

        # 提取库存状态
        stock_tag = item.find("p", class_="instock availability")
        stock = stock_tag.get_text(strip=True) if stock_tag else "未知"

        # 封装为单行字典
        data_list.append({
            "title": title,
            "price": price,
            "availability": stock
        })

    # 3. 写入 CSV 文件
    # newline='' 是防止 Windows 平台多余空行的关键参数
    # encoding='utf-8-sig' 可以保证 Excel 打开中文时不出现乱码
    fieldnames = ["title", "price", "availability"]
    with open(output_file_path, mode="w", newline="", encoding="utf-8-sig") as csv_file:
        writer = csv.DictWriter(csv_file, fieldnames=fieldnames)

        # 写入列头(表头)
        writer.writeheader()

        # 批量写入所有抓取到的记录行
        writer.writerows(data_list)

    print(f"抓取完成,共提取 {len(data_list)} 条记录,已保存至:{output_file_path}")

if __name__ == "__main__":
    TARGET = "http://books.toscrape.com/"
    OUTPUT = "books_output.csv"
    crawl_books_to_csv(TARGET, OUTPUT)
五、常见问题排查与关键技术细节
在实际执行抓取并保存为CSV的过程中,初学者最常遇到三个痛点问题,需要针对性处理:
1. 为什么用 Excel 打开 CSV 会出现中文乱码?
很多程序默认使用 encoding="utf-8" 写入文件,在文本编辑器(如 VS Code、Sublime Text)中打开完全正常,但用 Microsoft Excel 双击打开时中文却变成一串乱码。这是因为 Windows 系统的 Excel 在未检测到字节顺序标记(BOM)时,会默认使用系统当前的本地ANSI编码(例如简体中文系统的 GBK)来解析文件。解决方法是将打开文件时的编码参数指定为 utf-8-sig,它会在文件开头写入三个字节的 BOM 标识(EF BB BF),强制 Excel 采用 UTF-8 方式解析。
2. 为什么生成的 CSV 文件每一行中间都夹杂一个空行?
在 Windows 环境下,如果不显式指定 newline="",Python 的 open() 函数在写入时会自动将 \n 转换为系统默认的 \r\n;而 csv 模块内部本身也会按照标准写入行结束符 \r\n。两层转换叠加后,就会导致每写入一行实际产生了两个换行,在表格中表现为明显的隔行空行。加上 newline="" 后,Python 会将行结束符的控制权完全交由 csv 模块内部处理,彻底解决空行问题。
3. 部分网页节点缺失导致 AttributeError: 'NoneType' 报错
实际网页中往往存在不规范数据,例如某一行记录缺少价格标签,直接调用 item.find("p").get_text() 会因为 find() 返回 None 而导致程序崩溃。应养成安全的提取习惯:先判断节点是否存在,或编写辅助清洗函数进行缺省兜底。
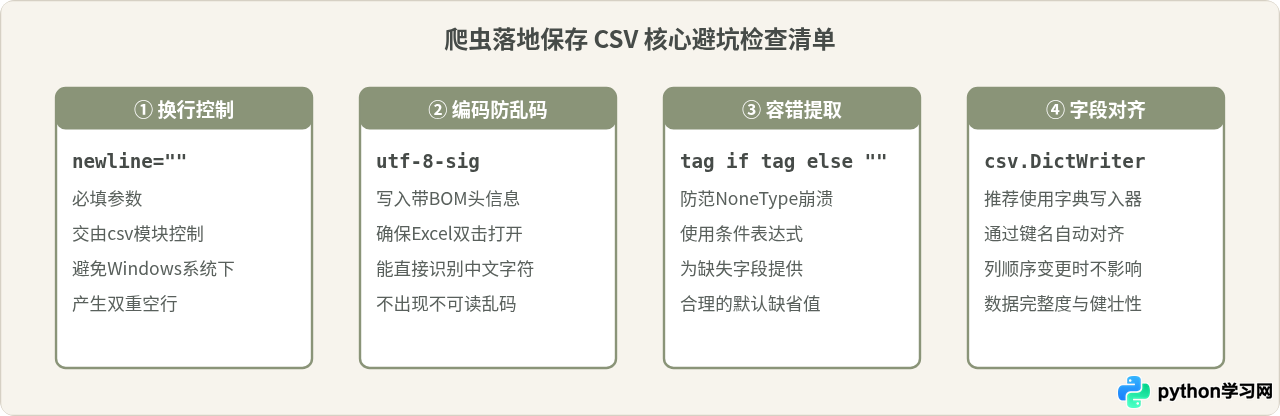
六、结果验证方法
完成抓取后,可以通过以下两种方式快速验证产物:
- 命令行统计行数:在终端执行
wc -l books_output.csv,确认行数是否与抓取预期(数据条数 + 1行表头)一致。 - Python轻量复检:使用标准模块读回前几行打印核对:
import csv

with open("books_output.csv", mode="r", encoding="utf-8-sig") as f:
    reader = csv.reader(f)
    for idx, row in enumerate(reader):
        if idx < 5:
            print(row)
        else:
            break
只要严格遵循“网络请求获取文档、解析库定位元素、组装字典列表、配合 newline='' 与 utf-8-sig 标准写入”这一套流程,即可稳定、高效地完成网页数据的提取与持久化保存任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









