

只会Python基础语法能做什么?初学者常见的能力误区
深入剖析只会Python基础语法能做与不能做的事情,揭示初学者常见的认知误区,并提供基于基础语法解决实际问题的完整操作思路与进阶指引。
只会Python基础语法绝不意味着“只能写出打印Hello World的玩具”。通过基础的循环、条件分支、字典列表以及文件读写,你已经完全有能力编写脚本,接管本地文件批量分类、文本日志清洗、格式转换和简易自动化等日常繁琐工作;但与此同时,单纯掌握语法无法直接支撑Web开发、分布式爬虫或算法工程,因为商业级系统依赖的是工程架构、标准规范与生态工具。本文将具体厘清基础语法的能力边界,剖析初学者最常踩入的四种认知误区,并给出低成本落地与跨越进阶的清晰指引。
一、先厘清边界:所谓的“基础语法”究竟包含哪些内容?
在许多初学者的讨论中,“基础语法”往往是一个界限模糊的概念。有人以为学完变量赋值就算基础,也有人把面向对象的多重继承和元编程也归为基础。为了准确评估能够做出的成果,我们需要将基础语法的范围明确划定为绝大多数教材前五至八章所涵盖的核心机制:
- 变量与核心数据类型:整数(
int)、浮点数(float)、布尔值(bool)与字符串(str)的基本运算及切片操作。 - 容器与数据结构:列表(
list)、字典(dict)、集合(set)和元组(tuple)的增删改查、排序与遍历。 - 程序流程控制:基于
if-elif-else的条件判断分支,以及for、while循环语句配合break、continue的控制。 - 函数与作用域:定义带参数与返回值的函数(
def),理解局部变量与全局变量的作用边界。 - 基本输入输出与异常:
input()、print()交互,利用with open()读写纯文本或CSV文件,以及简单的try-except异常捕获。
这一套体系构成了图灵完备的逻辑计算单元。凡是能用严密逻辑规则推演计算的数据转化,在理论上都可以在这个语法集合内完整实现。
二、只会基础语法,究竟能做哪些有实际价值的事情?
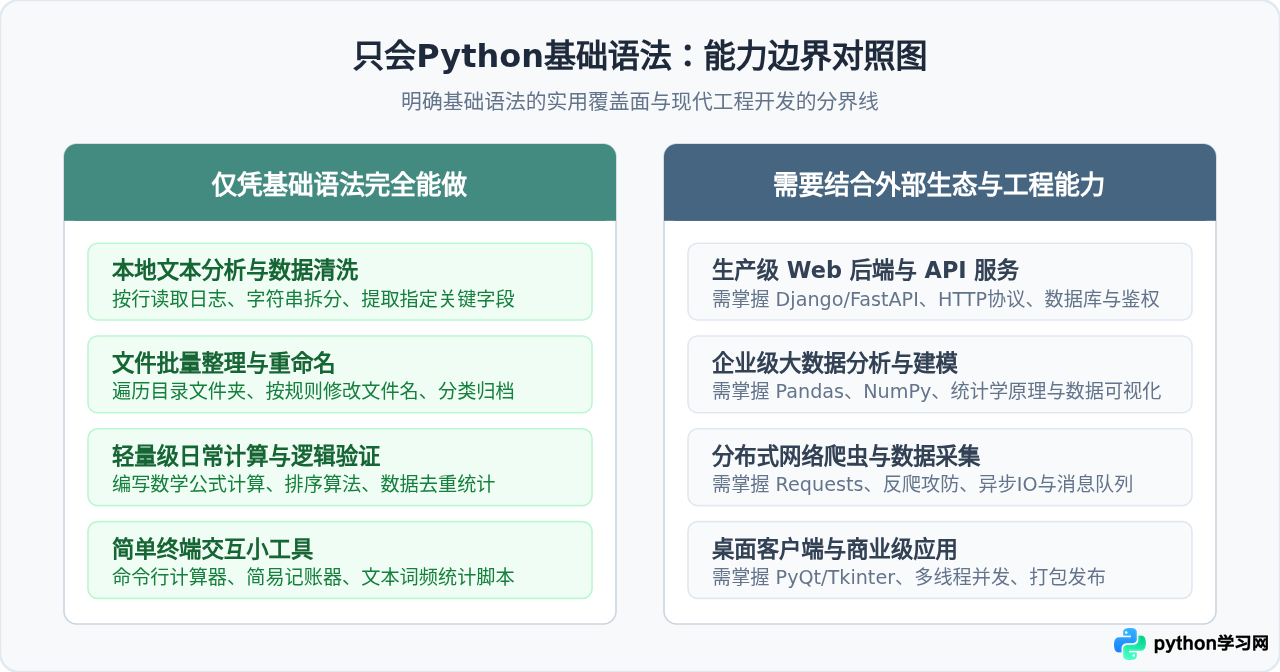
很多初学者在刚学完基础语法后,常常觉得除了在终端打印九九乘法表外一无所用。其实,基础语法结合 Python 原生自带的少量标准库,在真实办公和个人数据管理场景中有着极高的投入产出比。以下四个方向是完全依靠基础语法就能独立实现的应用:
1. 批量重命名与整理本地文件
配合标准库的 os 或 pathlib 模块,你可以通过二十行左右的代码,把下载文件夹中混乱的几百个文件,按照扩展名分门别类移动到不同子文件夹中,或者根据创建日期统一重命名。这种任务如果手动处理需要耗费数小时,而用纯基础循环几秒钟就能完成。
2. 日志分析与结构化文本提取
服务器访问日志、纯文本导出的聊天记录或设备运行报告,往往是成千上万行的非结构化文本。仅利用 for line in file 遍历,配合 str.split()、str.strip() 与字典统计,你就能快速统计出哪一个IP访问频率最高、系统在哪一个时间段报错最集中。
3. CSV表格数据的轻量清洗与过滤
在尚未学习大型数据分析库之前,纯基础语法已经支持处理千万级别的扁平表格。通过 Python 原生的 csv 模块或逐行读取,把每一行数据转化为字典或列表,判断特定字段是否为空、去除重复记录、筛选出销售额大于阈值的特定行并重新输出为干净的新表格。
4. 命令行交互小工具与算法逻辑验证
构建无需图形界面的控制台小工具,例如按月折旧计算器、单词默写抽测程序、待办事项命令行记录簿。这些程序直接锻炼逻辑分支与数据状态管理能力,是巩固语法的最佳磨刀石。
三、初学者常见的四大能力误区深度剖析
在从“语法认知”过渡到“实际应用”的过程中,初学者往往会因为对编程能力的理解偏差,陷入以下四种典型的心理与实践误区:
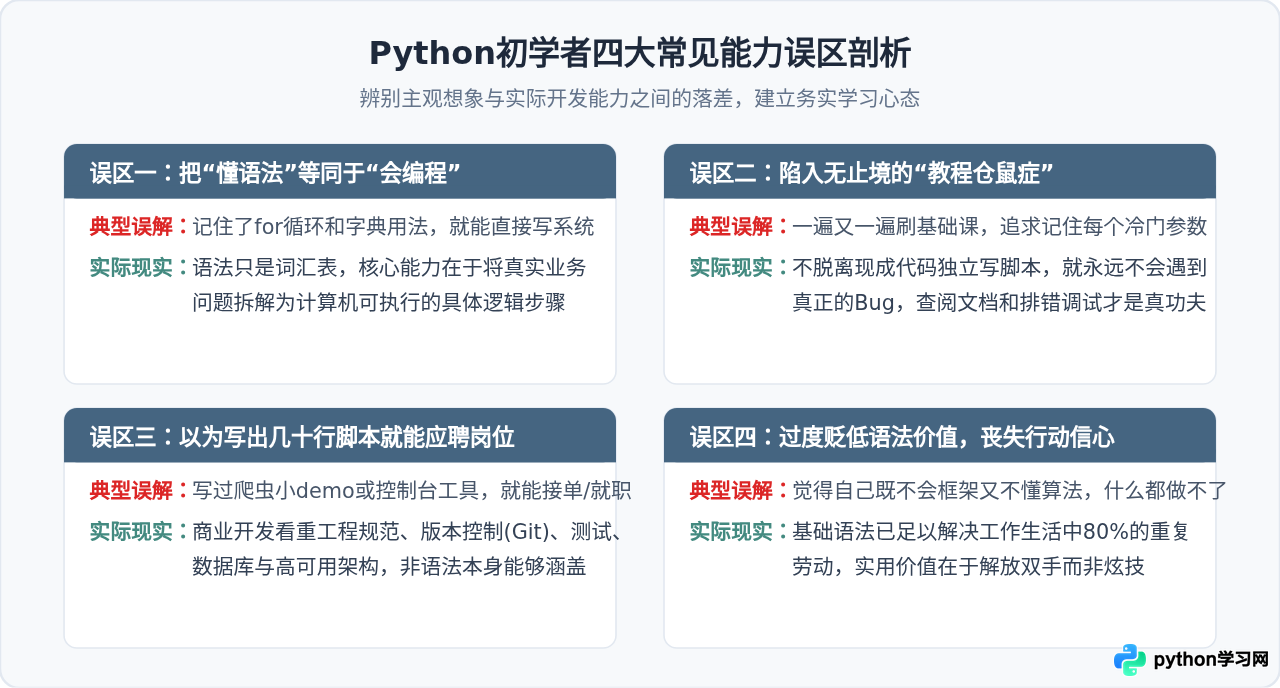
误区一:把“看懂语法”等同于“具备编程能力”
许多初学者在跟着视频敲完代码、看懂每行语法后,会产生一种“我已经掌握了”的错觉。但一旦关掉视频面对空白编辑器,却不知道第一行代码写什么。
核心原因:语法只是语言的字词和句式规则,而真正的编程能力是“问题拆解与建模”。计算机不会凭空猜度你的意图,你必须将模糊的现实问题(如“把这个文件夹按类型归类”)拆解为“取得所有文件路径”、“读取后缀名”、“判断目标目录是否存在”、“执行移动文件”等一系列严格有序的微小指令。缺乏拆解训练,语法背得再熟也无法独立写出可用脚本。
误区二:陷入“教程仓鼠症”,只刷课不写项目
不少人连续刷了三套不同的Python入门视频,总觉得自己“掌握得还不够扎实”,于是反复背诵字典方法、列表推导式或函数装饰器。
核心原因:反复刷基础课是一种心理上的舒适区。看视频容易获得虚假的掌控感,但独立写代码时遇到报错(如 IndexError、TypeError、路径不存在)会带来挫败感。然而,编程水平正是在一次次阅读 Traceback 错误信息、排查变量状态的过程中建立起来的。脱离了报错与调试,就无法形成真正的排障能力。
误区三:认为掌握语法就能直接应聘或商业接单
部分营销文章宣称“学会Python就能接单做兼职”,导致初学者产生错误期望,以为写出几十行爬虫或脚本就具备了交付商业成果的能力。
核心原因:商业开发的核心在于“工程稳定性”。一个合格的生产项目不仅需要基础语法,还需要处理并发冲突、数据库事务、鉴权安全、异常边界重试、日志追踪、Docker容器化以及版本协作控制(Git)。没有这些外围工程体系的支撑,单靠基础语法写出的脚本在复杂生产环境中极难持续运行。
误区四:因做不出大型应用而过度自卑,否定基础价值
与误区三相反,部分初学者发现自己无法快速做出像微信、淘宝那样的界面软件或酷炫系统,便认为基础语法“毫无用处”,甚至中途放弃。
核心原因:没有把工具用在正确的场景上。对于大多数非计算机专业的从业人员而言,学编程的核心目的不是成为全职软件工程师,而是消除自己工作中的低效重复环节。一个只包含30行基础代码的自动查重脚本,每年可能帮你节省数十个小时的手工劳动,它的实用价值已经完全兑现。
四、实例拆解:仅用基础语法,如何解决实际业务问题?
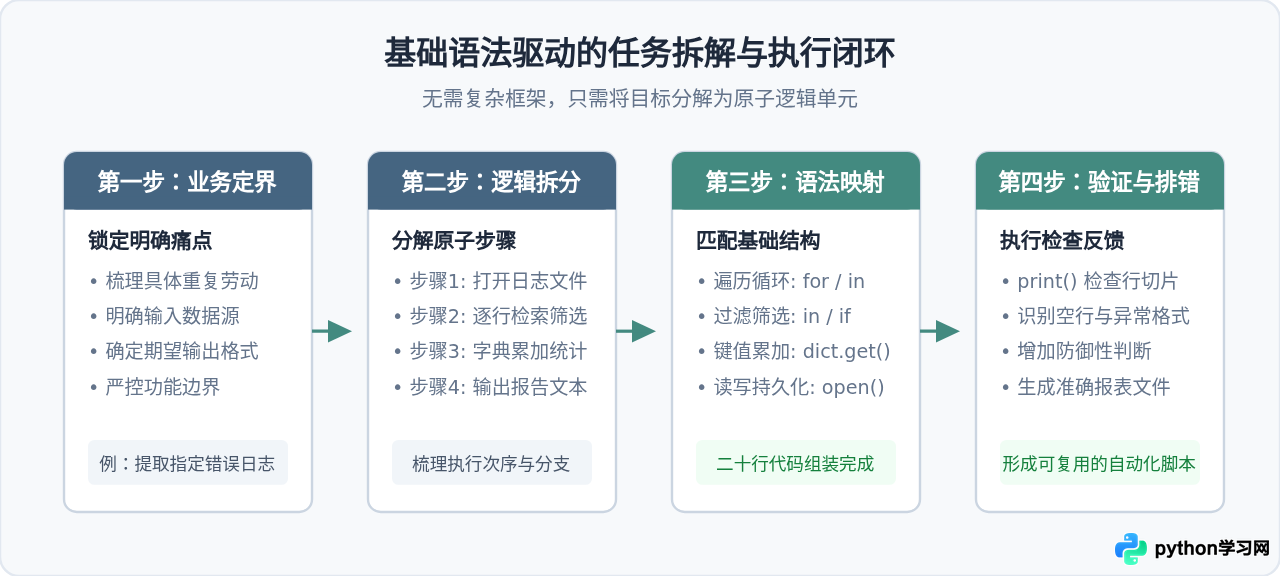
为了具体展示基础语法的力量,我们以一个真实的日常痛点为例:某团队每天会生成一份服务器操作记录文本,格式杂乱,管理者需要统计出出现错误(标记为 ERROR)的次数,并按模块分类输出为一份简明的摘要报告。
完整代码示例
# parse_log_summary.py
# 运行环境:Python 3.6+ 原生内置环境,无需安装任何第三方库

def generate_error_report(log_filepath, report_filepath):
    error_summary = {}
    total_lines = 0
    error_count = 0

    # 1. 安全打开并逐行读取原始日志
    with open(log_filepath, "r", encoding="utf-8") as file:
        for line in file:
            total_lines += 1
            line = line.strip()

            # 2. 条件过滤:仅处理包含 ERROR 的非空行
            if "ERROR" in line:
                error_count += 1
                parts = line.split(" - ")
                # 假设日志格式为:[时间] - [模块名] - [级别] - 详细内容
                if len(parts) >= 4:
                    module_name = parts[1].strip("[]")
                else:
                    module_name = "UNKNOWN"

                # 3. 使用字典记录并累加每个模块的错误频次
                error_summary[module_name] = error_summary.get(module_name, 0) + 1

    # 4. 将统计结果格式化写入输出报告
    with open(report_filepath, "w", encoding="utf-8") as out:
        out.write("==== 运行故障分析摘要 ====\n")
        out.write(f"总扫描日志行数: {total_lines}\n")
        out.write(f"总错误触发次数: {error_count}\n\n")
        out.write("各模块错误分布明细:\n")
        for module, count in error_summary.items():
            out.write(f"  模块: {module.ljust(15)} | 错误数: {count}\n")

if __name__ == "__main__":
    # 执行生成
    generate_error_report("server.log", "error_report.txt")
    print("分析完成,报告已生成至 error_report.txt")
这段脚本完全依赖 with open()、for 循环、字符串方法 split()、以及字典的 get() 默认值取值。它没有使用任何额外安装的框架,却完整实现了自动化数据采集、清洗、统计和持久化存储的全流程。
五、从“只会语法”到“能做完整项目”的跨越路径
当你能够熟练使用基础语法解决类似的单个具体问题后,如何进一步升级自己的技术栈,顺利过渡到能够独立开发商业级项目的状态?以下是经过验证的四个递进阶段:
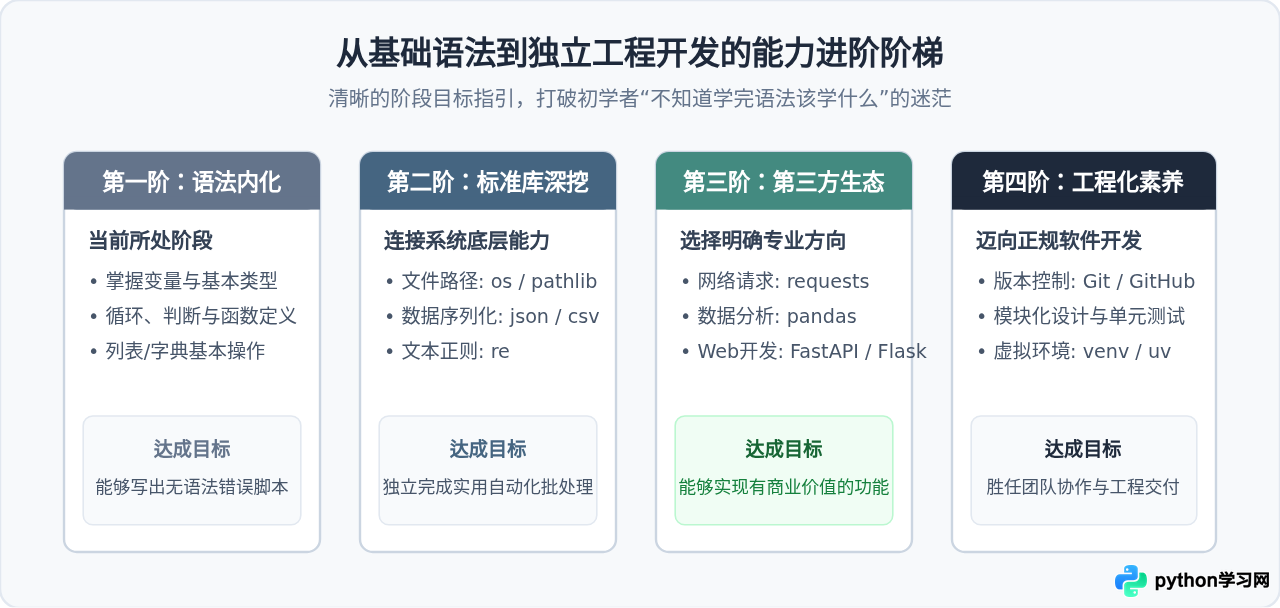
1. 第一阶:向内置标准库延伸(零安装成本)
学完基础语法后,不要急于去安装庞大的第三方框架。Python “自带电池”(Batteries Included)的设计理念使得其标准库异常强大。优先把以下几个标准库融入自己的脚本中:
pathlib:现代面向对象的路径操作,比os.path更加优雅直观。json与csv:负责与结构化数据交换格式进行交互。re:正则表达式库,极大扩展对复杂非结构化字符串的解析能力。datetime:掌握时间计算、时区转换与定时戳记录。
2. 第二阶:锚定一个方向,引入核心第三方库
不要同时学习爬虫、Web开发和机器学习。根据自身最核心的需求,只选择一条路径进行深度实践:
- 办公与数据处理方向:优先掌握
pandas和openpyxl,彻底取代繁重的手工 Excel 操作。 - 网络与数据抓取方向:掌握
requests库及 HTTP 协议状态码,学习处理 JSON API 返回。 - Web 与后台开发方向:从轻量级框架
FastAPI或Flask起步,理解请求路由与响应构造。
3. 第三阶:掌握现代开发工程素养
当脚本行数突破几百行时,工程素养成为决定代码是否可维护的核心因素:
- 版本控制(Git):使用 Git 记录每一次代码修改,建立主分支与特性分支意识。
- 虚拟环境隔离:使用
python -m venv或现代工具(如uv),确保项目依赖相互独立不冲突。 - 模块化拆分:将一个长达上千行的单文件脚本,拆分为数据读取、核心计算、报告输出等多个模块文件并使用
import相互调用。
总结
“只会Python基础语法”并不是一种能力的缺陷,而是每一个开发者必经的基石阶段。在这一阶段,正确的学习策略不是漫无目的地重复背诵知识点,也不是因无法一步登天开发商业系统而自我否定;而是以身边具体的真实重复任务为抓手,用基础语法打造小而实用的自动化工具。当你不断在实践中体会到用逻辑替代机械劳动的成就感时,思维模型便已悄然建立,后续向大型生态与工程体系的迈进,也将水到渠成。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









