

PyTorch实战:大模型LoRA与QLoRA参数高效微调代码实现

在开源大语言模型(LLM)爆发的今天,许多开发者面临着一个尴尬的现实:想要微调一个7B甚至13B参数的模型,却受限于本地显卡的显存容量。全量微调(Full Fine-tuning)需要保存所有参数的梯度和优化器状态,这对硬件的要求几乎是天文数字。对于大多数个人开发者或中小团队而言,购买昂贵的A100集群并不现实。
这就引出了参数高效微调(PEFT)的核心价值:在不更新全部模型参数的前提下,通过引入极少量的可训练参数,达到接近全量微调的效果。其中,LoRA(Low-Rank Adaptation)已成为行业标准,而QLoRA则进一步通过量化技术将门槛降至消费级显卡可承受的范围。这不是简单的“压缩”,而是一种在精度与效率之间寻找最佳平衡点的工程艺术。
本文将剥离复杂的理论推导,直接切入PyTorch实战场景,展示如何从零构建一个支持LoRA和QLoRA的微调流水线,让定制大模型不再遥不可及。
LoRA的核心逻辑:旁路注入而非修改主干
传统微调就像是为了改变房屋结构而拆除重建墙体,而LoRA更像是在原有墙体旁搭建了一个轻便的脚手架。它冻结预训练模型的所有权重,仅在Transformer层中注入低秩分解矩阵。在推理时,这些低秩矩阵与原始权重相加,从而改变模型的行为。
这种设计带来了两个显著优势:一是可训练参数量极少,通常仅为原模型的1%甚至更少;二是训练后的适配器权重文件非常小(几MB到几百MB),便于存储和切换不同任务。
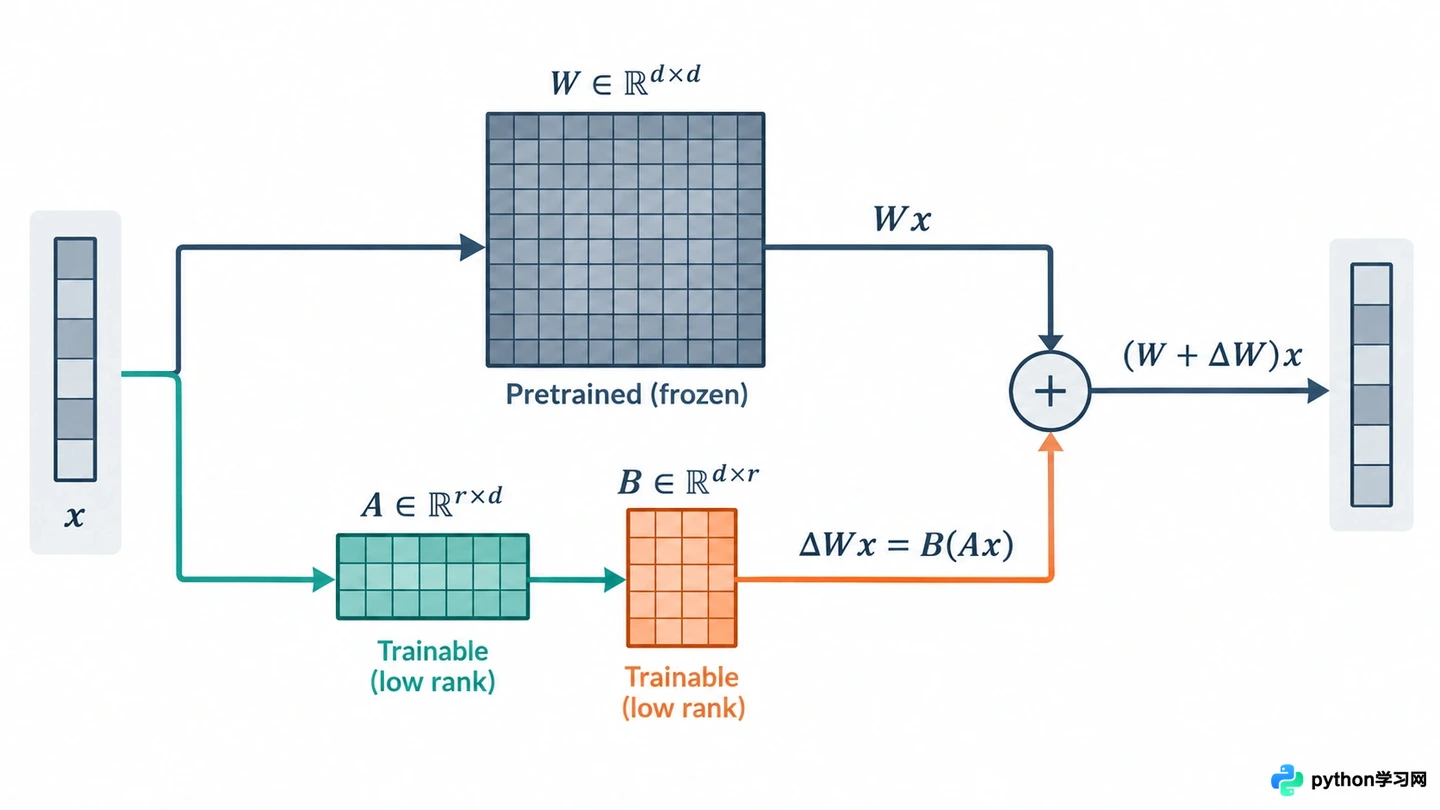
LoRA通过低秩矩阵旁路注入,冻结主模型权重
在代码实现上,我们首先需要使用peft库中的LoraConfig来定义这些“脚手架”的结构。关键参数包括r(秩)、lora_alpha(缩放因子)和target_modules(目标模块)。
from peft import LoraConfig, get_peft_model

# 配置LoRA参数
lora_config = LoraConfig(
    r=8,                  # 秩,越大表达能力越强,但参数量增加
    lora_alpha=32,        # 缩放因子,通常设为r的2-4倍
    target_modules=["q_proj", "v_proj"], # 针对注意力机制的查询和值投影层
    lora_dropout=0.05,    # 防止过拟合
    bias="none",          # 不训练偏置项
    task_type="CAUSAL_LM" # 因果语言建模任务
)

# 假设model是已经加载的预训练模型
model = get_peft_model(model, lora_config)
model.print_trainable_parameters()
注意target_modules的选择。虽然可以针对所有线性层应用LoRA,但实践中仅针对注意力机制中的q_proj和v_proj往往就能获得绝大部分性能增益,同时保持极高的参数效率。执行print_trainable_parameters()后,你会看到可训练参数占比通常低于1%,这意味着梯度计算和optimizer状态的内存占用将大幅降低。
QLoRA的突破:4-bit量化下的精度保持
如果说LoRA减少了需要更新的参数,那么QLoRA则解决了“基座模型本身太大装不下显存”的问题。QLoRA的核心在于使用4-bit NormalFloat(NF4)数据类型加载预训练模型,并结合双重量化(Double Quantization)和分页优化器(Paged Optimizers)来进一步节省内存。
关键在于,这种极致的压缩并没有导致模型智能的显著损失。 Hugging Face的研究表明,QLoRA在多种基准测试中与16-bit LoRA的表现相当。
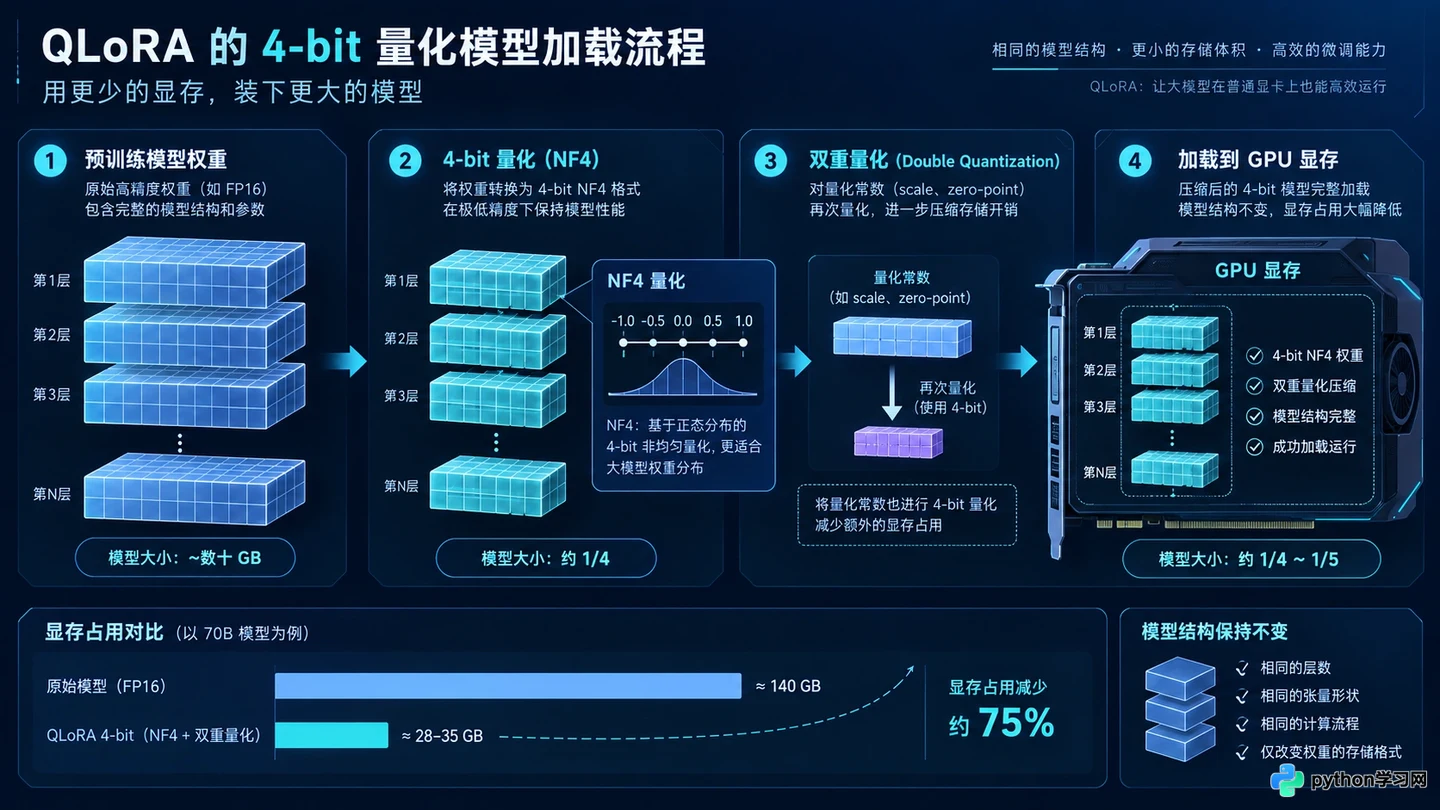
QLoRA使用4-bit NF4格式加载模型以节省显存
实现QLoRA的关键步骤在于模型加载阶段。我们需要使用bitsandbytes库将模型加载为4-bit格式。这要求你的PyTorch环境已正确安装支持CUDA的bitsandbytes。
import torch
from transformers import AutoModelForCausalLM, BitsAndBytesConfig

# 配置4-bit量化加载
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",      # 使用NF4数据类型,比FP4更适合正态分布权重
    bnb_4bit_compute_dtype=torch.bfloat16, # 计算时使用bfloat16以保持精度
    bnb_4bit_use_double_quant=True   # 启用双重量化,进一步节省空间
)

model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Llama-2-7b-hf",
    quantization_config=bnb_config,
    device_map="auto"               # 自动分配设备,利用多卡或单卡显存
)
这里有两个细节值得注意:bnb_4bit_compute_dtype设置为torch.bfloat16是因为现代GPU(如Ampere架构及以上)对bfloat16有原生支持,且其动态范围优于float16,能减少溢出风险。device_map="auto"则允许Transformers库自动判断如何将模型层分配到可用设备上,这对于显存碎片化管理至关重要。
数据流与训练循环:适配器的实际运转
有了模型和配置,接下来是数据。大模型微调通常采用指令跟随(Instruction Tuning)格式。我们需要将原始文本转换为模型可接受的输入ID和标签。
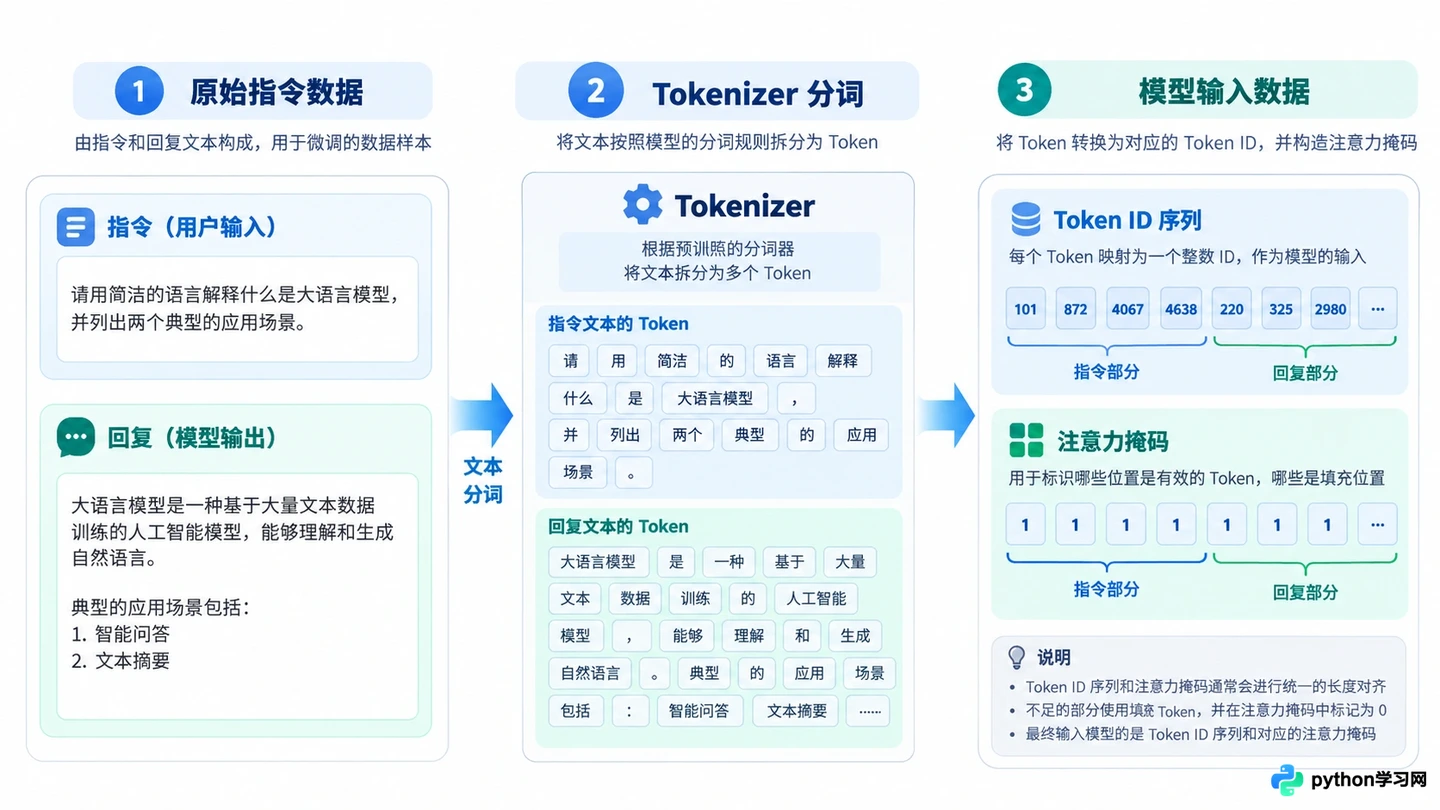
将原始指令数据转换为模型输入的Token序列
在使用transformers的Trainer时,QLoRA的一个巨大优势是它可以无缝集成。你不需要编写自定义的训练循环,只需确保数据处理正确即可。
from datasets import load_dataset
from transformers import AutoTokenizer, TrainingArguments, Trainer

# 加载数据集和Tokenizer
dataset = load_dataset("json", data_files="train.jsonl")
tokenizer = AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-hf")
tokenizer.pad_token = tokenizer.eos_token # 设置pad_token

def tokenize_function(examples):
    # 简单的指令模板化处理
    prompts = [f"### Instruction:\n{inst}\n\n### Response:\n{resp}"
               for inst, resp in zip(examples['instruction'], examples['response'])]
    return tokenizer(prompts, truncation=True, max_length=512, padding="max_length")

tokenized_dataset = dataset.map(tokenize_function, batched=True)

# 配置训练参数
training_args = TrainingArguments(
    output_dir="./lora-results",
    per_device_train_batch_size=4,
    gradient_accumulation_steps=4,
    learning_rate=2e-4,
    num_train_epochs=3,
    fp16=True, # 如果使用bfloat16加载模型,这里可能需要调整
    logging_steps=10,
    save_strategy="epoch"
)

# 初始化Trainer
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_dataset["train"],
    data_collator=lambda data: {k: torch.stack([d[k] for d in data]) for k in data[0].keys()}
)

trainer.train()
在这个流程中,gradient_accumulation_steps是一个重要的调优杠杆。如果单卡显存不足以支撑较大的per_device_train_batch_size,可以通过增加累积步数来模拟更大的批量大小,从而稳定训练过程。这在QLoRA场景中尤为常见,因为4-bit模型虽然省显存,但为了保持收敛稳定性,我们仍希望有效批次大小不要太小。
权重合并与部署:从适配器到完整模型
训练结束后,你得到的只是一个包含LoRA权重的适配器文件(adapter_model.bin)。在推理阶段,你有两种选择:一是动态加载适配器,二是将适配器权重合并回基座模型。
动态加载适合多任务切换场景,而合并权重则适合最终部署,因为它消除了推理时的额外计算开销,并兼容不支持PEFT的推理引擎(如某些版本的TensorRT-LLM或vLLM)。
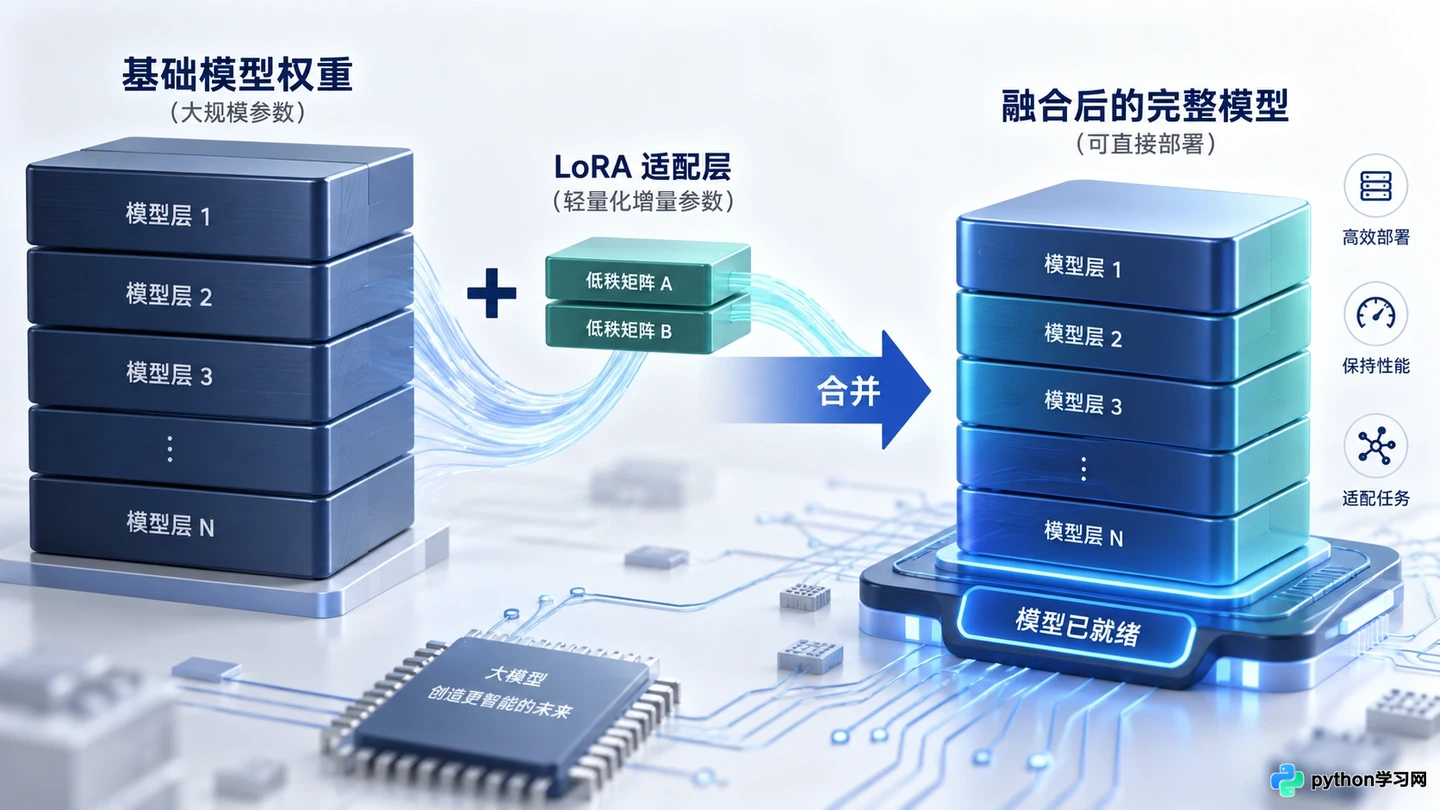
将训练好的适配器权重合并回基座模型
合并操作非常简单,但需要注意内存峰值。合并过程中,系统需要临时加载完整的16-bit或32-bit基座权重进行加法运算。
from peft import PeftModel

# 加载基座模型和LoRA适配器
base_model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-2-7b-hf")
lora_model = PeftModel.from_pretrained(base_model, "./lora-results/checkpoint-xxx")

# 合并权重
merged_model = lora_model.merge_and_unload()

# 保存合并后的模型
merged_model.save_pretrained("./merged-llama-2-7b-lora")
tokenizer.save_pretrained("./merged-llama-2-7b-lora")
执行merge_and_unload()后,返回的merged_model就是一个标准的Hugging Face模型对象,不再依赖peft库即可进行推理。这一步是将实验成果转化为生产力的关键最后一公里。
边界与取舍:何时该用QLoRA?
尽管QLoRA极大地降低了门槛,但它并非万能钥匙。首先,4-bit量化会引入微小的精度损失,虽然在大多数通用任务中不可察觉,但在对数值极度敏感的数学推理或代码生成任务中,可能需要仔细评估。其次,QLoRA的训练速度通常比16-bit LoRA慢,因为反量化操作需要额外的计算时间。
如果你的显存充足(例如拥有24GB以上的RTX 3090/4090或A10/A100),且追求极致的训练速度,16-bit LoRA可能是更优解。 但如果你的目标是利用消费级显卡(如12GB的RTX 3060/4070)跑通7B甚至13B模型的微调,QLoRA是目前唯一可行的工程方案。
技术的选择永远服务于业务场景。LoRA和QLoRA的出现,本质上是将大模型定制的权力从巨头手中下放到了每一个拥有独立显卡的开发者手中。理解其背后的代码实现与资源权衡,比单纯调用API更能让你在面对复杂需求时游刃有余。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









