

Replit等云端编辑器运行python超时内存不足
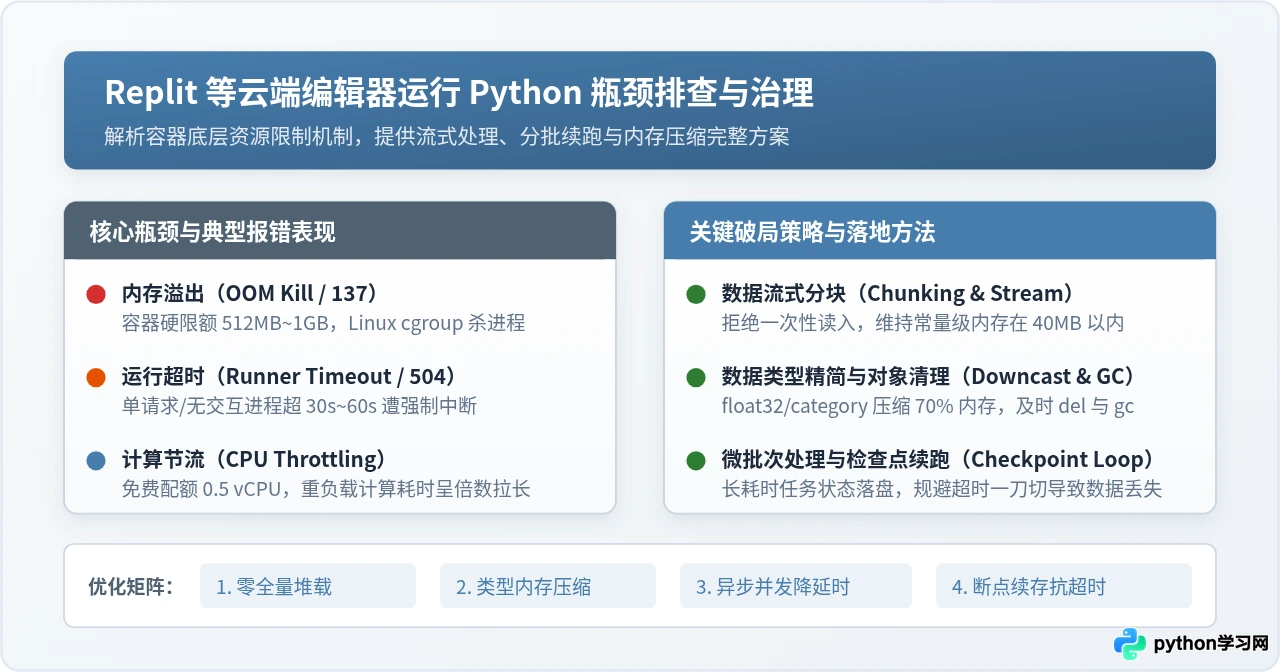
针对在 Replit、GitHub Codespaces 等云端编辑器中运行 Python 脚本频繁出现的内存溢出(Killed / 137 / MemoryError)与运行超时问题,深度剖析容器 cgroup 限制与 Runner 监控机制,提供流式分块、类型降级、异步并发与检查点续跑等经过验证的工程化解法。
Killed 或返回网关超时。这类故障的核心根源在于云端沙箱的硬性物理隔离(标准免费配额仅 512MB~1GB 内存与 0.5~1 核虚拟 CPU,并设有 30~60 秒的单步时限)。解决该问题无需立即付费升级,通过将数据流式分块、压缩内存字段类型、消除阻塞式 I/O 并引入断点检查点机制,即可在极其有限的容器配额内稳定跑通完整任务。
一、排查定位:准确辨别是内存溢出还是执行超时
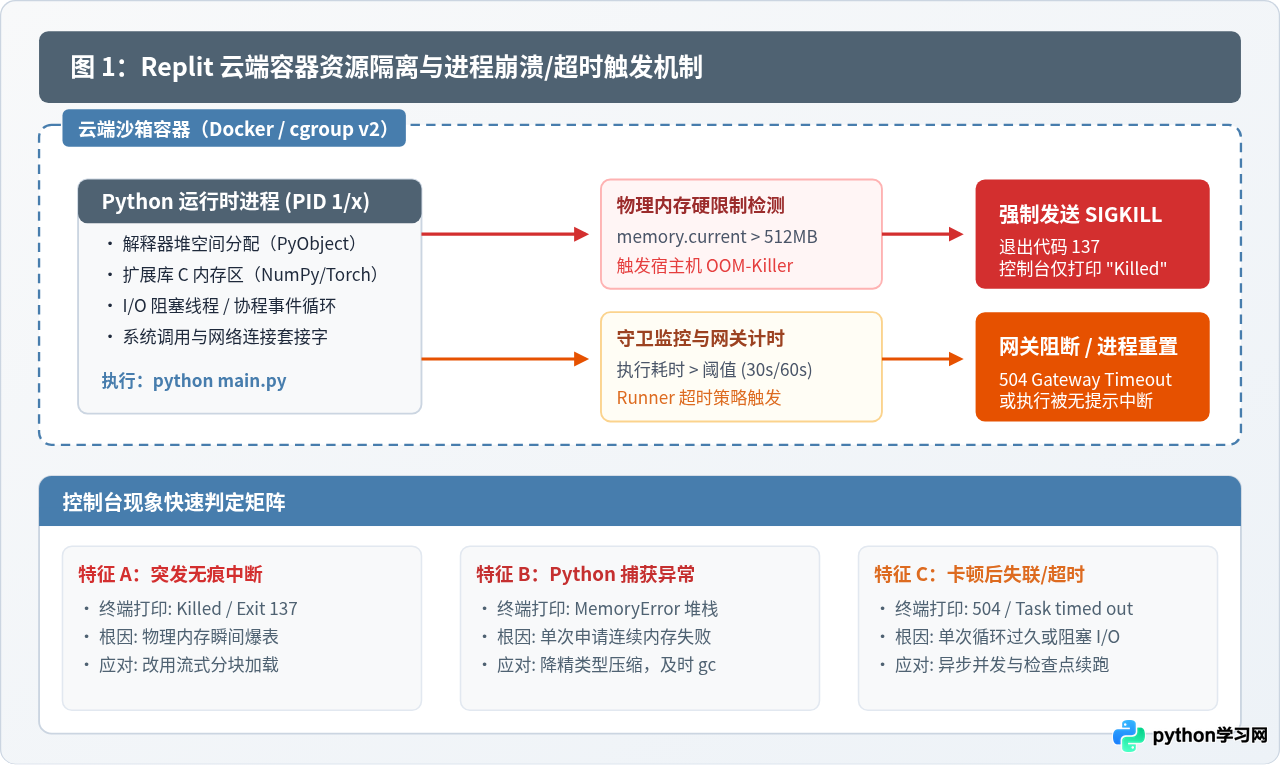
在云端环境中,容器没有本地计算机充裕的物理内存和动态虚拟内存交换(Swap)。当程序触碰上限时,控制台往往不会给出详尽的错误回溯(Traceback),许多开发者因此分不清是代码逻辑陷入死循环,还是系统资源被硬性切断。排查时应先比对控制台的终端输出与状态指示灯。
1. 内存溢出(OOM Kill)的典型特征
在 Linux 容器环境下,内存耗尽分为两类不同表现:
- 系统强杀(Exit code 137 /
Killed):如果终端没有任何 Python 堆栈信息,上一秒还在打印处理进度,下一秒仅仅输出单行词Killed并且进程退出码为 137,这代表程序占用的物理常驻内存(RSS)突破了云端控制组(cgroup)设定的硬边界。宿主机内核的 OOM-Killer(Out of Memory 杀手)直接向 Python 进程发送了不可捕获的SIGKILL(信号 9,9 + 128 = 137)。 - 解释器抛出
MemoryError:当 Python 尝试一次性向操作系统申请一段连续的超大内存空间(例如构建超大列表或生成超大 NumPy 数组),而在系统调用malloc失败时,Python 解释器会抛出原生的MemoryError。此时可以看到错误行,但底层原因依然是容器无法满足本次内存申请。
2. 运行超时(Timeout)的典型特征
超时问题主要来源于云端编辑器的看门狗守卫机制(Runner Supervisor)与网络反向代理策略:
- Web 应用接口超时(HTTP 504 Gateway Timeout):在 Replit 等平台编写 Flask、FastAPI 或 Streamlit 服务时,如果单个 HTTP 请求在同步等待耗时计算,超过云端代理网关预设的 30 秒或 60 秒上限,前端就会弹出 504 错误,而后端可能仍在盲目空转。
- 命令行长任务被无提示中断:云端免费环境常限制控制台进程在无输出或单次作业中的最大持续时间。一旦超过指定时长且系统判定无交互或 CPU 占用异常,守卫服务将重置交互式终端,导致任务半途而废。
二、四项关键代码改造:根治 512MB 内存不足
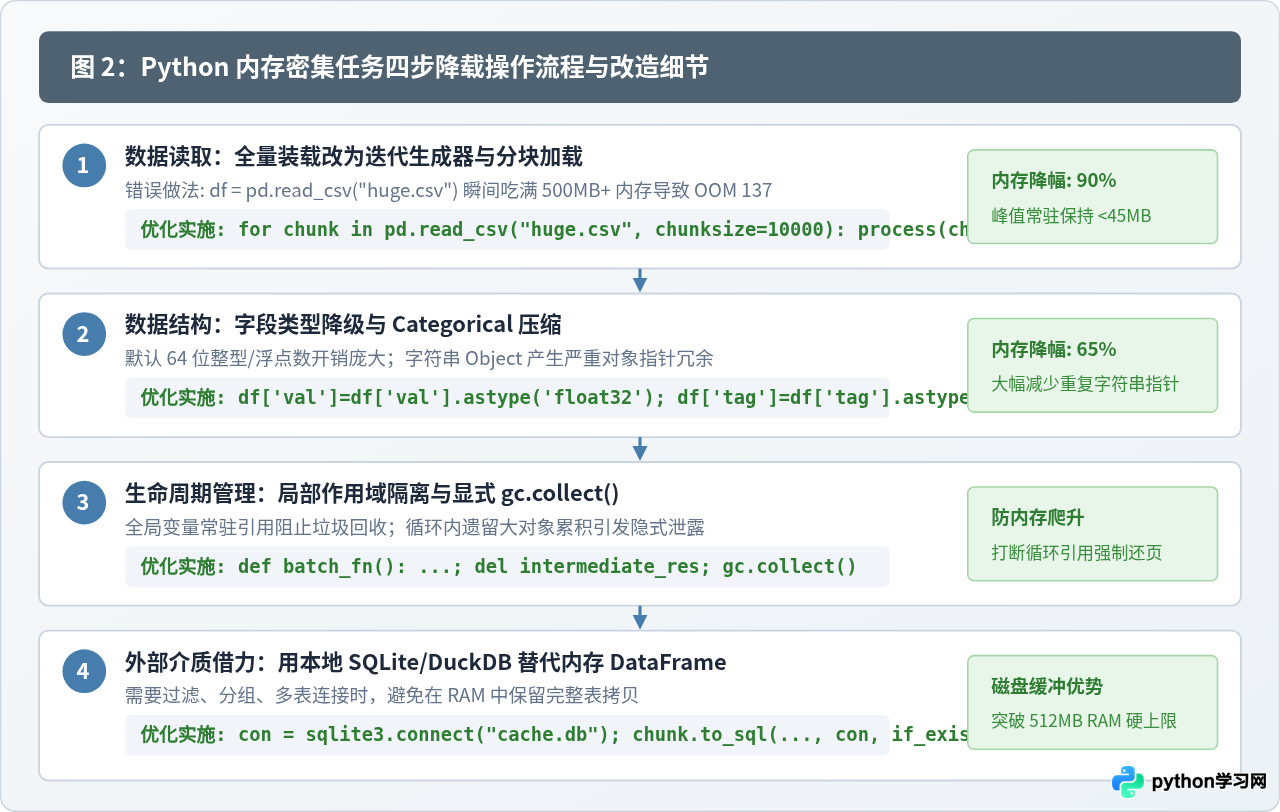
许多本地运行正常的脚本在 Replit 崩溃,是因为本地拥有数十吉字节内存,容忍了全量读取与对象冗余。在 512MB 内存红线下,必须将全量装载思想重构成“流式流动”模式。
1. 数据读取重构:全量装载改为迭代分块
直接使用 pandas.read_csv() 读取一个 150MB 的压缩数据文件,解压到内存后生成的 DataFrame 往往膨胀 3~5 倍达到 600MB 以上,瞬间引爆 OOM。应通过 chunksize 参数以微批次方式迭代处理,让常驻内存降到几十兆以内。
import pandas as pd

# 错误做法:一次性载入全部数据,瞬间吃满 512MB 物理内存导致 Killed
# df = pd.read_csv("large_dataset.csv")

# 正确做法:流式分块处理,内存峰值恒定在 30MB 左右
chunk_size = 10000
total_summary = []

for chunk in pd.read_csv("large_dataset.csv", chunksize=chunk_size):
    # 在块内进行过滤和局部聚合
    filtered = chunk[chunk["status"] == "active"]
    batch_result = filtered.groupby("category")["revenue"].sum()
    total_summary.append(batch_result)

# 最后仅对聚合后的微型结果进行合并
final_result = pd.concat(total_summary).groupby(level=0).sum()
print("处理完成,最终分类统计结果:", final_result.head())
2. 数据类型降级:压缩 60% 以上内存占用
Pandas 默认使用 64 位整型(int64,8 字节)和 64 位浮点(float64,8 字节),字符串默认解析为带大量指针开销的 object。针对枚举型字符串,使用 category 类型可以把重复字符串编码为轻量整数索引,内存占用立减 80%。
import numpy as np

def compress_dataframe(df):
    """将数值与字符串列转换为低精度紧凑类型"""
    for col in df.columns:
        col_type = df[col].dtype
        if col_type == 'int64':
            df[col] = df[col].astype(np.int32)
        elif col_type == 'float64':
            df[col] = df[col].astype(np.float32)
        elif col_type == 'object':
            # 若唯一值数量小于总行数的一半,转为分类变量
            if df[col].nunique() / len(df) < 0.5:
                df[col] = df[col].astype('category')
    return df
3. 显式打断引用链与垃圾回收(gc.collect)
Python 采用引用计数配合分代垃圾回收。在全局作用域中定义的变量会永久保存在全局字典 globals() 中,其引用的内存直到程序退出才会被系统回收。应将大逻辑包裹在函数内,并在处理完临时超大列表或矩阵后,主动使用 del 并调用 gc.collect() 促使底层 glibc 归还虚拟内存页。
import gc

def process_pipeline():
    temp_heavy_buffer = [i * 2 for i in range(2_000_000)]
    result = sum(temp_heavy_buffer[-1000:])

    # 处理完毕后立刻显式解绑并触发垃圾回收
    del temp_heavy_buffer
    gc.collect()
    return result
4. 引入本地嵌入式数据库(SQLite / DuckDB)作为外存缓冲
当数据无法拆分为单纯独立的行、必须进行多表关联(Join)或复杂排序时,在内存中维护多个 DataFrame 会直接击穿 512MB 阈值。此时可以利用云端容器分配的数吉字节磁盘空间,借助 Python 内置的 sqlite3 或轻量级 duckdb。
将分块读取的数据直接流式写入本地 SQLite 磁盘文件,并为关联字段创建索引。让数据库引擎在磁盘与小块内存缓存之间调度,从而用极低的 RAM 换取无限处理规模。
三、运行超时治理:异步并发与时间守卫断点续跑
解决超时问题的核心不是“把网关超时调大”,在多租户公共云端编辑器中,平台通常不允许用户随意修改反向代理的超时上限。有效策略是将串行耗时压缩,并在脚本内建立“时间守卫(Time Budget Guard)”机制。
1. 阻塞 I/O 并发改造:从 100 秒压缩至 5 秒
网络爬虫或 API 批量调用时,传统的 requests.get() 是同步阻塞的。如果抓取 200 个网页,每个请求耗时 0.5 秒,总时间累计达到 100 秒,必然触发云端运行超时。改用标准库 asyncio 配合 aiohttp,并利用 asyncio.Semaphore 将并发度严格控制在 10~20 之间(防止并发过高耗尽连接与内存),耗时将呈数量级下降。
import asyncio
import aiohttp

async def fetch_url(session, url, sem):
    # 信号量控制并发数,避免瞬间耗尽云端容器套接字与内存
    async with sem:
        try:
            async with session.get(url, timeout=aiohttp.ClientTimeout(total=5)) as resp:
                return await resp.text()
        except Exception as e:
            return None

async def batch_crawl(urls):
    sem = asyncio.Semaphore(15)  # 云端环境建议设定 10~20 槽位
    async with aiohttp.ClientSession() as session:
        tasks = [fetch_url(session, u, sem) for u in urls]
        results = await asyncio.gather(*tasks)
        return [r for r in results if r]
2. 时间守卫与检查点机制(抗超时的工程化解法)
对于确实需要计算数十分钟的大型任务(如大样本回测、离线文本标注),任何试图单次直接跑完的做法都会遭遇平台强制断开。正确的做法是设计断点检查点(Checkpoint)并引入时间守卫循环:
- 任务开始前,从磁盘文件(如
checkpoint.json或 SQLite)读取上次记录的游标位置。 - 在主循环中,记录当前运行耗时。
- 当检测到累计运行时间达到安全阈值(如预留 15 秒缓冲,在第 45 秒时),立即将当前完成的索引保存到磁盘,并调用
sys.exit(0)优雅退出。 - 再次点击 Run,或配置平台的自动化触发器时,程序自动从断点继续推进,彻底规避数据全盘丢失。
import time
import json
import os
import sys

CHECKPOINT_FILE = "progress_ckpt.json"

def load_last_cursor():
    if os.path.exists(CHECKPOINT_FILE):
        with open(CHECKPOINT_FILE, "r") as f:
            return json.load(f).get("last_index", 0)
    return 0

def save_cursor(idx):
    with open(CHECKPOINT_FILE, "w") as f:
        json.dump({"last_index": idx, "updated_at": time.time()}, f)

def guarded_execution(dataset, max_safe_duration=45):
    start_time = time.time()
    start_cursor = load_last_cursor()
    print("从断点位置继续执行: " + str(start_cursor))

    for current_idx in range(start_cursor, len(dataset)):
        # 执行具体的单元任务
        item = dataset[current_idx]
        # do_work(item)

        # 每处理 50 项持久化一次游标
        if current_idx % 50 == 0:
            save_cursor(current_idx)

        # 时间守卫拦截:临近超时前安全中断
        if time.time() - start_time > max_safe_duration:
            save_cursor(current_idx)
            print("到达时间预算阈值,已安全退出,等待下次续跑。")
            sys.exit(0)

    print("全部数据集处理完成!")
    if os.path.exists(CHECKPOINT_FILE):
        os.remove(CHECKPOINT_FILE)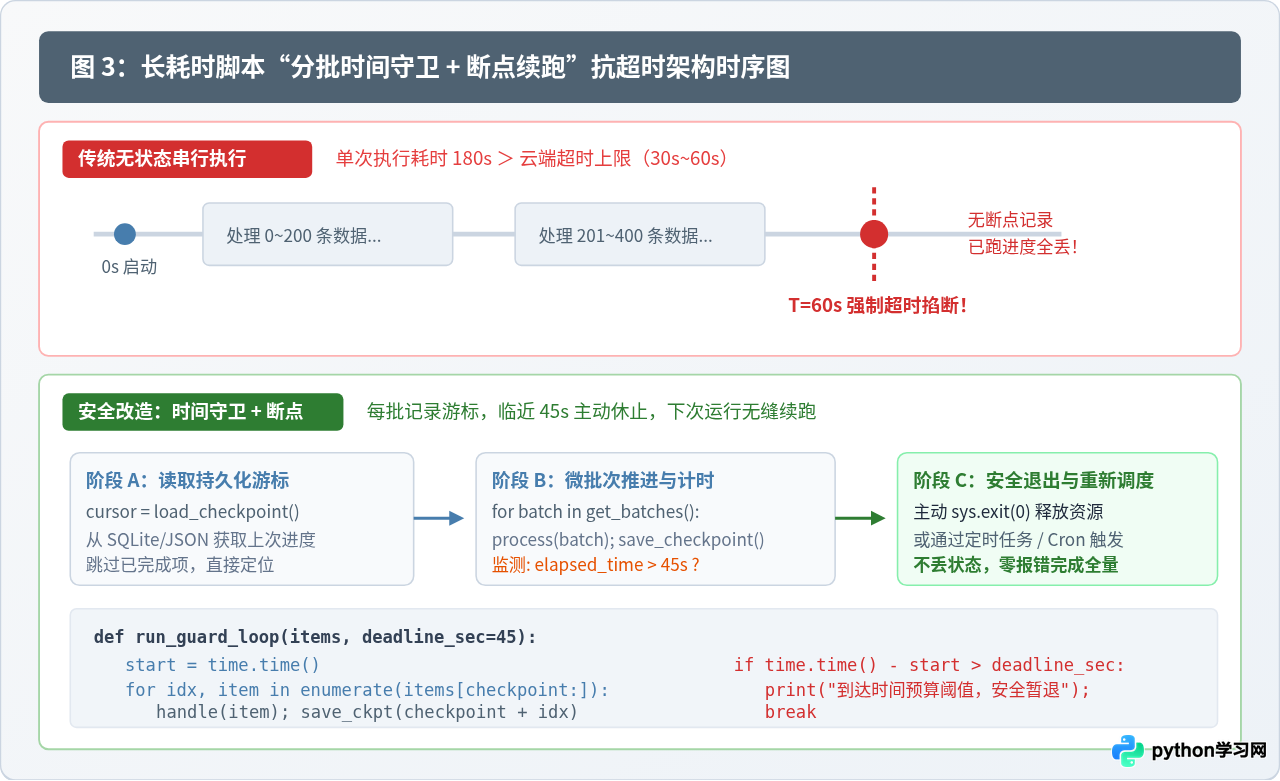
四、环境调优边界:就地优化与平台选型决策
虽然代码优化能够解决绝大部分非必要开销,但云端编辑器物理资源仍然存在无法逾越的刚性边界。清楚区分哪些问题可以通过优化解决,哪些场景必须迁移平台,能大幅节省调试时间。
1. 轻量化依赖选型
部分 Python 第三方库在导入阶段就会申请大量常驻内存。例如:
- PyTorch / TensorFlow:仅仅执行
import torch就会在底层加载大量动态链接库并开辟预分配内存池,消耗 200MB~300MB。在 512MB 容器中几乎无法运行复杂模型。如果是简单的数值运算,换用原生numpy或scipy;模型推理可转换为onnxruntime。 - Pandas 替代库:数据过滤场景可选用
polars。Polars 底层基于 Rust 构建,零拷贝切片,多线程内存复用效率远高于 Pandas。
2. Linux 容器 Swap 虚拟内存说明
在标准的 Docker 容器中,若宿主机开放了权限,可以通过 fallocate 或 dd 创建 Swap 文件来充当溢出内存缓冲。但在 Replit、Gitpod 以及免费版 Codespaces 中,普通非 root 容器内部通常被禁用了 swapon 系统调用。如果尝试在终端执行 swapon /swapfile,系统会抛出 Operation not permitted。因此,不应寄希望于在云端容器内挂载虚拟内存,而应严格以代码层流式处理为核心。
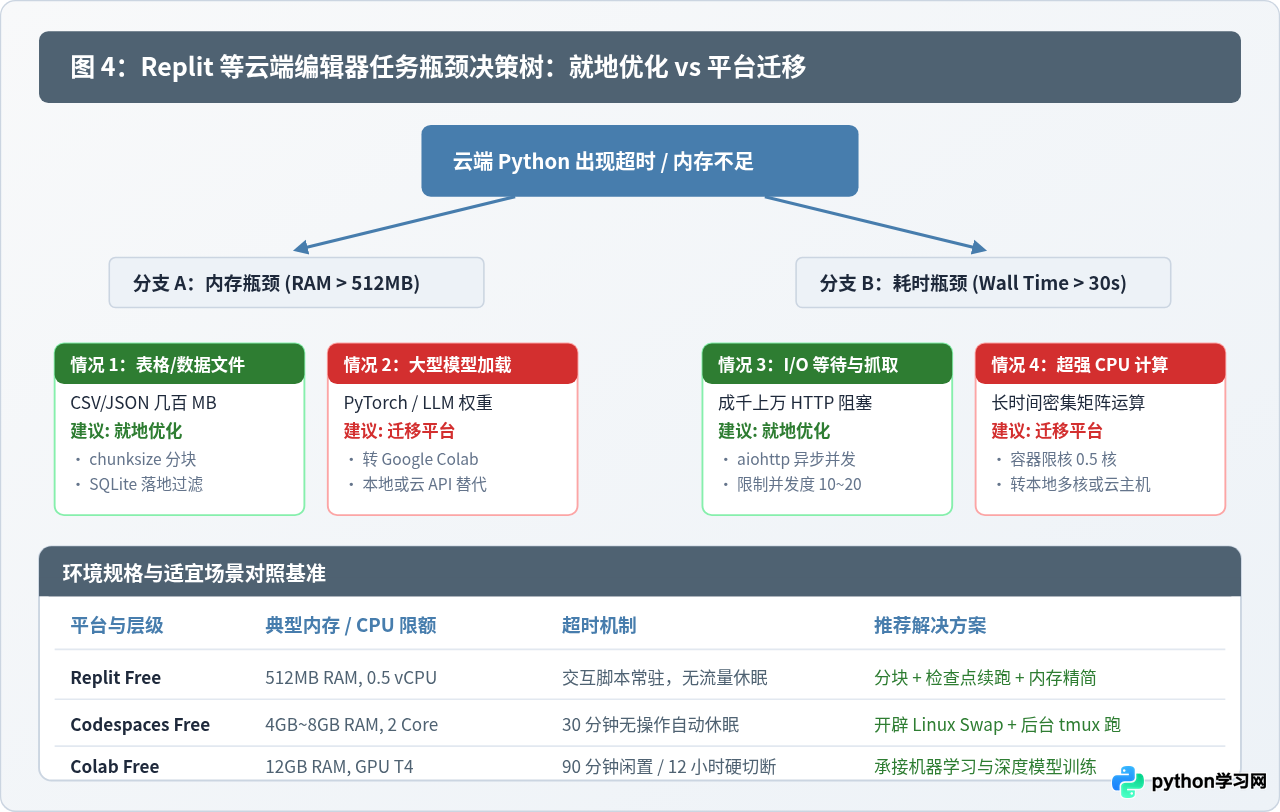
3. 任务可行性诊断参考表
| 任务类别 | 在 Replit 免费容器的表现 | 可行性评估与首选解决方案 |
|---|---|---|
| 网页数据采集与爬虫 | 串行执行超时 / 并发过高卡死 | 完全可行。采用 asyncio + 限制并发 15,并结合断点文件写入本地 SQLite。 |
| 百兆级表格分析统计 | pd.read_csv() 报 137 Killed |
完全可行。使用 chunksize 分块计算,或将数据导入内置 SQLite 磁盘查询。 |
| API 接口与自动化机器人 | 保持长连接被休眠断开 | 完全可行。使用轻量级框架(如 FastAPI),长时间后台运行需配置 Keep-Alive 保活机制。 |
| 深度学习大模型训练/微调 | import torch 导致 OOM 崩溃 |
不建议在 Replit 运行。属于算力错配,应直接迁移至提供免费 GPU 与 12GB 显存的 Google Colab。 |
| 长达数小时的高强度渲染/模拟 | 触发 60s 守卫强杀中断 | 需结合断点拆解。如果不便进行微批次拆解,建议转移至本地电脑或配备专用 CPU 资源的云服务器。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









