

Python批量读取文件夹下所有图片的实现代码
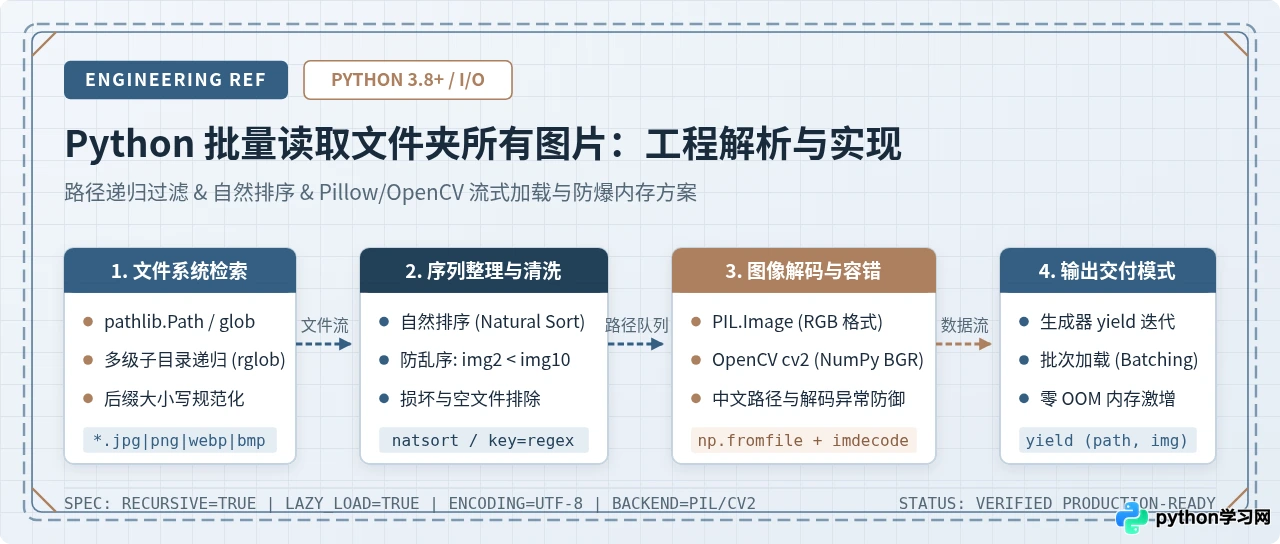
本文详细讲解如何使用Python批量读取文件夹下的所有图片,对比pathlib、os.walk与glob等核心扫描机制,提供Pillow与OpenCV解码、自然排序、中文路径处理及防内存溢出(OOM)生成器的完整实现代码。
pathlib、os.walk 与 glob 的选型差异,并针对工业场景下常见的多级子目录、非 ASCII 中文路径、文件名乱序以及海量图片导致内存溢出(OOM)等实际问题给出针对性的解决方案。
一、批量读图的整体执行流程
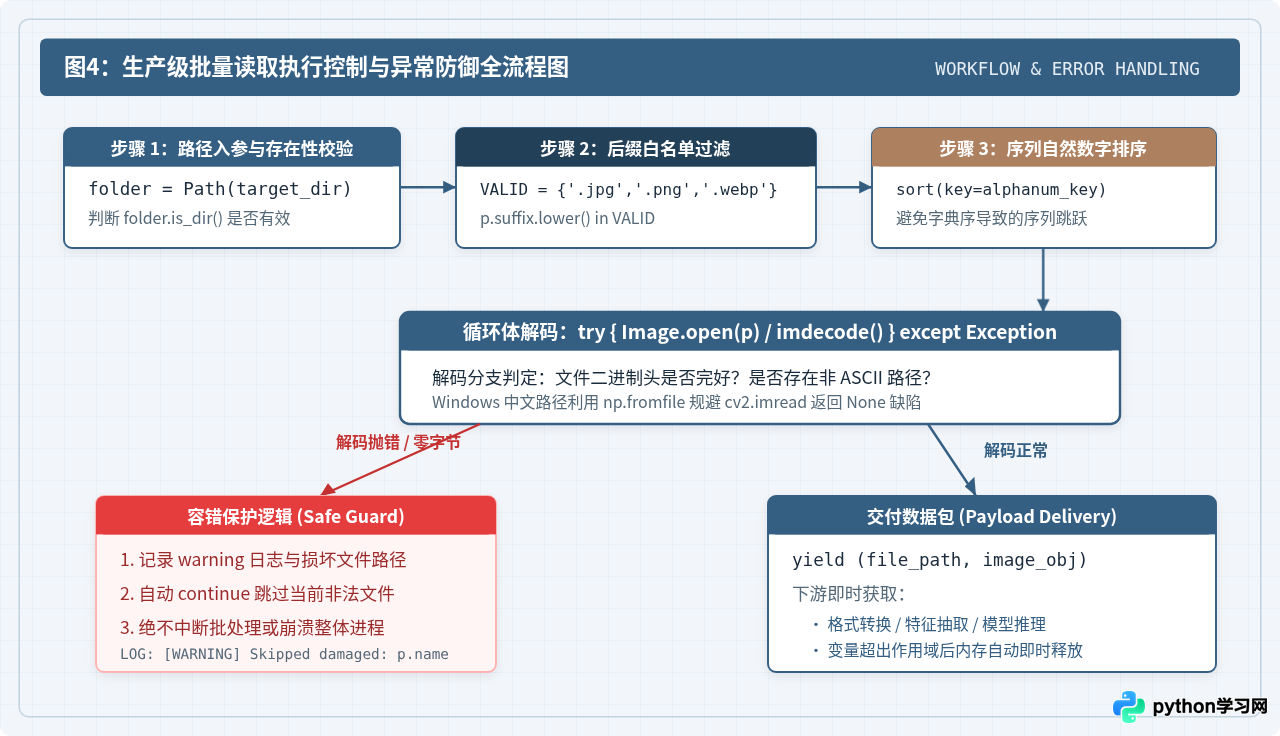
在实际编写代码前,需要明确图片读取并不是简单地写一个循环把所有图片直接塞进列表。如果不做规范化处理,极易遭遇隐藏格式文件干扰、数字排序错乱以及内存暴增崩溃等状况。规范的工程处理流程如下图所示:
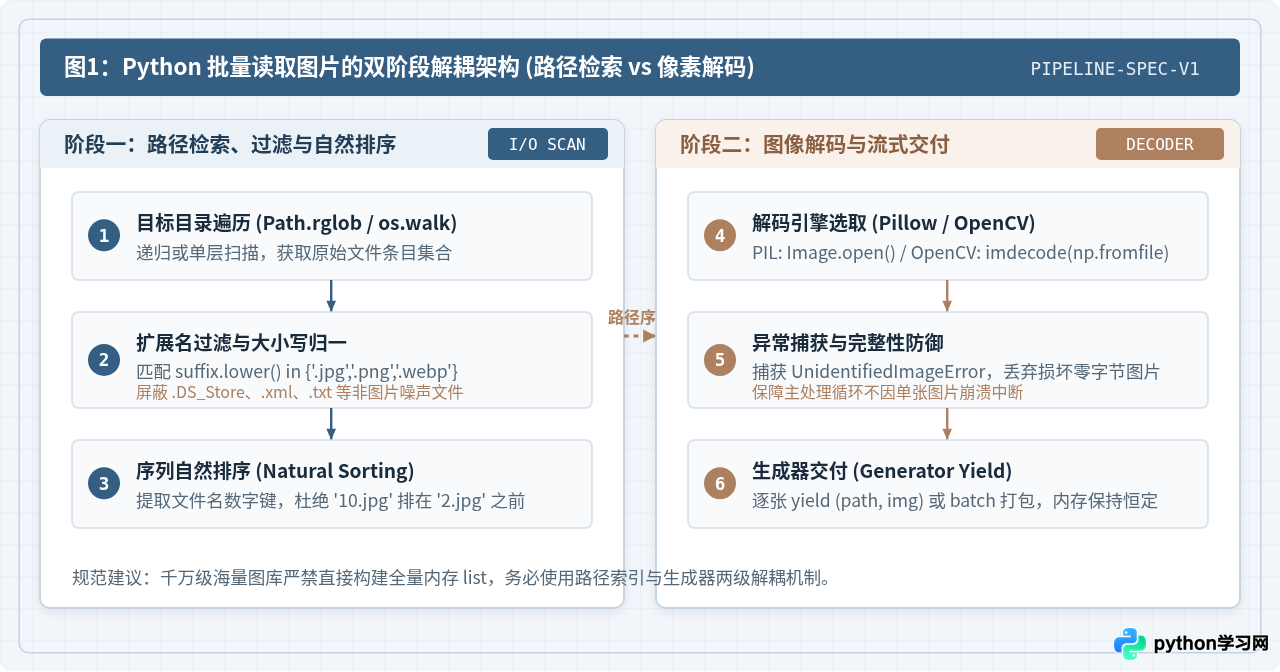
整个流程严格解耦为两部分:
- 路径筛选阶段:遍历目录树,使用后缀白名单集合(如
.jpg、.png、.webp)过滤掉无用文件,并通过自然数字排序规则保证读取顺序与人类直觉一致。 - 数据解码阶段:针对筛选出的有效路径,选择 PIL 或 OpenCV 解码器,并使用 Python 生成器(
yield)进行流式交付,确保内存占用恒定。
二、三种主流文件遍历方案对比与实现
Python 标准库提供了多种检索文件路径的方式。在编写批量读图脚本时,最常用的三种分别是 pathlib.Path、os.walk 以及 glob.iglob。
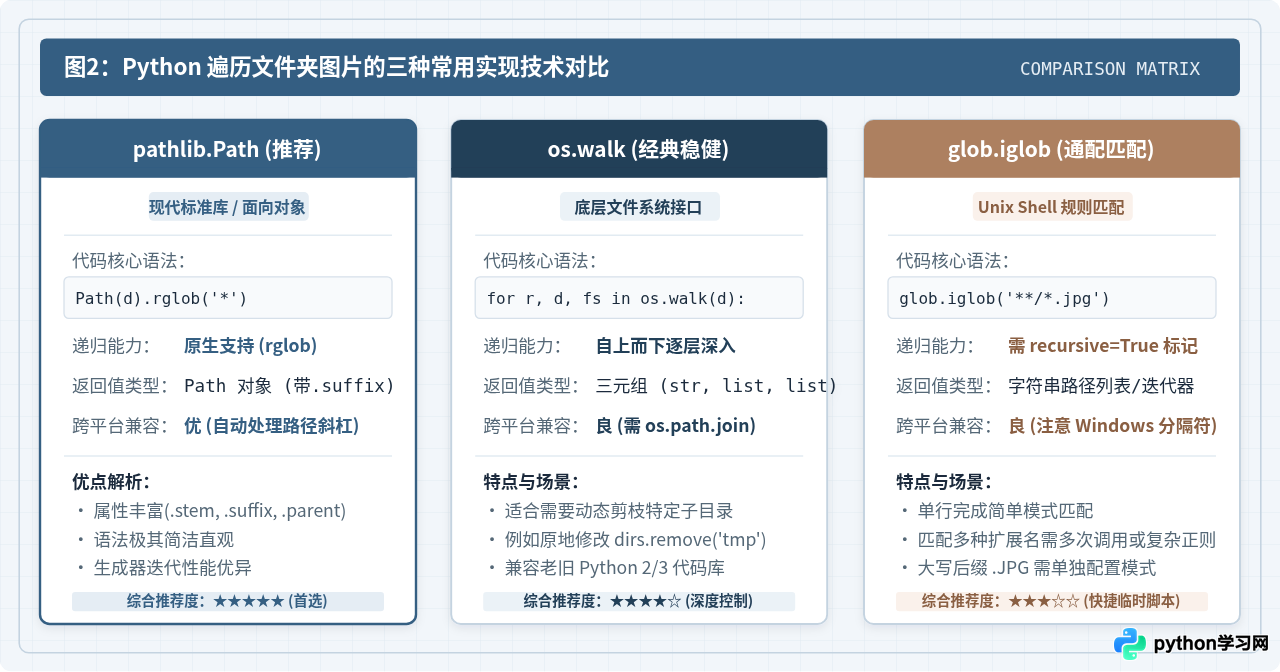
方案 1:使用 pathlib 模块(现代标准库,首选推荐)
pathlib 是 Python 3.4 引入的面向对象路径处理模块。它的语法清晰,跨操作系统(Windows、macOS、Linux)能够自动处理路径分隔符差异,其 rglob() 方法支持高效递归遍历子目录。
from pathlib import Path
from PIL import Image

def get_image_paths_pathlib(folder_path, recursive=True):
    """
    使用 pathlib 检索目录下所有支持的图片路径
    :param folder_path: 目标文件夹路径 (str 或 Path)
    :param recursive: 是否递归遍历多级子目录
    :return: 排序后的 Path 对象列表
    """
    # 定义合法的图片扩展名白名单(全部统一为小写)
    VALID_EXTENSIONS = {'.jpg', '.jpeg', '.png', '.bmp', '.webp', '.tiff'}

    root_dir = Path(folder_path)
    if not root_dir.is_dir():
        raise NotADirectoryError(f"指定的目录不存在: {folder_path}")

    # 根据参数选择递归检索或仅当前目录检索
    scanner = root_dir.rglob('*') if recursive else root_dir.glob('*')

    # 过滤出符合图片后缀的文件
    image_paths = [
        file_path for file_path in scanner
        if file_path.is_file() and file_path.suffix.lower() in VALID_EXTENSIONS
    ]

    # 按文件名排序
    image_paths.sort(key=lambda p: p.name)
    return image_paths

# 使用示例
if __name__ == '__main__':
    target_dir = "./sample_images"
    paths = get_image_paths_pathlib(target_dir, recursive=True)
    print(f"成功扫描到图片数量: {len(paths)}")
    for p in paths[:3]:
        print(f"路径: {p} | 大小: {p.stat().st_size} 字节")
方案 2:使用 os.walk(适合需要精确控制目录剪枝的场景)
当图片数据集包含大量不需要遍历的系统缓存目录(例如 .git、__pycache__、.ipynb_checkpoints)时,使用 os.walk 可以在遍历过程中通过就地修改 dirnames 列表直接跳过整个目录分支,避免无谓的磁盘 I/O 消耗。
import os

def get_image_paths_os_walk(folder_path):
    """
    使用 os.walk 深度优先遍历目录,支持就地跳过指定子目录
    :param folder_path: 目标根目录
    :return: 完整绝对路径字符串列表
    """
    VALID_EXTENSIONS = ('.jpg', '.jpeg', '.png', '.bmp', '.webp', '.tiff')
    image_paths = []

    for root, dirs, files in os.walk(folder_path):
        # 剪枝操作:就地修改 dirs,跳过忽略目录
        dirs[:] = [d for d in dirs if not d.startswith('.') and d not in ('temp', 'cache')]

        for filename in files:
            # 扩展名转小写比对
            if filename.lower().endswith(VALID_EXTENSIONS):
                full_path = os.path.join(root, filename)
                image_paths.append(full_path)

    image_paths.sort()
    return image_paths
方案 3:使用 glob 模块(适合快捷单行模式匹配)
如果只需要抓取特定目录下的某一种格式(例如只找 .png 图片),使用 glob.iglob 可以用最少的代码完成任务。注意在递归时必须开启 recursive=True 参数:
import glob

def get_images_glob(folder_path):
    """
    使用 glob.iglob 获取图片路径迭代器
    """
    pattern = f"{folder_path}/**/*.jpg"
    # iglob 返回生成器,比 glob.glob 立即返回大列表更加节省内存
    for img_path in glob.iglob(pattern, recursive=True):
        yield img_path
三、像素解码与内存优化:生成器模式防爆内存
获取到图片路径之后,接下来的操作是将图片解码并供下游业务(如深度学习预处理、批量转码或缩放)使用。初学者常犯的错误是将所有图片通过 cv2.imread 或 Image.open 全部读入一个大列表,这在大图库中会直接触发 MemoryError 导致系统崩溃。
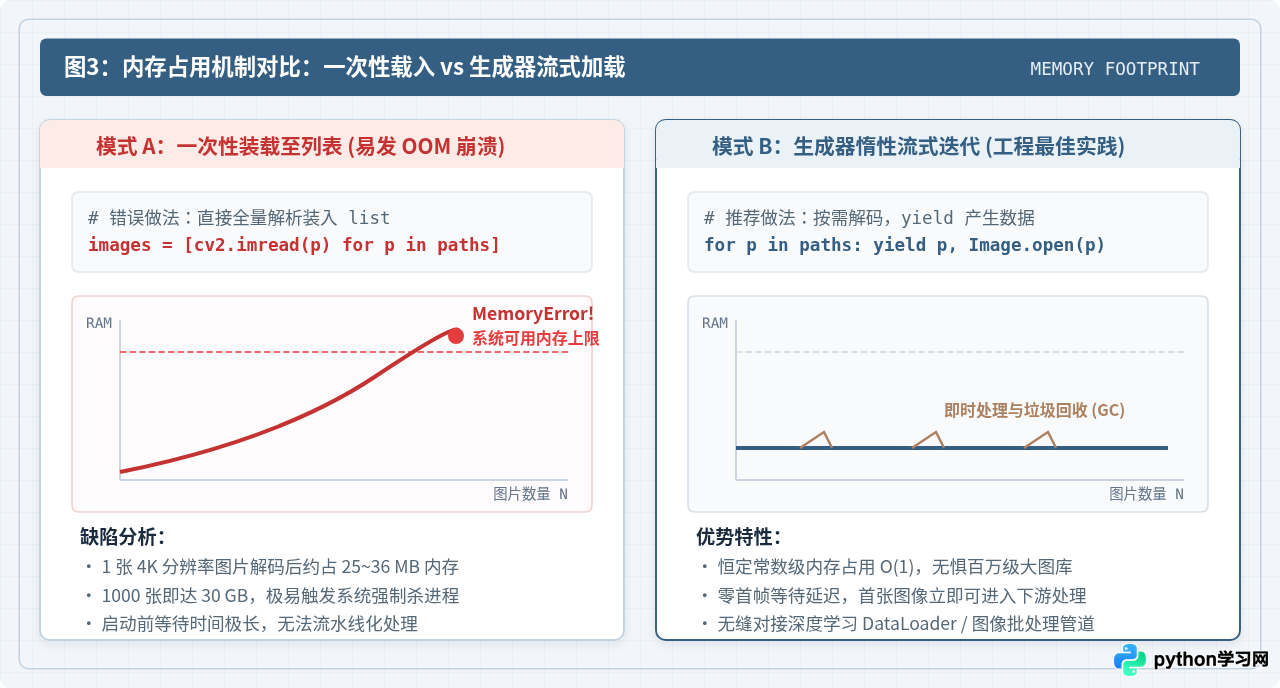
一张典型的 4K 手机拍摄照片(分辨率 4032 × 3024,3 通道 RGB)在硬盘中经过压缩可能仅有 3~5 MB,但在解码为未压缩的 NumPy 矩阵后,内存占用计算如下:
4032 × 3024 × 3 字节 ≈ 36,578,304 字节 ≈ 34.88 MB
若文件夹下有 500 张类似图片,一次性加载进列表将直接消耗超过 17.4 GB 内存。为了保持内存恒定,必须采用 Python 生成器(Generator),实现逐张或按 Batch 解码交付:
from pathlib import Path
from PIL import Image, UnidentifiedImageError

def read_images_stream(folder_path, recursive=True):
    """
    流式批量读取图片生成器
    每次 yield 吐出一个元组: (Path对象, PIL.Image对象)
    处理完毕后自动被垃圾回收,内存维持恒定 O(1)
    """
    VALID_EXTENSIONS = {'.jpg', '.jpeg', '.png', '.bmp', '.webp'}
    root_dir = Path(folder_path)

    # 路径收集与自然排序
    paths = [
        p for p in (root_dir.rglob('*') if recursive else root_dir.glob('*'))
        if p.is_file() and p.suffix.lower() in VALID_EXTENSIONS
    ]
    paths.sort(key=lambda p: p.name)

    for img_path in paths:
        try:
            # 使用上下文管理器确保文件句柄安全释放
            with Image.open(img_path) as img:
                # 触发实际像素加载并深拷贝脱离文件句柄依赖
                img_data = img.copy()
            yield img_path, img_data

        except (UnidentifiedImageError, OSError) as err:
            # 捕获损坏文件、空文件或非标准文件格式,跳过并记录告警
            print(f"[警告] 图片损坏或格式非法已跳过: {img_path},错误: {err}")
            continue
四、关键细节与踩坑排查
在实际工业化运行中,批量读取图片往往会遭遇多种边界情况。以下列出四项核心注意事项及对应的解决方案。
1. 文件名自然排序(解决 10.jpg 排在 2.jpg 前面的问题)
Python 默认的字符串排序(list.sort())采用 ASCII 字典序。对于名称包含数字的文件,会出现如下非预期排序:
解决方法是使用正则表达式提取文件名中的数字作为排序权重键(Natural Sort Key):
import re

def natural_sort_key(path_obj):
    """
    将路径中的纯文本与数字段拆解为混合元组
    例: 'img_10.png' -> ['img_', 10, '.png']
    """
    name = path_obj.name if hasattr(path_obj, 'name') else str(path_obj)
    return [int(text) if text.isdigit() else text.lower() for text in re.split(r'(\d+)', name)]

# 在排序时直接传入该 key 函数:
# image_paths.sort(key=natural_sort_key)
2. OpenCV 读取中文路径返回 None 的陷阱
在 Windows 环境下,若图片文件的绝对路径中包含中文字符,直接调用 cv2.imread(path) 不会抛出异常,而是会静默返回 None,导致后续代码在调用 img.shape 时出现 'NoneType' object has no attribute 'shape' 报错。
numpy.fromfile() 读取底层二进制缓冲流,再利用 cv2.imdecode() 转换为图像矩阵。该方法跨平台兼容性极佳。
import cv2
import numpy as np

def cv2_imread_unicode(file_path):
    """
    安全读取包含中文或特殊字符路径的图片
    :param file_path: 路径字符串或 Path 对象
    :return: BGR 格式的 numpy.ndarray,失败返回 None
    """
    try:
        # 使用 numpy 二进制读取规避 C++ 底层路径编码问题
        raw_bytes = np.fromfile(str(file_path), dtype=np.uint8)
        img = cv2.imdecode(raw_bytes, cv2.IMREAD_COLOR)
        return img
    except Exception as e:
        print(f"[读取失败] 无法解析: {file_path}, 原因: {e}")
        return None
3. Pillow 与 OpenCV 的色彩通道差异
在批量处理后若需要将图片转入下游机器学习框架,务必注意通道顺序:
PIL.Image.open()解码后默认格式为 RGB。cv2.imread()或cv2.imdecode()解码后默认格式为 BGR。- 若混用两者,必须通过
cv2.cvtColor(img, cv2.COLOR_BGR2RGB)进行显式转换,否则会导致颜色通道颠倒(例如红蓝互换)。
五、完整工程级实现模板与运行验证
综合上述所有关键技术点(包含 pathlib 递归检索、扩展名过滤、自然排序、OpenCV 中文路径兼容、生成器惰性加载与异常保护),以下提供一份可以直接投入生产环境的完整模块代码:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
模块名称:batch_image_reader.py
功能描述:工业级 Python 批量读取文件夹下所有图片
特性支持:
  1. 支持单层或多级递归子目录扫描
  2. 扩展名白名单大小写无感过滤 (.jpg, .JPG, .png, .WEBP 等)
  3. 正则表达式实现的数字自然排序 (1, 2, ..., 10)
  4. 支持 Pillow (RGB) 与 OpenCV (BGR) 双解码后端
  5. 兼容 Windows 中文与特殊符号路径
  6. 生成器流式 yield 交付,恒定低内存占用
  7. 损坏文件与零字节文件自动拦截并告警
"""

import os
import re
from pathlib import Path
from typing import Generator, Tuple, Union, Optional
import numpy as np
import cv2
from PIL import Image, UnidentifiedImageError

def natural_keys(path_obj: Path):
    """自然排序键生成函数"""
    return [int(c) if c.isdigit() else c.lower() for c in re.split(r'(\d+)', path_obj.name)]

def batch_load_images(
    folder_dir: Union[str, Path],
    recursive: bool = True,
    backend: str = 'opencv'
) -> Generator[Tuple[Path, Union[np.ndarray, Image.Image]], None, None]:
    """
    批量读取指定目录下的图片
    :param folder_dir: 目标图片文件夹路径
    :param recursive: 是否递归遍历子文件夹,默认为 True
    :param backend: 解码后端,可选 'opencv' 或 'pillow'
    :yield: (图片Path对象, 解码后的图像数据)
    """
    # 1. 检验目录有效性
    folder_path = Path(folder_dir)
    if not folder_path.is_dir():
        raise NotADirectoryError(f"指定的目录不存在或不是有效文件夹: {folder_dir}")

    # 2. 支持的图片后缀集合 (全小写)
    SUPPORTED_EXTS = {'.jpg', '.jpeg', '.png', '.bmp', '.webp', '.tiff', '.tif'}

    # 3. 扫描路径
    iterator = folder_path.rglob('*') if recursive else folder_path.glob('*')
    image_paths = [
        p for p in iterator
        if p.is_file() and p.suffix.lower() in SUPPORTED_EXTS
    ]

    # 4. 执行自然排序
    image_paths.sort(key=natural_keys)

    # 5. 循环流式解码
    for p in image_paths:
        try:
            # 过滤 0 字节损坏文件
            if p.stat().st_size == 0:
                print(f"[警告] 跳过零字节空文件: {p.name}")
                continue

            if backend.lower() == 'opencv':
                # 安全读取中文路径
                raw_bytes = np.fromfile(str(p), dtype=np.uint8)
                img = cv2.imdecode(raw_bytes, cv2.IMREAD_COLOR)
                if img is None:
                    print(f"[警告] OpenCV 无法解码该文件: {p.name}")
                    continue
                yield p, img

            elif backend.lower() == 'pillow':
                with Image.open(p) as img_obj:
                    # 拷贝脱离文件句柄,保证像素已完全载入
                    loaded_img = img_obj.copy()
                yield p, loaded_img

            else:
                raise ValueError(f"不支持的后端类型: {backend},仅支持 'opencv' 或 'pillow'")

        except (UnidentifiedImageError, OSError, Exception) as err:
            print(f"[异常] 读取文件失败已自动跳过: {p.name},详情: {err}")
            continue


# -------------------------------------------------------------
# 运行验证示例
# -------------------------------------------------------------
if __name__ == '__main__':
    # 模拟运行与控制台输出测试
    data_directory = "./dataset/train_images"

    print(f"=== 开始扫描目录: {data_directory} ===")

    # 如果本地目录不存在,则使用当前目录演示逻辑
    sample_dir = Path("./sample_test_dir")
    sample_dir.mkdir(exist_ok=True)

    # 创建两张测试图片用于验证执行
    test_img1 = np.zeros((100, 100, 3), dtype=np.uint8)
    test_img2 = np.ones((120, 160, 3), dtype=np.uint8) * 255
    cv2.imwrite(str(sample_dir / "img_2.jpg"), test_img1)
    cv2.imwrite(str(sample_dir / "img_10.jpg"), test_img2)

    total_count = 0
    # 启动流式读取
    for path, img in batch_load_images(sample_dir, recursive=True, backend='opencv'):
        total_count += 1
        h, w, c = img.shape
        print(f"读取成功 [{total_count}]: 文件名={path.name} | 分辨率={w}x{h} | 通道数={c}")

    print(f"=== 读取任务完毕,成功载入 {total_count} 张图片 ===")
验证运行输出示例
在终端执行上述脚本后,可以看到自然排序(img_2.jpg 先于 img_10.jpg)与解码输出结果:
六、选型决策指南与总结
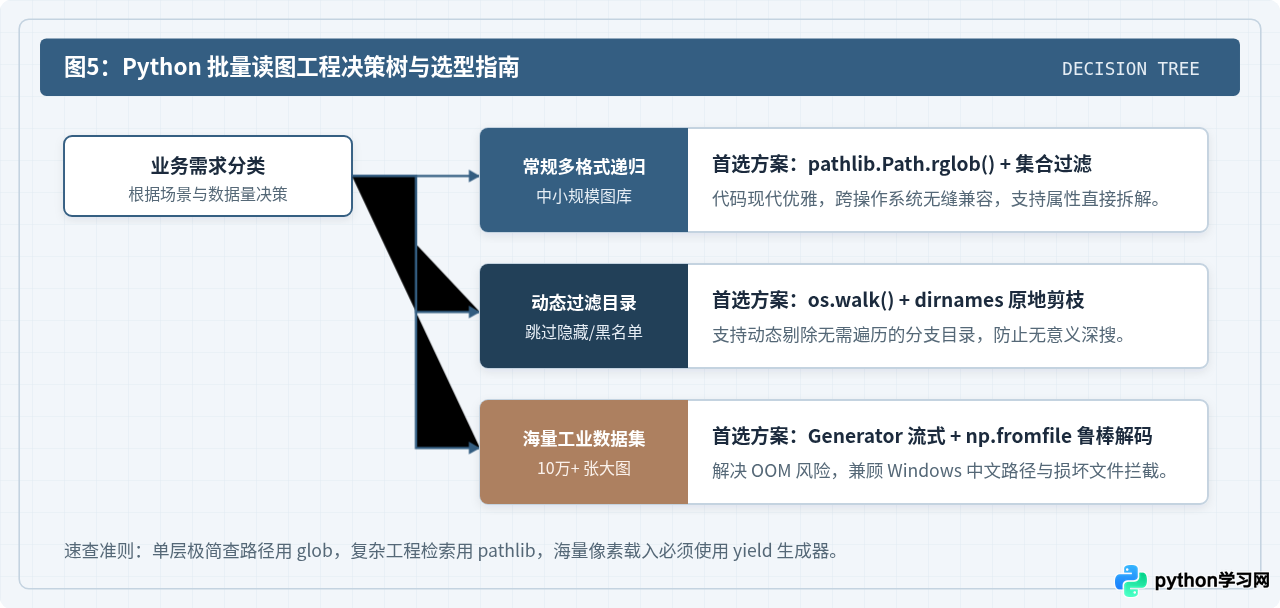
根据实际项目规模和场景特征,可参考以下决策树选择最匹配的实现方式:
| 业务场景 | 推荐文件检索方式 | 推荐图像解码方式 | 核心注意事项 |
|---|---|---|---|
| 日常脚本 / 单层文件夹 | pathlib.Path.glob() |
PIL.Image.open() |
后缀统一切换为 .lower() 匹配 |
| 复杂多层嵌套数据集 | pathlib.Path.rglob() |
batch_load_images() 生成器 |
引入自然排序避免 10.jpg 排在 2.jpg 前 |
| 需要过滤忽略指定子目录 | os.walk() |
PIL / OpenCV |
使用 dirs[:] = [...] 就地剪枝节省 I/O |
| 百万级深度学习训练集 | 预先建立 .txt/.csv 路径索引 |
cv2.imdecode(np.fromfile) |
严禁全量载入列表;按 Batch 惰性读取防 OOM |
总结而言,在现代 Python 开发中,推荐优先以 pathlib.Path 作为路径组织与过滤的基础设施,结合正则表达式自然排序保证时序一致性;在像素读取阶段,务必结合业务规模评估内存开销,通过 yield 生成器流式交付与 np.fromfile 容错机制,构建稳定、高效且跨平台可靠的批量图像处理流水线。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









