

Python wget库 vs Scrapy:哪个更适合批量下载网站所有网页?
深入对比Python wget库与Scrapy框架在批量下载全站网页时的架构差异、递归能力、并发机制与实操步骤,助你根据实际需求做出合理技术选型。
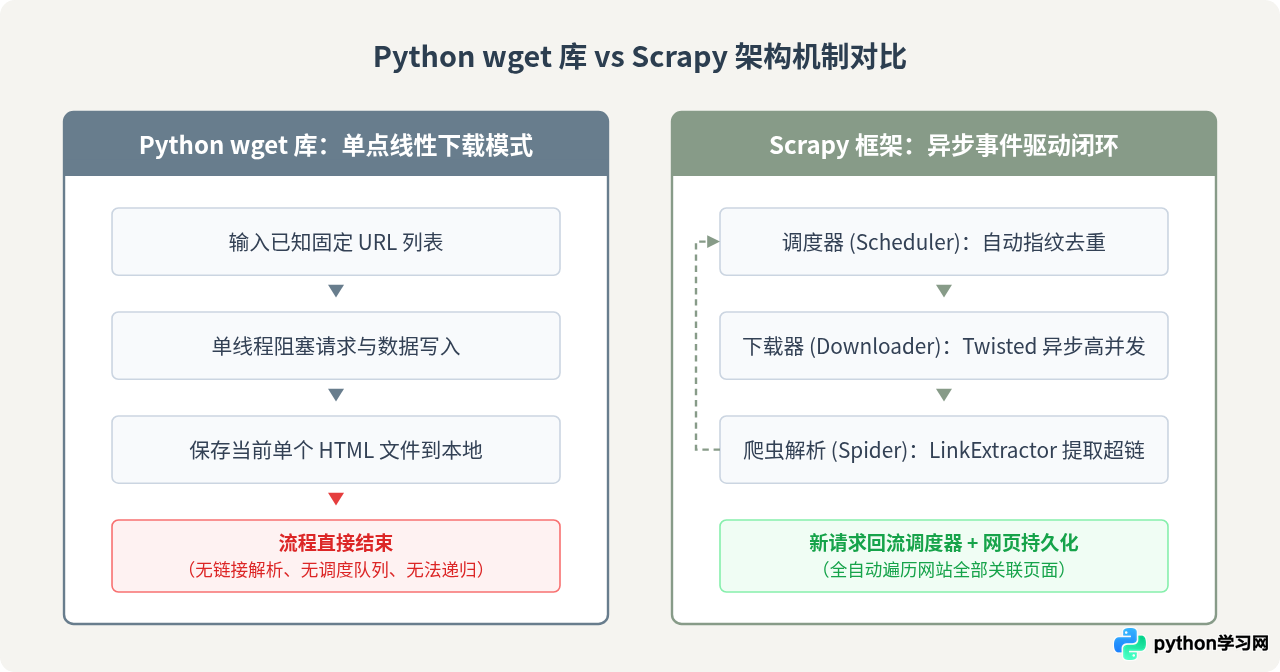
如果要批量下载某个网站的“所有网页”,Scrapy 无论在架构设计还是实际落地能力上,都远比 Python 的 wget 库更适合。造成这一结论的根本原因,在于“下载全站”本质上是一个包含超链接发现、递归遍历、排重过滤和并发调度的网络爬虫工程,而 Python 的 wget 模块仅仅是一个极简的单文件下载工具,本身并不具备解析网页和抓取新链接的能力。
一、核心认知:别把 Python wget 模块误当作 GNU wget 命令
很多初学者在选择工具时,往往会将 Linux 终端常用的 wget 命令行工具与 Python 中的 wget 库混为一谈。GNU 命令行工具 wget 确实内置了强劲的递归镜像参数(例如 wget -r -m -p https://example.com),能够自动解析 HTML 并顺着链接下载全站。然而,通过 pip install wget 安装的 Python 库只是一个轻量封装的 URL 下载器,核心作用是根据给定的具体文件地址下载资源并显示进度条。
如果只有首页 URL,Python wget 库只负责把该 HTML 文件下载到本地,既不会解析其中的 <a href="..."> 超链接,更不会自动发起后续网页的抓取。若要用 Python wget 抓取全站,开发者必须自行编写 HTML 解析逻辑、维护访问队列、处理相对路径转换并实现去重,这无异于从零手工打造一个粗糙的爬虫。而 Scrapy 作为专业的异步爬虫框架,开箱即提供了完整的抓取闭环。
二、实操场景与代码实现对比
为了直观说明两者在批量下载场景下的工作方式,我们分别考察它们在真实代码中的调用逻辑。
1. Python wget 库的实现方式与局限
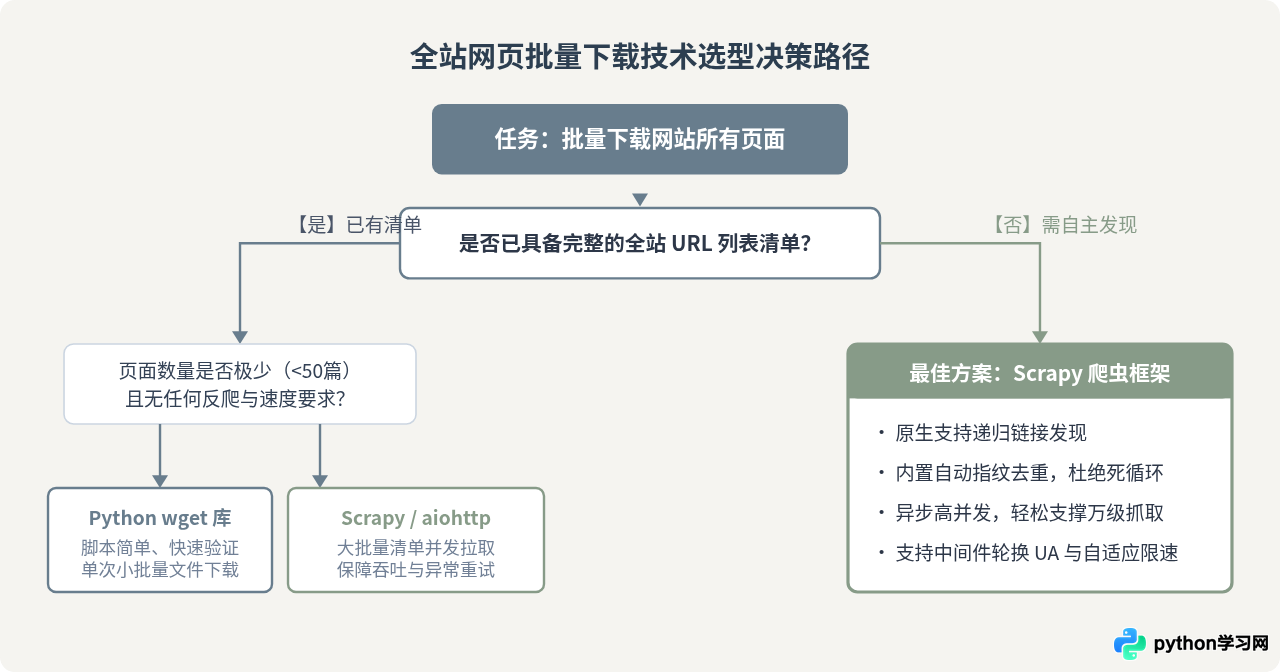
如果使用 Python 的 wget 库,它唯一适用的场景是:你已经通过站点地图(sitemap.xml)或外部导出了全站所有网页的完整 URL 列表。代码示例如下:
import os
import wget

# 必须提前准备好所有的目标 URL 列表
urls = [
    "https://example.com/page1.html",
    "https://example.com/page2.html",
    "https://example.com/page3.html"
]

output_dir = "./downloaded_pages"
os.makedirs(output_dir, exist_ok=True)

for index, url in enumerate(urls):
    filename = os.path.join(output_dir, f"page_{index}.html")
    try:
        # 单线程依次阻塞下载
        wget.download(url, out=filename)
        print(f"\n已下载: {url}")
    except Exception as e:
        print(f"\n下载失败 {url}: {e}")
上述代码暴露了三个显著缺陷:
- 依赖外部清单:如果无法直接获取所有 URL,代码寸步难行,无法自主探索全站。
- 单线程顺序执行:前一个请求未返回或发生网络超时前,整个程序处于阻塞等待状态。下载成千上万个页面将耗费极长时间。
- 缺乏重试与容错机制:遇到网络抖动、HTTP 429(请求过多)或 503 错误时,需要开发者自行捕获并实现回退算法。
2. Scrapy 自动递归抓取全站网页的实现
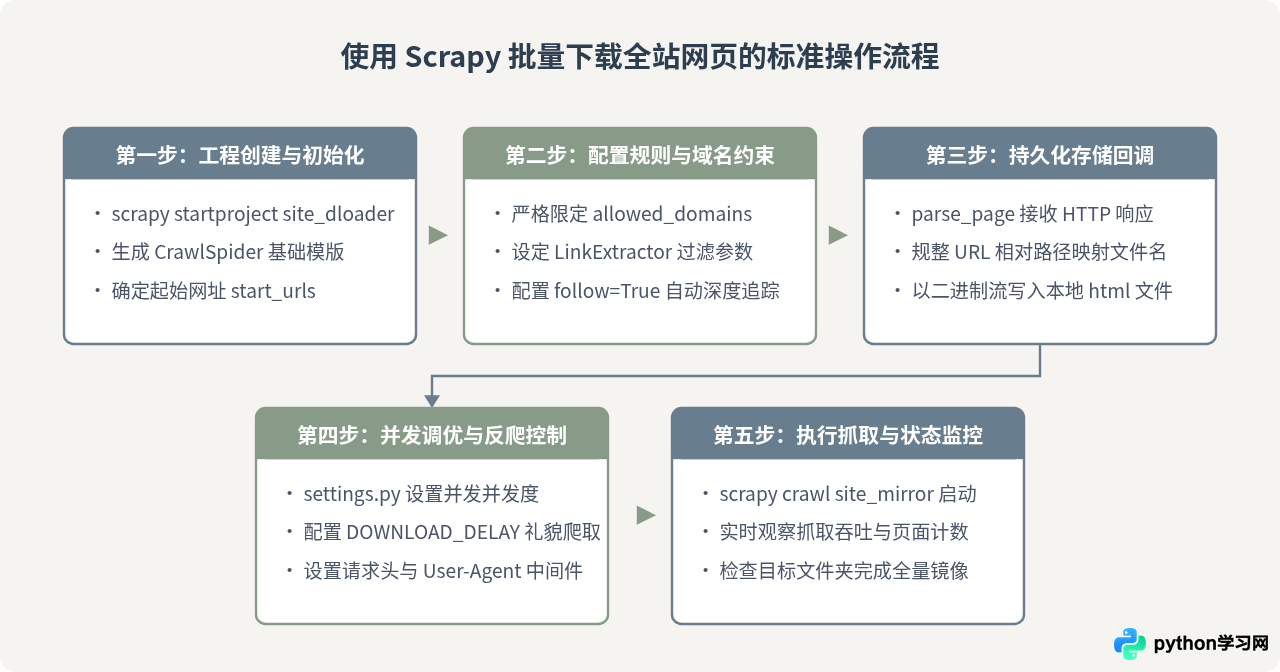
Scrapy 提供了专门用于全站遍历的 CrawlSpider。配合 LinkExtractor(链接提取器),它能够自动从当前响应的 HTML 中抓取符合指定规则的超链接,去重后自动加入抓取队列,直到将整站允许域名下的页面全部抓取完毕。
import os
from urllib.parse import urlparse
import scrapy
from scrapy.spiders import CrawlSpider, Rule
from scrapy.linkextractors import LinkExtractor

class SiteMirrorSpider(CrawlSpider):
    name = "site_mirror"
    allowed_domains = ["example.com"]
    start_urls = ["https://example.com/"]

    # 规则定义:匹配该域名下的所有超链接,follow=True 表示自动递归追踪
    rules = (
        Rule(LinkExtractor(allow=()), callback="parse_page", follow=True),
    )

    def __init__(self, *args, **kwargs):
        super().__init__(*args, **kwargs)
        self.save_dir = "./site_mirror_pages"
        os.makedirs(self.save_dir, exist_ok=True)

    def parse_page(self, response):
        # 根据 URL 路径规整本地文件名
        parsed = urlparse(response.url)
        path = parsed.path.strip("/").replace("/", "_") or "index"
        filename = os.path.join(self.save_dir, f"{path}.html")

        # 将网页原始 HTML 写入文件
        with open(filename, "wb") as f:
            f.write(response.body)

        self.logger.info(f"已持久化页面: {response.url} -> {filename}")
三、关键能力差异深度解析
为什么在全站下载任务中两者体验悬殊?关键在于以下三项核心能力的本质区别:
1. 链接发现与递归能力(Core Crawling)
全站下载的难点不在于“下载”,而在于“发现”。一个现代网站包含导航栏、正文超链接、翻页按钮和底部归档。Scrapy 的 LinkExtractor 能自动从每一个下载好的 HTML 页面中提取符合规则的相对路径和绝对路径,并自动补全协议与域名。而 Python 的 wget 模块只负责接收一个字符串 URL 并拉取文件,不包含 HTML 语法分析器,完全无法自主延伸。
2. 并发性能与异步吞吐量(Throughput)
通常一个小型网站也包含几百到上千个页面,中大型网站更是不计其数。Python wget 库底层使用标准的同步阻塞式 I/O。下载 1000 个页面,若每个页面网络往返及下载耗时 0.5 秒,顺序执行需要耗费 500 秒(超过 8 分钟)。若出现某个页面超时卡死,整体耗时将呈倍数放大。
而 Scrapy 底层基于 Twisted 异步事件循环构建,默认可轻松维持 16 到 32 路异步并发请求。在同等带宽和服务器承受范围内,下载相同数量的网页通常可在十几秒到几十秒内迅速收敛,效率高出几十倍。
3. 状态管理与排重机制(Deduplication)
在递归抓取过程中,网页之间往往存在大量相互指向的循环链接(例如“返回首页”、“相关文章”)。如果没有去重机制,爬虫将陷入无限死循环。
Scrapy 内部的 Scheduler(调度器)采用针对 URL 及请求体计算哈希指纹(Fingerprint)的去重过滤器(RFPDupeFilter)。同一页面只要被抓取过一次,后续无论在多少个子页面被再次链接,都会被调度器自动丢弃。若改用 Python wget,你必须自行在外层维护一个包含数万条哈希记录的集合或 Redis 缓存。
四、批量抓取全站网页的常见陷阱与注意事项
在使用 Scrapy 执行全站下载时,若配置不当可能会遇到一些典型问题,在开发阶段需予以注意:
如果不设置 allowed_domains,爬虫可能会顺着网页中的友情链接或社交分享按钮一路爬取到外部网站(如微博、知乎、GitHub 等),导致抓取范围失控。此外,应在 settings.py 中合理设置 DEPTH_LIMIT,避免遇到日历插件或动态参数形成的无限翻页“爬虫陷阱”。
Scrapy 的异步并发能力极高,若全速运行可能会触发目标网站的 WAF 封禁,甚至对小型网站服务器造成拒绝服务(DoS)。务必在配置中开启自动限速扩展:
AUTOTHROTTLE_ENABLED = True
DOWNLOAD_DELAY = 0.5  # 基础延迟 0.5 秒
CONCURRENT_REQUESTS_PER_DOMAIN = 8 # 针对单域名限制并发数将 HTML 保存到本地后,直接双击打开往往会发现样式丢失。这是因为原网页中的 CSS、JS 和图片多采用形如 /static/css/style.css 的相对根路径。如果目标是构建完整的离线可浏览镜像,需要后续运行脚本重写路径,或者直接使用系统级 GNU wget 命令的 -k(转换链接)与 -p(下载显示所需的页面全部元素)参数。
五、总结:核心维度对比矩阵
综合各项技术指标,两者在面对“批量下载网站所有网页”时的对比汇总如下:
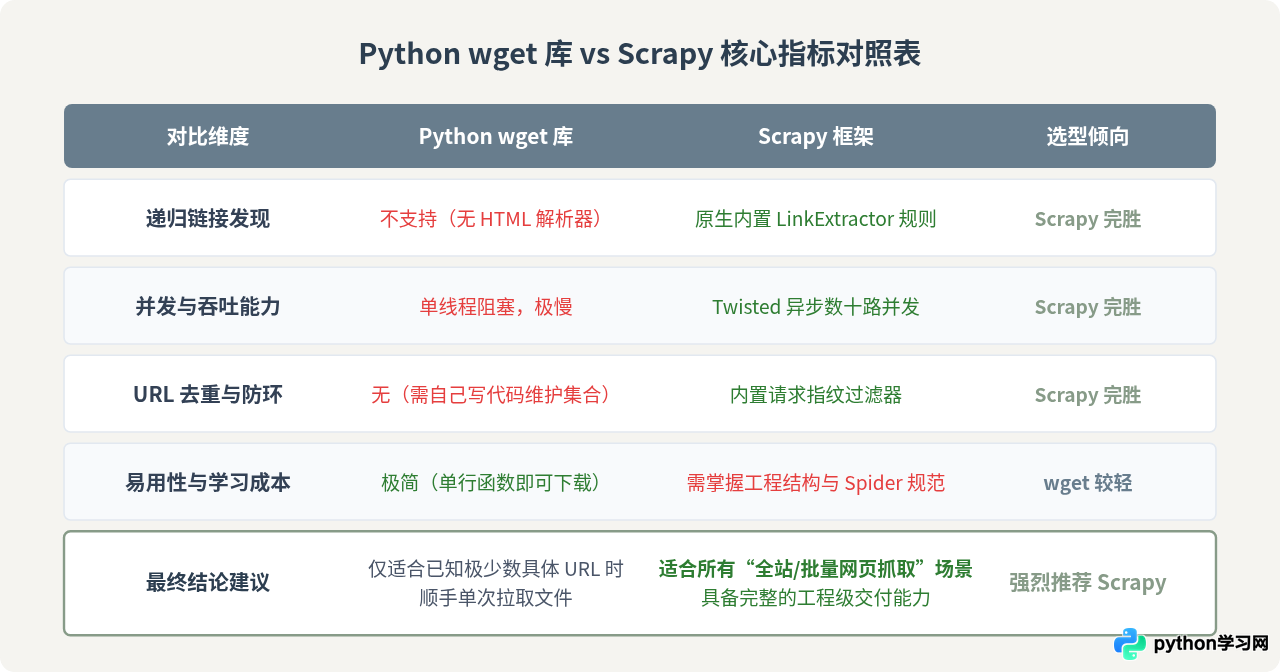
综上所述,当你的需求是下载网站的所有网页时,直接选择 Scrapy 是唯一高效且严谨的工程方案;而 Python 的 wget 模块更适合在开发脚本时替代基础的 urllib.request.urlretrieve,用于简单拉取单一安装包或预先指定好静态地址的资源文件。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









