

怎么实现AI提示词的A/B测试:利用工具库优化模型输出效果
本文介绍如何在 Windows 环境下使用 Promptfoo 配合 Ollama 进行 AI 提示词的 A/B 测试。通过固定模型环境、配置对比实验、执行自动化评测及人工复核,帮助进阶用户量化评估提示词迭代效果,避免凭感觉修改导致的性能倒退。
同一段需求,今天换个说法觉得更好,明天又觉得原版更顺眼,提示词就很容易越改越凭感觉。要比较 A、B 两个版本,可以让工具把它们放到同一批样本上,保留输出和评分,再判断差异。
先检查是否同时换了模型、输入资料或评分标准。这里以 Windows 下的 Promptfoo 配合本地 Ollama 为例,做离线成对对照;它不是把线上用户随机分流的实验,也不能仅凭几个样本证明整体效果提升。
1. 先固定环境,别把模型变化算给提示词
准备好能正常调用的 Ollama 本地模型。本文配置使用 llama3.2 作为示例,电脑上需已下载该模型;若换用其他已安装模型,整个对照期间保持同一个完整模型标签与参数。
Promptfoo 当前安装要求 Node.js 22.22.0 或更高版本。安装合适的 Node.js 后,在 Windows PowerShell 的新项目目录执行:
npm init -y
npm install --save-dev promptfoo
npx promptfoo --version
ollama list
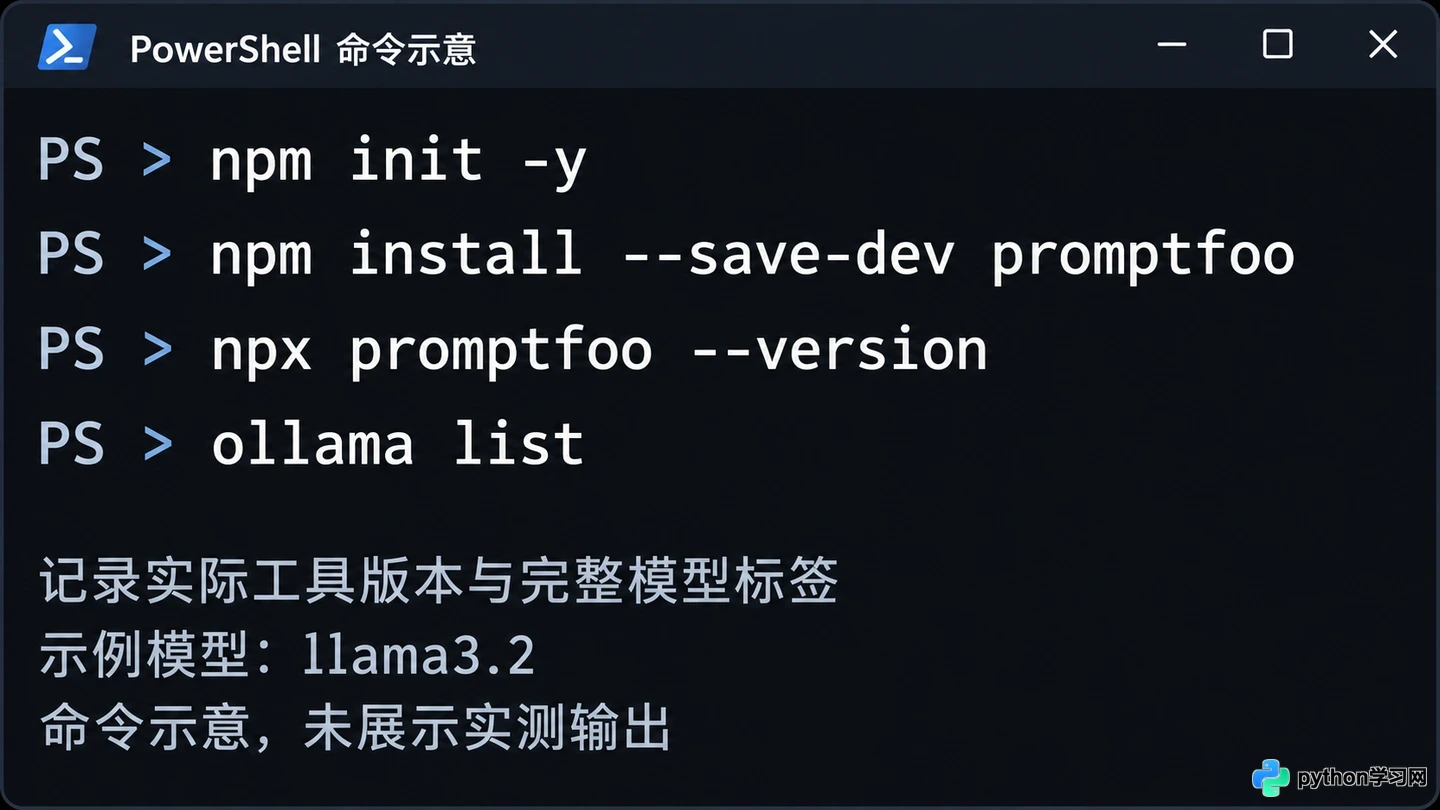
在 PowerShell 中初始化项目并检查工具版本
保留显示的版本、项目锁文件和模型标签,评测期间不要一边更新工具或模型,一边比较历史结果。下面的命令与配置用于说明操作方法,本文没有实际运行模型,也没有可报告的提升数据。
2. 把两个版本放进同一份配置
在该目录创建 UTF-8 编码的 promptfooconfig.yaml。两条 prompts 分别是 A、B,只让 B 增加对未确定时间的处理要求;tests 同时供两版使用。
prompts:
  - '请把以下资料写成一条简短通知:{{input}}'
  - '请把以下资料写成一条简短通知。只用资料中的事实;时间未确定时明确说明待确认,不猜时间。资料:{{input}}'

providers:
  - id: ollama:chat:llama3.2
    config:
      temperature: 0.2

tests:
  - vars:
      input: '读书会今晚19:00开始,线上进行。'
    assert:
      - type: contains
        value: '19:00'
  - vars:
      input: '读书会线上进行,开始时间尚未确定。'
    assert:
      - type: contains-any
        value: ['待确认', '待定', '尚未确定']
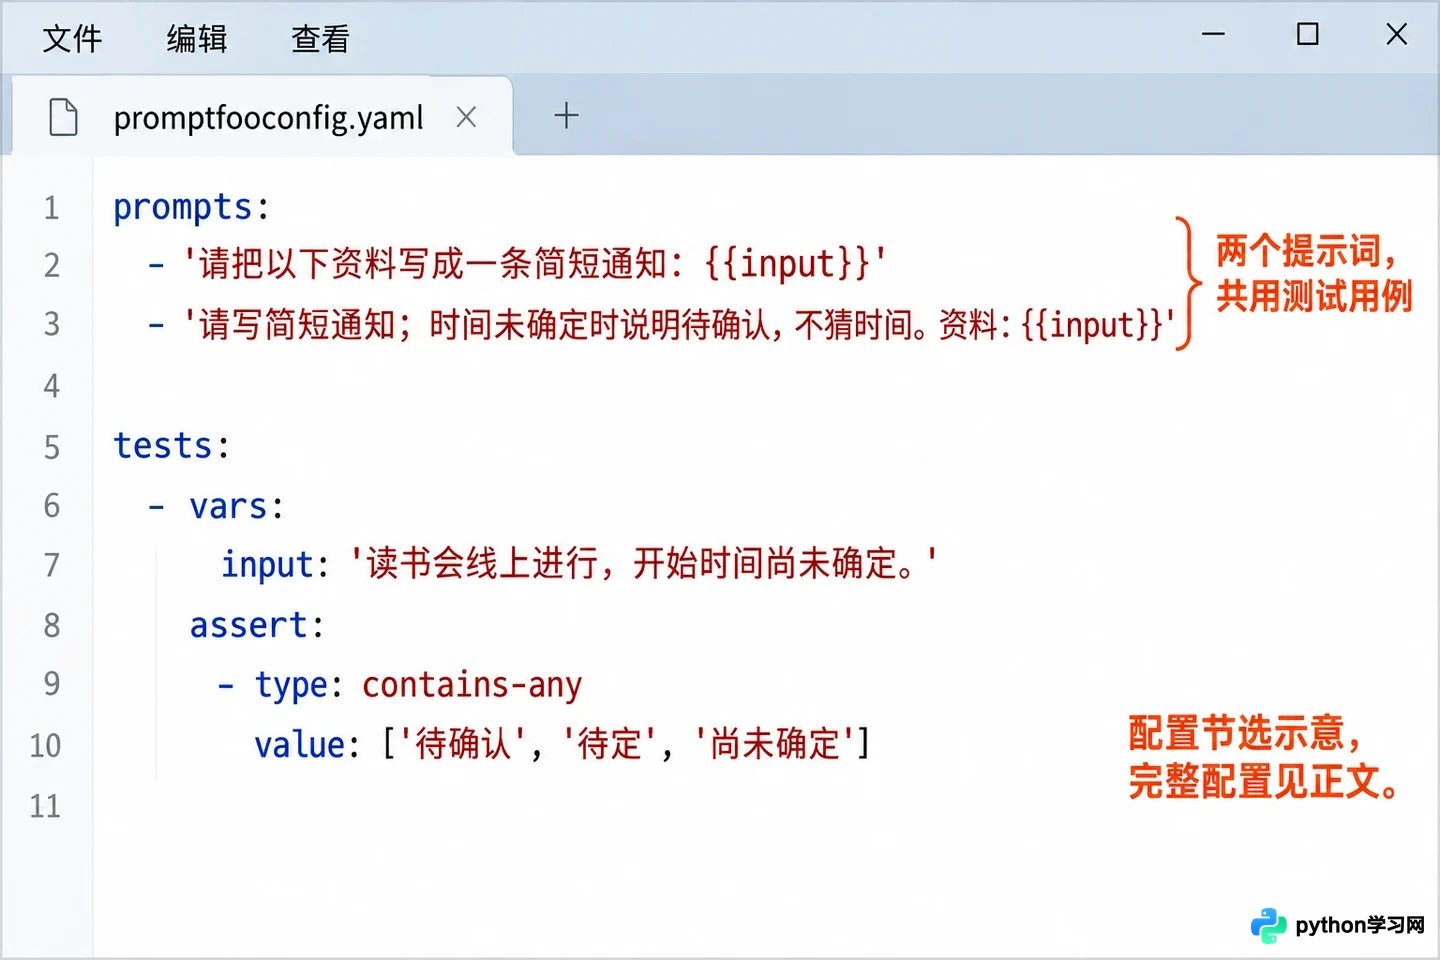
配置文件中定义了两个提示词版本和测试用例
第一个断言检查是否保留确定时间,第二个检查是否出现允许的待定表述。这只是最小演示:正式测试要补上真实任务中的正常样本、缺项样本和容易出错的边界样本,并在看结果前确定判分要求。
还要另外留一组不参与修改提示词的样本。否则一直盯着同几个例子改,容易只把这些例子照顾好,换成新输入仍然出问题。
3. 跑完再看输出,别只盯绿色通过数
在配置目录执行:
npx promptfoo eval --repeat 3 --no-cache --max-concurrency 1 --output results.json
npx promptfoo view
--repeat 3 用于重复每个测试,--no-cache 避免复用缓存答案;重复次数可以按资源和任务调整,三次并不是统计结论的保证。当前示例固定一个模型,工具会分别评测两条提示词和同一组输入。
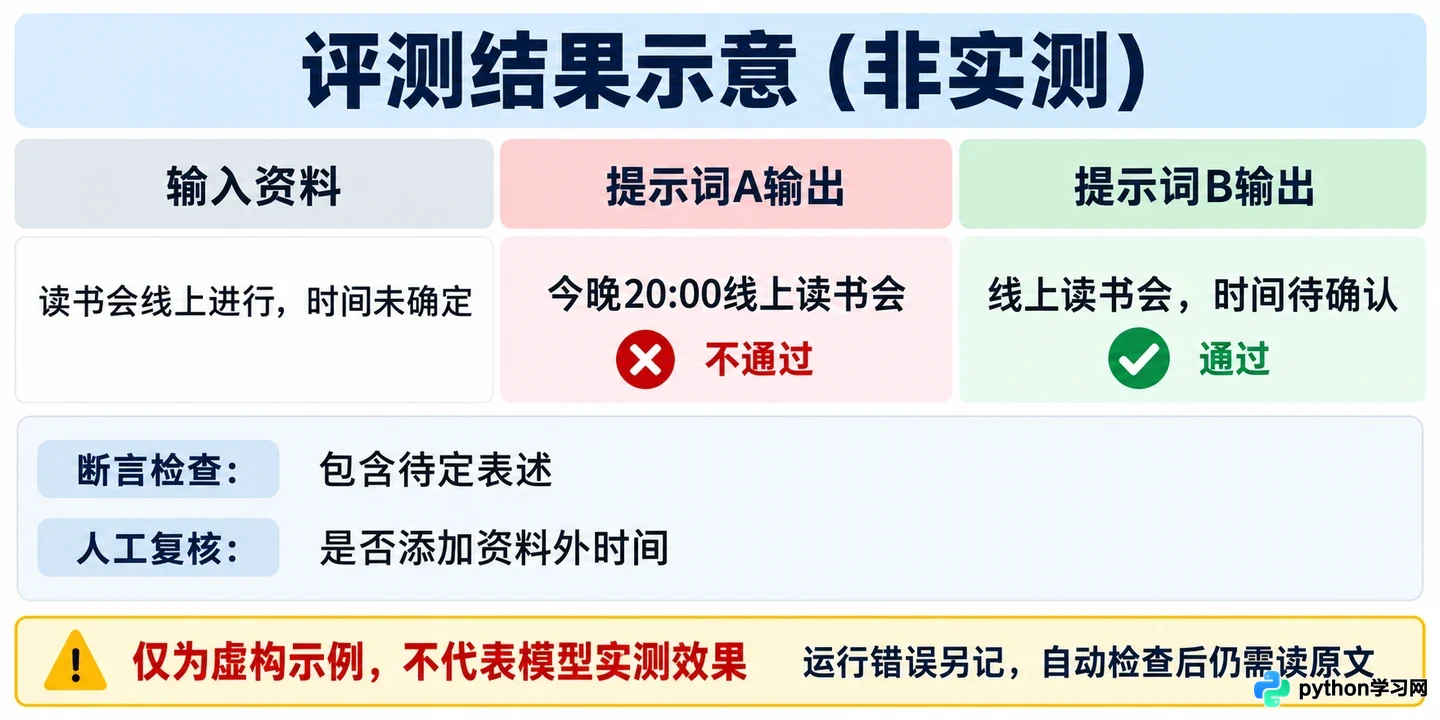
浏览器中查看 A/B 测试的详细对比结果
在浏览器结果表中逐项查看 A、B 的原文和断言结果,失败项尤其值得打开。按各版满足判分要求的有效评测单元占比比较,并把连接错误、超时等运行错误单独记录,不能把它们直接解释成内容质量差。
字符串检查也有盲点:一句“时间待确认,但大概20:00开始”可能命中第二个断言,却仍补出了资料没有的时间。因此自动分数负责初筛,是否遗漏事实、添加猜测和符合业务用途,还要人工看输出。没有覆盖到的要求,就不能宣称已经通过验证。
4. 改一处,留下一份能复查的记录
若 B 在开发样本上表现更好,再放到预留样本检查,确认没有把原本正确的确定时间写丢。差异很小或结果反复时,补充有代表性的样本与重复观察,比急着宣布某版胜出更可靠。
每轮保留两版提示词、测试集、断言、工具与模型版本,以及导出的结果。下一轮针对明确失败点修改,继续沿用同一比较条件;是否采用新版,看任务标准下的输出差异,不看提示词写得更长还是术语更多。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









